3 · 任务-知识格:每个任务到底需要环境的什么#
同一间房,三个任务,三张价签。
波束管理要知道信号从哪个方向来,64 个波束里挑一个,最多 6 比特。切换判决只要知道邻区是不是比本区强,1 比特。中断预测既不要方向,也不要"谁更强",它要的是增益分布的尾巴,也就是一条曲线的最左端。三个任务面对的是同一个环境,同一份信道知识地图。它们从中各取一小块,取的块互不相同,大小相差好几个数量级。
这件事人人都知道,却没有人把"任务需要什么"写成一个数学对象。第 2 章给了"谁更有信息"的语言(Blackwell 序)和"差多少"的数(Le Cam 亏格),但两者都任务无关,对一切任务取最坏,所以常常偏松。同一个亏格 0.08 在 MMSE 任务上松了 8 倍(算例 2.3(d)),粗化一次的亏格 0.5 在波束任务上只兑现了 0.25(算例 2.4)。要把界收紧,就得回答本章标题里的问题:这个任务到底需要环境的哪一部分?
答案落在一个 1953 年就存在的对象上:Shannon 的信息格(lattice of information)[1]。本章把任务映射为格中的元素,称为"任务类充分统计量"。顶元素是第一部 Q1 的"信道看得见的一切",底元素是单个任务的最优动作本身,中间就是任务格。然后用间接率失真(1962 年就有的编码定理)给格里每个元素标上比特价签。
本章预备知识
只需概率论、线性代数与信号与系统的本科内容,以及本部前两章。用到的内容:
- 熵 \(H(\cdot)\)、条件熵、互信息、二元熵函数 \(h(\cdot)\)(预备篇记作 \(H_b\))、率失真函数 \(R(D)\) 的定义:预备篇 4(率失真在 4.9 节)。
- 实验 = 行随机矩阵、garbling = 矩阵相乘、Blackwell 定理(定理 2.1)及其证明里的向量 \(\mathbf{v}_j\) 与凹函数 \(\psi\)、Le Cam 亏格(定义 2.3)、风险界(定理 2.2)、引理 2.3 的三角不等式与两条单调性:第 2 章。
- 链 \(T=\pi\circ\mathcal{D}\circ\mathcal{C}\circ\Phi(\mathcal{E})\) 与两种退化:第 1 章 §1.2–1.3。
- 有效维度 \(d_{\mathrm{eff}}(E;\varepsilon)\) 与环境等价类 \([E]_\varepsilon\):第一部第 8 章。地图是分布泛函 \(m_T(\mathbf{x})=T[P(h\mid\mathbf{x})]\):第一部第 7 章。
预备篇只给了高斯信源的率失真闭式。本章要用的二元对称源闭式 \(R(D)=1-h(D)\),在算例 3.6 第四步就地推出。
**不需要测度论。**文献里的"\(\sigma\)-代数"在本章一律写成"划分"(partition):把观测空间切成若干块,一个统计量就是一种切法。有限情形下两者是同一件事,本章只在备注里点一句对应关系。
3.1 三个任务、三个比特数,与一个陷阱#
先把开头那三张价签算清楚,再指出其中藏着的陷阱。这个陷阱本身就是本章的主定义。
**波束管理。**基站有一个 64 波束的码本,对每个终端位置要选出增益最大的那个。答案是一个索引,\(\log_2 64=6\) 比特。这是个算术事实,不依赖任何标准表格:64 个东西里挑一个,6 比特恰好够用。
**切换判决。**LTE / NR 里同频切换约九成由 A3 事件触发:邻区比本区强出一个门限就切。判决结果只有"切 / 不切",1 比特。
中断预测。问"这个位置在未来一段时间里链路断掉的概率是否超过 \(p\)"。要回答它,必须知道增益的下尾分布,也就是分布函数最左边那一小段。均值和最强方向在这里都不够用。
三个任务,三种知识,三个量级:一条曲线 \(\gg 6\) 比特 \(\gg 1\) 比特。
现在看陷阱。"切换只要 1 比特"这句话成立的前提是门限固定。A3 判决里有两个门限参数:
- 偏置 \(\mathrm{Off}\)(offset)规定邻区至少要强出多少。
- 迟滞 \(\mathrm{Hys}\)(hysteresis)让进入门限与离开门限错开,防止终端在边界附近来回"乒乓"切换。
把 A3 的判决式写出来,其中 \(M_s,M_n\) 为本区与邻区测量值,单位 dB,忽略小区个体偏移:
算例 3.1(切换到底要几比特:门限固定 vs 门限可调)
取 LTE / NR 同频切换中一组常见配置:\(\mathrm{Off}=3\) dB、\(\mathrm{Hys}=1\) dB、触发时延 TTT(time-to-trigger)\(=320\) ms。记增益差 \(\Delta:=M_n-M_s\)。
**门限固定。**进入条件即 \(\Delta>\mathrm{Off}+\mathrm{Hys}=4\) dB,离开条件即 \(\Delta<\mathrm{Off}-\mathrm{Hys}=2\) dB。每个测量周期,判决只需要知道 \(\Delta\) 落在三段中的哪一段:\((-\infty,2)\)、\([2,4]\)、\((4,\infty)\)。三段的熵最多 \(\log_2 3=1.585\) 比特。
之所以是三段而不是两段,原因如下:
- \(\Delta>4\) dB 时一定进入切换态。
- \(\Delta<2\) dB 时一定离开。
- 落在中间的 \([2,4]\) 则维持原状,此时该做什么取决于判决器自己记着的"当前是否已在切换态"。
这一比特记忆是判决器的内部状态,不是环境知识。环境只需告诉它 \(\Delta\) 落在哪一段,输出的动作仍是 1 比特。所以任务需要的环境知识 \(\le 1.585\) 比特。
门限可调。若运营商可能把 \(\mathrm{Off}\) 设在 \(\{0,0.5,\dots,6\}\) dB、\(\mathrm{Hys}\) 设在 \(\{0,0.5,\dots,3\}\) dB,则两个门限 \(\mathrm{Off}\pm\mathrm{Hys}\) 会落在 \([-3,9]\) dB 的 0.5 dB 网格上任何一点。要对所有可能配置都判对,知识必须告诉判决器 \(\Delta\) 落在这些门限切出的哪一段:
- 门限落在 \([-3,9]\) dB 的网格上:共 \((9-(-3))/0.5+1=25\) 个可能的门限,把数轴切成 \(26\) 段,\(\log_2 26=4.70\) 比特。
- 门限落在 \([-15,15]\) dB 的整个 0.5 dB 网格上:\(61\) 个门限、\(62\) 段、\(5.95\) 比特。
同一个"切换",从 1 比特变成了 6 比特。
校验
- (a) 进入与离开门限之差 \(=2\,\mathrm{Hys}=2\) dB,与迟滞带宽度定义一致 ✓。
- (b) 极限:\(\mathrm{Hys}\to0\) 时三段塌成两段(门限 \(\mathrm{Off}\) 一侧一段),\(\log_2 2=1\) 比特,回到"1 比特"的朴素说法 ✓。
- (c) 门限数复算:\(61=30/0.5+1\)、\(25=12/0.5+1\) ✓。\(k\) 个门限切出 \(k+1\) 段,与固定门限时 2 个门限切出 3 段是同一个数法 ✓。\(2^{4.70}=26.0\)、\(\log_2 62=5.954\) ✓。
- (d) TTT 的作用是要求进入条件在 320 ms 窗口内持续成立。它把"一段"变成"一段序列",每周期的知识需求不变,只是要连续几个周期都拿到 ✓。
陷阱说清楚了:任务需要多少知识,取决于你要同时应付多宽的一族任务。固定门限的切换是一个任务,"所有门限的切换"是一个任务类(task class)。任务类越宽,所需知识越细。
本章讲的就是这件事。下面把它变成定义、命题、猜想和一条编码定理。
到此为止我们得到了什么
三张价签(曲线 / 6 比特 / 1 比特)和一个反转它们的旋钮。价签不贴在任务上,贴在任务类上。旋钮是任务类的宽度。
3.2 "够用"的精确含义:任务类充分统计量#
直觉
一份体检报告有几十项指标。要判断"能不能献血",只看血红蛋白和几项传染病标记就够了,这几项对这个问题是"够用的摘要"。要判断"能不能跑马拉松",要看的是另一组指标。要应付"医生可能问的一切问题",就得留下整份报告。
"够用"永远是相对于一组问题说的。统计学把"对一切问题都够用"叫充分统计量(sufficient statistic)。本章要的是"对某一类问题够用"。
3.2.1 记号:把第 2 章的向量再用一次#
设实验 \(\mathcal{E}\) 的矩阵为 \(\mathbf{P}\)(\(m\times n\),行是状态 \(\theta_i\),列是观测 \(y_j\),定义 2.1)。一个统计量(statistic)是一个函数 \(S:\mathcal{Y}\to\mathcal{S}\)。它把观测空间切成若干块 \(C_s:=\{j:S(y_j)=s\}\),这些块合起来就是 \(\mathcal{Y}\) 的一个划分。
"只看 \(S\)"等价于把 \(\mathcal{E}\) 过一道 0/1 的行随机矩阵 \(\mathbf{K}_S[j,s]=\mathbf{1}[S(y_j)=s]\),得到实验 \(S\circ\mathcal{E}\),矩阵为 \(\mathbf{P}\mathbf{K}_S\)。由定义 2.2,永远有 \(\mathcal{E}\succeq S\circ\mathcal{E}\)。
一个决策问题(decision problem)记作 \(T=(A_T,L_T,\pi_T)\):动作集、损失、先验。先验写进任务里是本章特意的选择。§3.1 的陷阱说明"够用"既依赖损失也依赖先验。给定先验,沿用定理 2.1 证明中的记号:
\(\mathbf{v}_j\) 是"状态且观测到 \(y_j\)"的联合概率向量,\(\psi_T\) 是"手握这份未归一化后验时最好动作的损失"。定理 2.1 证明的第四步给出
第二个式子只是说:只看 \(S\) 时,同一块里的观测被合并,联合概率向量相加。
再记 \(\mathrm{Opt}_T(\mathbf{v}):=\arg\min_{a}\sum_i v_iL_T(\theta_i,a)\) 为在 \(\mathbf{v}\) 处最优动作的集合(可能不止一个)。
3.2.2 任务类充分统计量的定义与算例#
定义 3.1(任务类、任务类充分统计量、任务限制亏格)【经典工具·本站用于任务类】
(a) 一个任务类(task class)\(\mathcal{T}\) 是决策问题 \(T=(A_T,L_T,\pi_T)\) 的任意集合。若 \(\mathcal{T}\) 与某个 \((A,L)\) 一起包含了所有先验 \(\pi\),称 \(\mathcal{T}\) 对 \((A,L)\) 先验封闭。
(b) 统计量 \(S\) 对任务类 \(\mathcal{T}\) 充分(\(\mathcal{T}\)-sufficient),若
即:对这一类里的每个问题,只看 \(S\) 与看全部观测的 Bayes 风险相等。
(c) 对同一 \(\Theta\) 上的实验 \(\mathcal{F},\mathcal{E}\),任务限制亏格(task-restricted deficiency)
读作"用 \(\mathcal{F}\) 在任务类 \(\mathcal{T}\) 上模拟 \(\mathcal{E}\) 差多少"。当 \(\mathcal{T}\) 取"动作数 \(\le k\) 的一切问题"时,它就是 Torgersen 的 \(k\)-亏格 \(\delta_k\) [8]。
由定理 2.2 立得 \(\delta_{\mathcal{T}}\le\delta\)。把定理 2.2 里 \(\mathcal{E}\)、\(\mathcal{F}\) 的角色互换,它说损失在 \([0,1]\) 时,\(\epsilon=\delta(\mathcal{F},\mathcal{E})\) 对一切任务都满足花括号里的条件,当然也对 \(\mathcal{T}\) 里的任务满足,而下确界不超过任何一个可行值。
\(\mathcal{T}\) 越宽,花括号里要满足的条件越多,可行的 \(\epsilon\) 越少,\(\delta_{\mathcal{T}}\) 越大。
**产权。**限制决策类的亏格是 Torgersen 1991 [8] 的现成工具。"收缩决策问题类 \(\Rightarrow\) 更粗的等价关系"这一层级,在 2025 年的一份预印本里被写成严格包含链(Le Cam 失真 ⊃ 似然失真 ⊃ 似然比失真 ⊃ 充分性,Akdemir [20] 定理 3.7【预印本·未评审】)。本站在此没有新定义,新意只在下一节把它与 Shannon 信息格配对。
先用一个 \(2\times3\) 的例子看"够用"怎么随任务类改变。
算例 3.2(BEC 上的一个统计量,对三个任务类各是否够用)
实验取算例 2.2 的 BEC(0.6):\(\theta\in\{+1,-1\}\),观测 \(\{+1,\mathrm{e},-1\}\)。统计量 \(S\) 把 \(\{+1,\mathrm{e}\}\) 合成一块"非负",\(\{-1\}\) 单独一块。问:\(S\) 对下面三个任务类够不够用?
任务类一:0-1 判决、等概先验。\(\pi=(1/2,1/2)\),联合概率向量(分量顺序 \((\theta=+1,\theta=-1)\)):\(\mathbf{v}_{+1}=(0.2,0)\)、\(\mathbf{v}_{\mathrm{e}}=(0.3,0.3)\)、\(\mathbf{v}_{-1}=(0,0.2)\)。
- 全观测:\(\psi(\mathbf{v}_{+1})=0\)(报 \(+1\))、\(\psi(\mathbf{v}_{\mathrm{e}})=0.3\)(怎么报都错 0.3)、\(\psi(\mathbf{v}_{-1})=0\),合计 \(0.30\),与算例 2.2 的 \(\epsilon/2=0.30\) 一致。
- 只看 \(S\):块 \(\{+1,\mathrm{e}\}\) 的 \(\mathbf{w}=(0.5,0.3)\),报 \(+1\) 损失 \(0.3\)、报 \(-1\) 损失 \(0.5\),取 \(0.3\)。块 \(\{-1\}\) 损失 0。合计 \(0.30\)。
两条路径相等,够用。
这里有三个 \(\epsilon\) 要分清:算例 2.2 里 \(\epsilon=0.6\) 是 BEC 的擦除概率;定义 3.1(c) 里的 \(\epsilon\) 是模拟误差的容许量;\([E]_\varepsilon\)、\(d_{\mathrm{eff}}(E;\varepsilon)\) 里的 \(\varepsilon\) 是分辨精度。三者无关。
任务类二:0-1 判决、先验 \(\pi(+1)=0.3\)。
- 全观测:只有擦除时会错,风险 \(=0.6\times\min\{0.3,0.7\}=0.18\)。
- 只看 \(S\):块 \(\{+1,\mathrm{e}\}\) 的 \(\mathbf{w}=(0.4\times0.3+0.6\times0.3,\ 0.6\times0.7)=(0.30,0.42)\),报 \(+1\) 损失 \(0.42\)、报 \(-1\) 损失 \(0.30\),取 \(0.30\)。块 \(\{-1\}\) 损失 0。合计 \(0.30>0.18\)。
结论:不够用。把 \(+1\) 与擦除合并后,先验偏向 \(-1\) 时整块都被判成 \(-1\),把本来判对的 \(+1\) 也拖下水。
**任务类三:三档估计、等概先验。**动作 \(a\in\{+1,0,-1\}\),损失 \(L=(\theta-a)^2/4\in[0,1]\)。
- 全观测:看到 \(\pm1\) 报 \(\pm1\) 损失 0,看到 \(\mathrm{e}\) 报 0 损失 \(1/4\),风险 \(0.6\times0.25=0.15\)(与算例 2.3(d) 的 \(0.15\) 一致)。
- 只看 \(S\):块 \(\{+1,\mathrm{e}\}\),\(\mathbf{w}=(0.5,0.3)\)。报 \(+1\) 损失 \(0.3\times1=0.30\),报 \(0\) 损失 \(0.8\times0.25=0.20\),报 \(-1\) 损失 \(0.5\times1=0.50\),取 \(0.20\)。块 \(\{-1\}\) 损失 0。合计 \(0.20>0.15\)。
结论:不够用。
校验
- (a) 任务类一的两条路径都给 \(0.30\),且等于闭式 \(\epsilon/2\) ✓。
- (b) 任务类二在 \(\pi(+1)\to1/2\) 时全观测风险 \(\to0.30\)、只看 \(S\) 的风险 \(\to0.30\),两者在等概处重新相等,与任务类一衔接 ✓。
- (c) 任务类三中 \(\mathbf{w}\) 的总质量 \(0.8=1-\Pr\{y=-1\}=1-0.2\) ✓。
- (d) 三个结论与下面引理 3.1 的判据 (iii) 逐一吻合:
- 任务类一里块 \(\{+1,\mathrm{e}\}\) 上 \(\mathrm{Opt}(\mathbf{v}_{+1})=\{+1\}\)、\(\mathrm{Opt}(\mathbf{v}_{\mathrm{e}})=\{+1,-1\}\),有公共最优动作 \(+1\)。
- 任务类二里 \(\mathrm{Opt}(\mathbf{v}_{\mathrm{e}})=\{-1\}\),没有公共动作。
- 任务类三里 \(\mathrm{Opt}(\mathbf{v}_{+1})=\{+1\}\)、\(\mathrm{Opt}(\mathbf{v}_{\mathrm{e}})=\{0\}\),没有公共动作 ✓。
3.2.3 引理 3.1:三种等价说法及证明#
同一个 \(S\),对一类够用、对另两类不够用。"够用"的判据到底是什么?下面这条引理给出三种说法,并证明它们是一回事。
引理 3.1(任务类充分性的三种说法)【已解决(经典骨架)·本站给有限情形完整证明】
设 \(S\) 是有限实验 \(\mathcal{E}\) 上的统计量,\(\mathcal{T}\) 是任务类。考虑:
(i)(风险) \(r_T(S\circ\mathcal{E})=r_T(\mathcal{E})\) 对每个 \(T\in\mathcal{T}\);
(ii)(模拟) \(\delta_{\mathcal{T}}(S\circ\mathcal{E},\mathcal{E})=0\);
(iii)(公共最优动作) 对每个 \(T\in\mathcal{T}\) 与 \(S\) 的每一块 \(C_s\),存在一个动作对块内所有观测都最优:\(\bigcap_{j\in C_s}\mathrm{Opt}_T(\mathbf{v}_j)\neq\varnothing\)。
则 (i)\(\iff\)(iii) 对任意 \(\mathcal{T}\) 成立;(ii)\(\Rightarrow\)(i) 对任意 \(\mathcal{T}\) 成立;若 \(\mathcal{T}\) 对其包含的每个 \((A,L)\) 先验封闭,则 (i)\(\Rightarrow\)(ii),三者等价。
证明。
**第一步:把等号落到每一块上,证 (i)\(\iff\)(iii)。**定理 2.1 证明的第三步给出 \(\psi_T\) 的超可加性:\(\psi_T(\mathbf{u}+\mathbf{u}')\ge\psi_T(\mathbf{u})+\psi_T(\mathbf{u}')\)。对一块 \(C_s\) 反复使用,得
*这一步说:合并观测只会让损失变大或不变,每块各自如此。*对 \(s\) 求和即 \(r_T(S\circ\mathcal{E})\ge r_T(\mathcal{E})\)(这就是定理 2.1 的 (i)\(\Rightarrow\)(ii) 在本例的样子)。于是 (i) 成立当且仅当每一块的不等式都取等。
现在看一块何时取等。取 \(a^\star\in\mathrm{Opt}_T(\mathbf{w}_s)\),记 \(\mathbf{v}\cdot L_a:=\sum_iv_iL_T(\theta_i,a)\)。则
*中间的不等号是逐项的:每一项 \(\mathbf{v}_j\cdot L_{a^\star}\ge\min_a\mathbf{v}_j\cdot L_a\)。*一串逐项不等式的和取等,当且仅当每一项取等,即 \(a^\star\in\mathrm{Opt}_T(\mathbf{v}_j)\) 对块内每个 \(j\) 成立,这就是 (iii)。
反过来,若有公共最优动作 \(a\),则 \(\psi_T(\mathbf{w}_s)\le\mathbf{w}_s\cdot L_a=\sum_j\mathbf{v}_j\cdot L_a=\sum_j\psi_T(\mathbf{v}_j)\le\psi_T(\mathbf{w}_s)\),两头夹住,取等。\(\square\)
**第二步:证 (ii)\(\Rightarrow\)(i)。**取 \(\rho\) 为 \(\mathcal{E}\) 在 \(T\) 下的 Bayes 最优规则。(ii) 给出 \(S\circ\mathcal{E}\) 上的 \(\rho'\),在每个 \(\theta\) 处风险不超过 \(\rho\),对先验 \(\pi_T\) 取期望得 \(r_T(S\circ\mathcal{E})\le r_T(\mathcal{E})\)。反向不等式已在第一步得到。\(\square\)
**第三步:先验封闭时证 (i)\(\Rightarrow\)(ii),用一次分离超平面。**固定 \(T\in\mathcal{T}\)(\(L_T\in[0,1]\))与 \(\mathcal{E}\) 上任一(可随机化的)规则 \(\rho\),记其风险向量 \(\mathbf{u}=(R_{\mathcal{E}}(\theta_i,\rho))_i\in\mathbb{R}^m\)。令 \(\mathcal{R}\subset\mathbb{R}^m\) 为 \(S\circ\mathcal{E}\) 上一切随机化规则的风险向量集合。
一个随机化规则是 \(|\mathcal{S}|\times|A_T|\) 的行随机矩阵,风险向量是它的线性函数。行随机矩阵集是单纯形的乘积,紧且凸。线性像保持紧与凸,故 \(\mathcal{R}\) 是紧凸集。这一步与定理 2.1 (ii)\(\Rightarrow\)(i) 证明的第一步是同一句话。
令 \(\mathcal{K}:=\mathcal{R}+\mathbb{R}^m_{\ge0}\)("某个规则的风险向量再加任意非负量"),它是闭凸集。若 \(\mathbf{u}\in\mathcal{K}\),则存在 \(S\circ\mathcal{E}\) 上的规则逐点风险 \(\le\mathbf{u}\),这就是 (ii) 中 \(\epsilon=0\) 的要求。故只需证 \(\mathbf{u}\in\mathcal{K}\)。
反证:设 \(\mathbf{u}\notin\mathcal{K}\)。分离超平面定理给出 \(\boldsymbol{\lambda}\in\mathbb{R}^m\) 与常数 \(c\),使
因 \(\mathbf{w}+t\mathbf{e}_i\in\mathcal{K}\) 对一切 \(t\ge0\) 成立,若某个 \(\lambda_i<0\),令 \(t\to\infty\) 右端会趋于 \(-\infty\),矛盾。故 \(\boldsymbol{\lambda}\ge0\)。又 \(\boldsymbol{\lambda}\ne\mathbf{0}\)(否则 \(0<c\le0\))。于是 \(\pi:=\boldsymbol{\lambda}/\sum_i\lambda_i\) 是一个先验。这一步把分离超平面的法向量翻译成了一个先验,与定理 2.1 证明里把 \(\Lambda\) 翻译成损失是同一种手法。
两边同除 \(\sum_i\lambda_i>0\),记 \(c':=c/\sum_i\lambda_i\),分离不等式变成 \(\pi\cdot\mathbf{u}<c'\le\pi\cdot\mathbf{w}\) 对一切 \(\mathbf{w}\in\mathcal{K}\) 成立。\(\mathcal{R}\subseteq\mathcal{K}\)(非负量取零),所以对一切 \(\mathbf{w}\in\mathcal{R}\) 也成立。于是
最左边的等号是"Bayes 风险 = 最好规则的先验加权风险"(\(\mathcal{R}\) 紧故最小值可取到),最右边的不等号是"Bayes 风险不超过任何具体规则 \(\rho\) 的加权风险"。由先验封闭,\((A_T,L_T,\pi)\in\mathcal{T}\),上式与 (i) 矛盾。故 \(\mathbf{u}\in\mathcal{K}\),(ii) 成立。\(\blacksquare\)
物理意义
三种说法对应三种工程直觉:
- (i) 是性能:换成摘要后任务不变差。
- (iii) 是结构:摘要把观测切成块,每块里的观测本来就要做同一个动作,所以合并它们不损失任何东西。这是"够用"最直白的样子。
- (ii) 是可模拟:拿着摘要的人,能在这一类任务上完全冒充拿着全观测的人。
行为分析
- 损失函数进入判据的方式只有一种。(iii) 说明充分性完全由"最优动作在哪些观测上相同"决定,损失函数只通过它诱导的最优动作划分起作用。两个损失若处处给出同样的最优动作,它们对充分性的要求一模一样。
- **先验封闭是 (i)\(\Rightarrow\)(ii) 的真前提。**算例 3.2 的 \(S\) 对"等概 0-1 判决"够用,却不对"先验 0.3 的 0-1 判决"够用。所以它对 \(\{\)等概 0-1 判决\(\}\) 这个单点任务类满足 (i) 但不满足 (ii)。
原因是 (ii) 逐个 \(\theta\) 比风险,先验不参与。取全观测上"看到 \(+1\) 报 \(+1\),看到 \(\mathrm{e}\) 或 \(-1\) 报 \(-1\)"的规则(正是先验 0.3 时的 Bayes 规则),风险为 \(R(+1)=0.6\)、\(R(-1)=0\)。只看 \(S\) 的规则若要 \(R(-1)=0\),就必须在两块上都报 \(-1\),于是 \(R(+1)=1>0.6\)。没有哪个只看 \(S\) 的规则能逐点不差于它,所以 \(\delta_{\mathcal{T}}>0\)。
- **把 \(\mathcal{T}\) 推到两端。**下面两种极端的任务类,各有一个经典答案。
一端:\(\mathcal{T}=\) 一切决策问题
(iii) 对一切损失、一切先验成立,等价于 \(S\circ\mathcal{E}\succeq\mathcal{E}\)(定理 2.1 (ii)\(\Rightarrow\)(i)),即经典的 Blackwell 充分性。
有限情形下最粗的充分划分是"按归一化似然向量分块":令 \(\boldsymbol{\ell}(y_j):=\bigl(\mathbf{P}[i,j]\bigr)_i/\sum_i\mathbf{P}[i,j]\),把 \(\boldsymbol{\ell}\) 相同的观测放进同一块,记为 \(M_{\mathrm{all}}\)。
它充分,因为 \(\mathbf{v}_j=\bigl(\sum_i\mathbf{P}[i,j]\bigr)\cdot\bigl(\pi_i\ell_i(y_j)\bigr)_i\) 是同一向量的正倍数,而 \(\mathrm{Opt}_T\) 对正倍数不变,同块内最优动作集合相同。
它最粗,因为两个观测若 \(\boldsymbol{\ell}\) 不同,必有某对状态 \((\theta_i,\theta_{i'})\) 的似然比不同。取只支撑在这两个状态上的先验与 0-1 损失,可让二元检验在这两个观测处给出不同的唯一最优动作,于是任何把它们合在一块的划分都违反 (iii)。
这是 Bahadur 1954 [2] 最小充分统计量在有限情形的样子【已解决(经典)·本站演算】。
一般测度空间上情况复杂得多。最小充分统计量的存在要靠被支配族这类条件。常用的"似然比等值类"判据是:两个观测点的似然之比与 \(\theta\) 无关就归为一类。这个判据一般并不成立:arXiv:2603.10288【预印本·未评审】利用 Radon–Nikodym 导数版本不唯一构造了反例,并指出 Sato 1996 给出的使它成立的正则条件往往难以验证。本站只用有限情形【表述待核:被支配族条件的出处(Bahadur 1954 [2])本站未读到原文】。
另一端:\(\mathcal{T}=\) 单个固定问题 \((A,L,\pi)\),且每个正概率观测处最优动作唯一
(iii) 化为"每块上 \(a^\star\) 取常值",故最粗的充分划分就是按最优动作分块:\(y\mapsto a^\star(y)\) 的水平集。这是本章的任务地板(task floor)。
文献里的严格版本是 Sevetlidis 2026 [21] 的"贝叶斯充分 / 贝叶斯极小"表示(定义 \(\mathcal{I}_{\ell,P}=\sigma(a^\star)\),定理 3.2 给出与"最优动作可测"的等价)【预印本·未评审】。最优动作不唯一时退化为"块上存在公共最优动作",即引理 3.1 的 (iii)(同文命题 A.2)。本站不主张这一层的原创。
到此为止我们得到了什么
一个精确的"够用"。统计量对任务类充分,当且仅当它的每一块上有一个公共最优动作。先验封闭时,又当且仅当任务限制亏格为零。
两端各有一个经典答案:一切任务 \(\Rightarrow\) 似然划分,单个任务 \(\Rightarrow\) 最优动作划分。中间那一大段,需要一个能放下"所有划分"的容器。
3.3 划分的格:Shannon 1953 的信息格#
3.3.1 划分、粗细、交与并#
直觉
把一个班的学生分组,有很多种分法:按性别分两组,按宿舍分十组,按"性别 + 宿舍"分二十组。第三种分法比前两种都细,知道了第三种,前两种自动知道。
反过来,"按性别"和"按宿舍"有没有一个共同能推出的更粗分法?有,至少"全班一组"这个平凡分法总能推出。
Shannon 1953 [1] 把"知道一件事"定义成"能把样本空间切到多细",并证明所有切法在"细 / 粗"关系下构成一个格(lattice):任意两种切法都有最细的公共粗化与最粗的公共细化。
定义 3.2(划分、粗细、交与并)【已解决(经典)】
有限集 \(\mathcal{Y}\) 的一个划分(partition)是一族两两不交、并为 \(\mathcal{Y}\) 的非空子集(块)。任何统计量 \(S\) 给出划分 \(\{C_s\}\);反之任何划分都是某个统计量的块。
**粗细。**记 \(\mathcal{S}\preceq\mathcal{S}'\)("\(\mathcal{S}'\) 至少与 \(\mathcal{S}\) 一样细 / 一样有信息"),若 \(\mathcal{S}'\) 的每一块都包含在 \(\mathcal{S}\) 的某一块里;等价地,\(\mathcal{S}\) 是 \(\mathcal{S}'\) 的函数(\(S=f\circ S'\))。
交(meet)\(\mathcal{S}\wedge\mathcal{S}'\):最细的公共粗化,即所有既粗于 \(\mathcal{S}\) 又粗于 \(\mathcal{S}'\) 的划分中最细的那个。构造:把 \(\mathcal{S}\) 的块与 \(\mathcal{S}'\) 的块画成二部图,两块相交就连边;每个连通分量所覆盖的元素构成交的一块。
并(join)\(\mathcal{S}\vee\mathcal{S}'\):最粗的公共细化,即所有既细于 \(\mathcal{S}\) 又细于 \(\mathcal{S}'\) 的划分中最粗的那个。构造:块为所有非空的 \(C\cap C'\)(\(C\in\mathcal{S}\),\(C'\in\mathcal{S}'\))。
顶与底。\(\top\) = 每个元素自成一块("什么都分得清");\(\bot\) = 全体一块("什么都分不清")。
Shannon 1953 的定理。\(\mathcal{Y}\) 上全体划分在 \(\preceq\) 下构成完全格:任意一族划分都有交与并。出处:[1],原文用"等价关系"与"信息元素"的说法。有限情形下等价关系即划分,本站据此改写。
为什么构造是对的(两句话证明)
- **并。**任何同时细于 \(\mathcal{S},\mathcal{S}'\) 的划分,每块必落在某个 \(C\) 内又落在某个 \(C'\) 内,故落在 \(C\cap C'\) 内,所以 \(\{C\cap C'\}\) 是最粗的。
- **交。**任何同时粗于 \(\mathcal{S},\mathcal{S}'\) 的划分,只要两块 \(C,C'\) 相交就必须把它们放进同一块,否则它既不粗于 \(\mathcal{S}\) 也不粗于 \(\mathcal{S}'\)。沿着相交关系传递下去,整个连通分量必在同一块。而"连通分量"本身确实粗于两者,故它是最细的。\(\square\)
一个交不平凡的小例子
取 \(\mathcal{Y}=\{1,2,3,4\}\),\(\mathcal{S}=\{\{1,2\},\{3\},\{4\}\}\),\(\mathcal{S}'=\{\{1\},\{2,3\},\{4\}\}\)。
- 并:两两求交,非空的是 \(\{1\},\{2\},\{3\},\{4\}\),所以 \(\mathcal{S}\vee\mathcal{S}'=\top\),两份知识合起来什么都分得清。
- 交:\(\{1,2\}\) 与 \(\{2,3\}\) 共有元素 2,\(\{2,3\}\) 与 \(\{3\}\) 共有元素 3,于是 \(1,2,3\) 连成一个分量。\(\{4\}\) 只与 \(\{4\}\) 相连,自成一块。所以 \(\mathcal{S}\wedge\mathcal{S}'=\{\{1,2,3\},\{4\}\}\):两边都能回答的问题只有"是不是 4"。
名字别看反
交与并是按"信息"起的名。并是两份知识合起来,划分更细,它的块反而是集合的交 \(C\cap C'\)。交是两份知识的公共部分,划分更粗,它的块是若干块拼成的更大集合。换成下面备注里的 \(\sigma\)-代数说法,交与并就和集合运算同向了。
3.3.2 算例:四格房间,以及与公共信息的关系#
算例 3.3(四格房间:两个任务的划分、它们的交与并)
服务区分成四个格 \(\theta\in\{1,2,3,4\}\),先验均匀。这是本章贯穿的玩具:知识就是"知道 \(\theta\) 落在哪一块",实验矩阵是单位阵 \(\mathbf{I}_4\)(沿用算例 2.4 的设定),于是 \(\mathbf{v}_j=\tfrac14\mathbf{e}_j\),划分就是划分 \(\Theta\) 本身。两个波束 \(b_1,b_2\) 在四格的增益(dB):
| 格 | \(b_1\) | \(b_2\) | 最优波束 | 最优增益 | 最优增益 \(\ge7\) dB? |
|---|---|---|---|---|---|
| 1 | 10 | 0 | \(b_1\) | 10 | 是 |
| 2 | 8 | 2 | \(b_1\) | 8 | 是 |
| 3 | 6 | 5 | \(b_1\) | 6 | 否 |
| 4 | \(-2\) | 9 | \(b_2\) | 9 | 是 |
- **任务 B(选波束,0-1 损失)**的最优动作划分:\(\mathcal{S}_B=\{\{1,2,3\},\{4\}\}\)。
- **任务 M(能否用高阶 MCS:最优增益是否 \(\ge7\) dB,0-1 损失)**的最优动作划分:\(\mathcal{S}_M=\{\{1,2,4\},\{3\}\}\)。
并:非空交集 \(\{1,2,3\}\cap\{1,2,4\}=\{1,2\}\)、\(\{1,2,3\}\cap\{3\}=\{3\}\)、\(\{4\}\cap\{1,2,4\}=\{4\}\),故 \(\mathcal{S}_B\vee\mathcal{S}_M=\{\{1,2\},\{3\},\{4\}\}\)。同时做两个任务需要分清三种情况。
交:块 \(\{1,2,3\}\) 与 \(\{1,2,4\}\) 相交、与 \(\{3\}\) 相交;\(\{4\}\) 与 \(\{1,2,4\}\) 相交;二部图连通,故 \(\mathcal{S}_B\wedge\mathcal{S}_M=\{\{1,2,3,4\}\}=\bot\)。两个任务没有任何公共知识:知道该选哪个波束,对"能不能上高阶 MCS"一无所知,反之亦然。
熵。\(H(\mathcal{S}_B)=H(\mathcal{S}_M)=h(1/4)=0.811\) 比特,\(H(\mathcal{S}_B\vee\mathcal{S}_M)=H(\tfrac12,\tfrac14,\tfrac14)=1.5\) 比特,\(H(\top)=2\) 比特,\(H(\bot)=0\)。
再看 \(\mathcal{S}_M\) 对任务 B 够不够用(引理 3.1 (iii)):块 \(\{1,2,4\}\) 里格 1、2 要 \(b_1\),格 4 要 \(b_2\),没有公共最优动作 \(\Rightarrow\) 不够用。风险计算如下:
- 块 \(\{1,2,4\}\) 的 \(\mathbf{w}=(\tfrac14,\tfrac14,0,\tfrac14)\),选 \(b_1\) 损失 \(\tfrac14\)(格 4 错),选 \(b_2\) 损失 \(\tfrac12\),取 \(\tfrac14\)。
- 块 \(\{3\}\) 损失 0。
- 合计 \(0.25\),而全知风险为 0。
校验
- (a) 熵的单调性:\(\bot\preceq\mathcal{S}_B\preceq\mathcal{S}_B\vee\mathcal{S}_M\preceq\top\) 对应 \(0\le0.811\le1.5\le2\) ✓。次可加性 \(H(\mathcal{S}_B\vee\mathcal{S}_M)=1.5\le0.811+0.811=1.622\) ✓。
- (b) \(\mathcal{S}_B\) 与 \(\mathcal{S}_M\) 熵相等却互不可比。这是 Shannon 原文那句话的具体化:"\(H(X)\) 几乎不是实际的信息"(用他的说法,熵只是格上的一个标量,不是格元素本身)✓。
- (c) \(0.25\) 与算例 2.4 的粗地图风险 \(0.25\) 相同并非巧合:算例 2.4 的粗划分 \(\{\{1,2\},\{3,4\}\}\) 与这里的 \(\mathcal{S}_M\) 都恰好把"一个要 \(b_2\) 的格"与"要 \(b_1\) 的格"合在一块,块内最好也得错掉 \(\tfrac14\) 的概率质量 ✓。
备注:σ-代数、Gács–Körner 公共信息、Wyner 公共信息
测度论读者把"由统计量 \(S\) 生成的划分"读成"由 \(S\) 生成的 \(\sigma\)-代数 \(\sigma(S)\)",\(\preceq\) 读成包含,\(\wedge\) 读成 \(\sigma\)-代数之交,\(\vee\) 读成由并生成的 \(\sigma\)-代数。有限情形下逐字对应。
**交与 Gács–Körner。**一个函数同时是 \(\mathcal{S}\) 与 \(\mathcal{S}'\) 的函数,当且仅当它在 \(\mathcal{S}\wedge\mathcal{S}'\) 的每块上取常值。所以交的块指标就是"两者共同能算出的最大公共函数"(公共部分)。
Gács–Körner 公共信息回答的问题是:甲只看到 \(X\) 的长序列、乙只看到 \(Y\) 的长序列,两人不通信,最多能各自算出多少比特完全相同的随机比特?Gács–Körner 1973 [5] 证明:在渐近零误差的意义下,这个最大速率恰是上述最大公共函数的熵,且一般远小于互信息(论文标题即结论)。
用上面的小例子(四个元素等概):公共函数是"是不是 4",GK 公共信息 \(=h(1/4)=0.811\) 比特,而 \(I(\mathcal{S};\mathcal{S}')=H(\mathcal{S})+H(\mathcal{S}')-H(\mathcal{S}\vee\mathcal{S}')=1.5+1.5-2=1\) 比特。
算例 3.3 更极端:交是 \(\bot\),GK 公共信息为 0,但 \(I(\mathcal{S}_B;\mathcal{S}_M)=0.811+0.811-1.5=0.12\) 比特 \(>0\)。两个任务的知识统计相关,却没有一比特能被两边各自确定地算出来。
**请注意用法。**格的交是一个划分,GK 公共信息是它的熵。一个是集合,一个是数,不要写成等式。
Wyner 公共信息(Wyner 1975 [6])\(C(X;Y)=\inf_{X-W-Y}I(X,Y;W)\) 引入了一个不是样本空间函数的辅助变量 \(W\),不是格运算。三者的一般排序是 \(K_{\mathrm{GK}}\le I(X;Y)\le C_{\mathrm{Wyner}}\)。本章只用格的交,不用 Wyner。
到此为止我们得到了什么
一个能装下"所有摘要"的容器。观测空间的每种切法是一个元素,细者在上、粗者在下。任意两种切法有最细的公共粗化(交)与最粗的公共细化(并)。
四格算例里两个任务的并要 1.5 比特,交是平凡的。任务之间的"共享知识"与"合计知识"从此有了确切的运算。
3.4 任务格:从任务类到划分的单调映射#
现在把 §3.2 与 §3.3 拼起来。每个任务类 \(\mathcal{T}\) 都有它的"最粗的够用划分",任务类越宽,这个划分越细。于是"任务类 \(\mapsto\) 划分"是一个从任务集合到信息格的单调映射,它的像就是本章的主角。
3.4.1 任务格的定义与结构命题#
定义 3.3(任务格)【本站提法】
设 \(\mathcal{E}\) 为有限实验。称任务类 \(\mathcal{T}\) 满足无平局假设 (H):对每个 \(T\in\mathcal{T}\) 与每个在 \(\pi_T\) 下有正概率的观测 \(y\),Bayes 最优动作 \(a^\star_T(y)\) 唯一。记 \(\mathcal{S}_T\) 为 \(y\mapsto a^\star_T(y)\) 的水平集划分(单任务的地板)。
若存在最粗的 \(\mathcal{T}\)-充分划分,记为 \(\mathcal{S}_{\mathcal{T}}\),称为 \(\mathcal{T}\) 的任务类充分划分(或任务类最小充分统计量)。任务格(task lattice)
是映射 \(\mathcal{T}\mapsto\mathcal{S}_{\mathcal{T}}\) 的像。
命题 3.2(任务格的结构)【本站演算】
在无平局假设 (H) 下:
(a) 存在性与显式公式。\(\mathcal{S}_{\mathcal{T}}\) 存在,且
(b) 单调。\(\mathcal{T}\subseteq\mathcal{T}'\Rightarrow\mathcal{S}_{\mathcal{T}}\preceq\mathcal{S}_{\mathcal{T}'}\)。
(c) 保并。\(\mathcal{S}_{\mathcal{T}\cup\mathcal{T}'}=\mathcal{S}_{\mathcal{T}}\vee\mathcal{S}_{\mathcal{T}'}\)。
(d) 交只有不等式。\(\mathcal{S}_{\mathcal{T}\cap\mathcal{T}'}\preceq\mathcal{S}_{\mathcal{T}}\wedge\mathcal{S}_{\mathcal{T}'}\),且可以严格。
(e) 夹在两端之间。\(\bot=\mathcal{S}_{\varnothing}\preceq\mathcal{S}_{\mathcal{T}}\preceq M_{\mathrm{all}}\preceq\top\),其中 \(M_{\mathrm{all}}\) 是 §3.2 的似然划分(经典最小充分划分)。
(f) 格。\(\Lambda(\mathcal{E})\) 对 \(\vee\) 封闭且含 \(\bot\),因而本身是一个格;但它的交一般不等于划分格中的交((d) 的严格情形)。
证明。
(a) 由引理 3.1 (iii) 与 (H),一个划分 \(\mathcal{S}\) 对单个 \(T\) 充分,当且仅当下面几条依次等价:
- 每块上有公共最优动作;
- (最优动作唯一)\(a^\star_T\) 在每块上取常值;
- 每块落在 \(a^\star_T\) 的某个水平集内,即 \(\mathcal{S}\succeq\mathcal{S}_T\)。
这一步把"充分"翻译成了格里的一个不等式。
对整类 \(\mathcal{T}\) 充分,当且仅当 \(\mathcal{S}\succeq\mathcal{S}_T\) 对每个 \(T\) 成立,当且仅当 \(\mathcal{S}\) 是 \(\{\mathcal{S}_T\}\) 的一个共同上界,当且仅当(并的定义:最小上界)\(\mathcal{S}\succeq\bigvee_T\mathcal{S}_T\)。有限集上的划分只有有限个,所以即使 \(\mathcal{T}\) 无限,这个并也只是有限多个不同划分的并。
于是 \(\mathcal{T}\)-充分划分的集合恰是 \(\{\mathcal{S}:\mathcal{S}\succeq\bigvee_T\mathcal{S}_T\}\),其最粗元素就是 \(\bigvee_T\mathcal{S}_T\)。\(\square\)
(b) \(\mathcal{T}\subseteq\mathcal{T}'\) 时,(a) 右端对更多元素取并,并只会变细。\(\square\)
(c) \(\bigvee_{T\in\mathcal{T}\cup\mathcal{T}'}\mathcal{S}_T=\bigl(\bigvee_{\mathcal{T}}\mathcal{S}_T\bigr)\vee\bigl(\bigvee_{\mathcal{T}'}\mathcal{S}_T\bigr)\),这是并的结合律与交换律。\(\square\)
(d) 由 (b),\(\mathcal{S}_{\mathcal{T}\cap\mathcal{T}'}\) 同时粗于 \(\mathcal{S}_{\mathcal{T}}\) 与 \(\mathcal{S}_{\mathcal{T}'}\),故不超过它们的最大下界。
严格的例子用算例 3.3:令 \(\mathcal{T}=\{B,M\}\),\(\mathcal{T}'=\{J\}\),其中 \(J\) 是"同时报波束与 MCS 档"的联合任务,其最优动作划分恰为 \(\mathcal{S}_B\vee\mathcal{S}_M=\{\{1,2\},\{3\},\{4\}\}\)。则 \(\mathcal{S}_{\mathcal{T}}=\mathcal{S}_{\mathcal{T}'}=\{\{1,2\},\{3\},\{4\}\}\),交也是它。但 \(\mathcal{T}\cap\mathcal{T}'=\varnothing\),\(\mathcal{S}_{\varnothing}=\bot\)。严格。\(\square\)
(e) 空类的并是 \(\bot\)(对空族取最小上界即最小元)。
\(\mathcal{S}_T\preceq M_{\mathrm{all}}\):由 §3.2,\(\mathbf{v}_j\) 是 \(\bigl(\pi_i\ell_i(y_j)\bigr)_i\) 的正倍数,而 \(\mathrm{Opt}_T\) 对正倍数不变,故 \(a^\star_T(y_j)\) 只通过 \(\boldsymbol{\ell}(y_j)\) 依赖于 \(y_j\),即 \(\mathcal{S}_T\) 粗于 \(M_{\mathrm{all}}\)。再取并仍粗于 \(M_{\mathrm{all}}\)。\(\square\)
(f) \(\Lambda(\mathcal{E})\) 是有限集,对 \(\vee\) 封闭(由 (c)),含最小元 \(\bot\)。有限并半格(join-semilattice:任意两元素都有并、但不一定有交的偏序集)若有最小元则是格。
理由是:任意两元素 \(x,y\) 的下界集合非空(含 \(\bot\))且有限,对其取并,得到的元素仍 \(\preceq x\) 且 \(\preceq y\)(\(x\) 是每个下界的上界,所以也是它们的并的上界),因而就是最大下界。\(\blacksquare\)
物理意义
- (a) 说:一个任务类需要的知识,就是把它里面每个任务各自需要的知识合并起来(取并)。没有别的来源,也不会更少。
- (d) 说:两个任务类的"公共知识"可能比它们各自知识的公共部分更少。因为"公共任务"才算数,而"公共知识"可能来自两边完全不同的任务恰好需要同样的东西。
行为分析
- **(b) 就是 §3.1 的陷阱。**门限固定 \(\Rightarrow\) \(\mathcal{T}\) 是一个点,\(\mathcal{S}_{\mathcal{T}}\) 是符号划分(1 比特)。门限可调 \(\Rightarrow\) \(\mathcal{T}\) 变宽,\(\mathcal{S}_{\mathcal{T}}\) 是整条增益差的量化(6 比特)。
- **(H) 不是装饰。**若允许平局,"最粗充分划分"可以不存在。下面是一个例子。
- (e) 给出全章最重要的两个端点。\(M_{\mathrm{all}}\) 是"任何任务都不可能需要更多"的天花板,\(\mathcal{S}_T\) 是"这一个任务不可能需要更少"的地板。
平局的反例:设四个观测的最优动作集合是 \(y_1:\{a,b\}\)、\(y_2:\{b,c\}\)、\(y_3:\{a\}\)、\(y_4:\{c\}\)。由引理 3.1 (iii),一块够用当且仅当块内有公共最优动作,于是 \(\{y_1,y_3\}\)(公共 \(a\))、\(\{y_2,y_4\}\)(公共 \(c\))、\(\{y_1,y_2\}\)(公共 \(b\))都可以成块。
\(\mathcal{P}_1=\{\{y_1,y_3\},\{y_2,y_4\}\}\) 与 \(\mathcal{P}_2=\{\{y_1,y_2\},\{y_3\},\{y_4\}\}\) 都充分,都无法再合并任何两块,且互不可比,所以不存在唯一"最粗"的那个。
它们的交按连通分量把四个观测连成一块(\(\{y_1,y_3\}\) 与 \(\{y_1,y_2\}\) 共有 \(y_1\),\(\{y_1,y_2\}\) 与 \(\{y_2,y_4\}\) 共有 \(y_2\)),得到 \(\bot\),而四个观测没有公共最优动作,\(\bot\) 不充分。
工程上平局是零测事件,剔除有平局的先验与门限即可。由风险对先验的连续性,剔除不改变 \(\mathcal{S}_{\mathcal{T}}\)【本站演算】。
3.4.2 无线任务格的第一张 Hasse 图#
Hasse 图(Hasse diagram)是画偏序的标准方式:每个元素一个节点,只在"直接"相邻的一对更细–更粗元素之间画边,能经传递推出的关系不再画。
现在把容器装上无线的内容。取本部第 1 章的链的第一环:知识是关于环境的,观测是"信道能看见的环境"。按第一部第 8 章,信道只能把环境分辨到等价类 \([E]_\varepsilon\),所以我们取 \(\Theta_\varepsilon:=\{[E]_\varepsilon\}\)(离散化后有限)为状态空间,实验为单位阵,即"知道 \(\theta\) 落在哪一块",正如算例 3.3。
此时 \(M_{\mathrm{all}}=\top\):顶元素就是信道可见等价类本身。每个无线任务给出 \(\Theta_\varepsilon\) 的一个划分,它们的并与交按定义 3.2 计算。下图把主要节点画出来,每个节点标注"它对哪个任务类是最粗的够用划分"与"大约多少比特"。
flowchart TB
    TOP["$$\top$$ 信道可见等价类 $$[E]_\varepsilon$$<br/>一切信道任务<br/>$$\approx 1.3\times10^{6}$$ bit<br/>(会议室,算例 3.4)"]
    APS["角功率谱 APS<br/>(各发射方向上的功率)<br/>只依赖方向的一切任务类<br/>$$\approx 64\times6=384$$ bit<br/>(示意)"]
    GV["波束增益向量 $$g_1\ldots g_{64}$$<br/>(本区 + 邻区)<br/>码本固定的波束 /<br/>功控 / 切换任务类<br/>$$\le 384$$ bit"]
    TAIL["尾 CDF<br/>(增益的<br/>下尾分位数)<br/>中断预测 /<br/>链路余量任务类<br/>$$\approx 3\times6=18$$ bit"]
    KF["$$K$$ 因子<br/>(首径能量比)<br/>全部门限的<br/>LoS 判决类<br/>$$\approx 6$$ bit"]
    DIFF["增益差 $$g_n-g_s$$<br/>(量化到 0.5 dB)<br/>全部门限的切换类<br/>$$\approx 6$$ bit<br/>(算例 3.1)"]
    BI["最优波束索引<br/>$$\arg\max g$$<br/>单码本<br/>波束选择,<br/>$$k=64$$ · 6 bit"]
    SGN["增益差符号<br/>$$\mathbf{1}[g_n-g_s \gt \mathrm{Off}]$$<br/>固定门限 A3 切换,<br/>$$k=2$$ · 1 bit"]
    LOS["LoS 指示<br/>$$\mathbf{1}[K\ge K_0]$$<br/>固定门限<br/>LoS 判决,<br/>$$k=2$$ · 1 bit"]
    OUT["中断指示<br/>$$\mathbf{1}[P_{\mathrm{out}} \gt p]$$<br/>固定目标的<br/>中断判决,<br/>$$k=2$$ · 1 bit"]
    BOT["$$\bot$$ 平凡划分<br/>不需要环境知识的任务<br/>0 bit"]
    TOP --> APS
    TOP --> TAIL
    TOP --> KF
    APS --> GV
    GV --> BI
    GV --> DIFF
    DIFF --> SGN
    TAIL --> OUT
    KF --> LOS
    BI ---> BOT
    SGN --> BOT
    OUT ----> BOT
    LOS ----> BOT
怎么读这张图
- 向下的箭头是"粗化"(下面的节点是上面节点的函数,\(\preceq\))。同一层里没有箭头相连的节点互不可比。
- 三条支路在顶元素之下就分开了:方向支路(APS → 增益向量 → 索引 / 增益差 → 符号)、尾部支路(尾 CDF → 中断指示)、首径支路(K 因子 → LoS 指示)。它们的交一般是 \(\bot\)。
- 节点上的比特数是本站示意性推算【本站推算】:\(64\) 波束索引 \(6\) 比特是算术事实;增益向量按 64 个方向各 6 比特幅度量化;尾 CDF 按 3 个分位数各 6 比特;\(1.3\times10^{6}\) 见算例 3.4。
- 图中没有画"最优波束索引"与"中断指示"之间的任何边。它们不可比,这是下面要论证的。
三条支路为什么是这样的
- **方向支路的链条 \(\mathrm{APS}\succeq\mathbf{g}\succeq\{\text{索引},\ \Delta\}\succeq\text{符号}\)。**波束增益 \(g_k=\int|B_k(\varphi)|^2\,\mathrm{APS}(\varphi)\,\mathrm{d}\varphi\) 是角功率谱的线性泛函(\(B_k\) 为第 \(k\) 个波束的方向图),故增益向量是 APS 的函数。
- 最优索引是增益向量的 \(\arg\max\)。
- 本区与邻区的增益差是它的两个分量之差。
- 切换符号是增益差的门限函数。
- 每一步都是"取函数",即划分的粗化。
- **尾部支路与方向支路不可比。**取两个环境状态 \(\theta,\theta'\):主导方向相同(故最优波束索引相同),但一个有深衰落尾巴、一个没有(中断指示不同)。于是"索引划分"不能粗于"中断划分"。再取两个状态:尾巴相同但主导方向不同,"中断划分"也不能粗于"索引划分"。两者互不为对方的函数,在格里不可比。它们的交是 \(\bot\)(除非环境族恰有某种耦合),并是"索引 × 中断"的乘积划分,7 比特。
- **切换类 \(\succeq\) 中断类?不成立。**直觉上容易写出"波束管理 ≽ 切换 ≽ 中断预测"这样一条链,它只对前半段成立(增益向量确实决定"谁更强")。后半段不成立:"谁更强"是均值层面的比较,不含尾部。正确的说法是:方向支路是一条链,尾部支路是另一条链,两条链只在顶元素处汇合。
3.4.3 第一步引理:两个任务的充分统计量显式解#
任务格要落地,至少得有一个能严格证明的无线实例。取第一部第 10 章的单反射面玩具族,它就是两径模型,并把波束理想化为扇区波束,充分划分可以精确写出。
引理 3.3(两径模型上波束选择类与 LoS 判决类的充分划分)【本站演算】
模型。信道 \(\mathbf{h}=\alpha_1\mathbf{a}(\varphi_1)+\alpha_2\mathbf{a}(\varphi_2)\):两条路径,复增益 \(\alpha_p\)、发射方向 \(\varphi_p\),路径 1 为首到径(时延最短)。码本由 \(N\) 个理想扇区波束组成:第 \(k\) 个波束在扇区 \(\Omega_k\) 内增益为 1、扇区外为 0,扇区两两不交、并为全部方向。记 \(k(\varphi)\) 为方向 \(\varphi\) 所在的扇区编号。环境状态 \(\theta=(\varphi_1,\varphi_2,\alpha_1,\alpha_2)\)。排除零测的平局集合(\(|\alpha_1|=|\alpha_2|\)、\(\alpha_1+\alpha_2=0\)、\(\varphi_p\) 恰在扇区边界)。
(a) 单码本波束选择(任务:选 \(\arg\max_kg_k\),0-1 损失,任意无平局先验):
充分划分 \(\mathcal{S}_{\mathrm{beam}}\) = 按"主导径所在扇区"分块,\(N\) 块,\(\le\log_2N\) 比特(\(N=64\) 时 6 比特)。它不依赖相对强度 \(|\alpha_2/\alpha_1|\) 的大小(只依赖谁大)与相位差。
(b) 波束选择类(任务类:码本沿方向整体平移任意偏移 \(\tau\) 的全体波束选择任务):充分划分 = 按主导径方向 \(\varphi_{\mathrm{dom}}\) 本身分块(连续量),即只记"主导径的方向"这一个量。哪条径更强只用来决定取 \(\varphi_1\) 还是 \(\varphi_2\),本身不单独记录。\(\varphi_{\mathrm{dom}}\) 相同而主导径不同的两个状态落在同一块,例如 \(\varphi_1=10^\circ\) 且 \(|\alpha_1|>|\alpha_2|\),与 \(\varphi_2=10^\circ\) 且 \(|\alpha_2|>|\alpha_1|\)。
(c) LoS 判决类(任务类:对一切门限 \(K_0>0\) 判定 \(K:=|\alpha_1|^2/|\alpha_2|^2\ge K_0\),0-1 损失):单个门限的充分划分是 \(\mathbf{1}[K\ge K_0]\)(1 比特)。整个类的充分划分 = 按 \(K\) 的值分块,即首径能量比本身。
这里的 \(K\) 借用了莱斯 \(K\) 因子(确定分量与散射分量的功率比,预备篇 2.4)的名字:两径模型里没有散射分量,由第二条径的功率代替。它与扇区编号 \(k(\cdot)\)、动作数 \(k\) 是不同的量。
证明。
(a) 第 \(k\) 个波束的增益为 \(g_k=\bigl|\alpha_1\mathbf{1}[\varphi_1\in\Omega_k]+\alpha_2\mathbf{1}[\varphi_2\in\Omega_k]\bigr|^2\)。*理想扇区波束把"投影"变成了"在不在扇区里",这是能写出闭式的全部原因。*分两种情形。
情形一:\(k(\varphi_1)\ne k(\varphi_2)\)。则 \(g_{k(\varphi_1)}=|\alpha_1|^2\),\(g_{k(\varphi_2)}=|\alpha_2|^2\),其余 \(g_k=0\)。最大者是模较大的那条径所在扇区,即 \(k(\varphi_{\mathrm{dom}})\),无平局保证唯一。
情形二:\(k(\varphi_1)=k(\varphi_2)=:k_0\)。则 \(g_{k_0}=|\alpha_1+\alpha_2|^2>0\)(已排除相消),其余为 0,最优为 \(k_0=k(\varphi_1)=k(\varphi_2)=k(\varphi_{\mathrm{dom}})\)。
两种情形下 \(a^\star=k(\varphi_{\mathrm{dom}})\)。由命题 3.2(a),单任务的充分划分就是 \(a^\star\) 的水平集。\(\square\)
(b) 对偏移 \(\tau\) 的码本,扇区编号函数变为 \(k_\tau(\varphi)\),由 (a) 得 \(a^\star_\tau=k_\tau(\varphi_{\mathrm{dom}})\)。由命题 3.2(a),类的充分划分是 \(\bigvee_\tau\mathcal{S}_{k_\tau(\varphi_{\mathrm{dom}})}\)。
两个状态若 \(\varphi_{\mathrm{dom}}\) 不同,总存在某个偏移 \(\tau\) 使一条扇区边界恰好落在两者之间(边界位置随 \(\tau\) 连续滑过整个方向区间),于是它们在该 \(\tau\) 下被分开。反之 \(\varphi_{\mathrm{dom}}\) 相同的状态在每个 \(\tau\) 下都同块。故并恰是按 \(\varphi_{\mathrm{dom}}\) 分块。
而 \(\varphi_{\mathrm{dom}}\) 是 \((\varphi_1,\varphi_2)\) 与"\(|\alpha_1|\gtrless|\alpha_2|\)"的函数。这就是"主导 AoD 与次强径的相对强度"的精确含义:相对强度只以符号进入,而且只用来决定取哪条径的方向。\(\square\)
(c) 单门限:0-1 损失下最优动作是 \(\mathbf{1}[K\ge K_0]\),充分划分为其水平集。全部门限的并:两个状态 \(K\ne K'\) 时取 \(K_0\) 落在两者之间即被分开;\(K=K'\) 时任何门限都不分开。故并是按 \(K\) 分块。\(\blacksquare\)
物理意义
波束选择类只要"主导径的方向"(谁是主导只用来选出这个方向,本身不必另记)。LoS 判决类只要"首径能量比"。
两者是 \(\Theta_\varepsilon\) 的两个互不可比的划分(方向相同能量比可以不同,反之亦然)。它们的并("方向 + 能量比")才是同时服务两类任务的最粗知识。
这是 CKM 该分层存储的第一个可证实例:BIM 一层,K 因子 / LoS 概率图一层,缺一不可、合一冗余。
行为分析
理想扇区波束是 (a) 能写成闭式的关键。真实 DFT 波束有旁瓣与主瓣滚降,两条径落在同一主瓣内时 \(g_k=|B_k(\varphi_1)\alpha_1+B_k(\varphi_2)\alpha_2|^2\) 含交叉项,最优索引开始依赖相位差 \(\arg(\alpha_2/\alpha_1)\)。充分划分变细,比特数随两径角距离缩小而增加。
这是第 4 章"相位 / 结构二分"的入口:分辨到相位的知识只在 \(\lambda/4\) 量级内可迁移。真实波束下的显式充分划分【部分结果】:两径角距离大于一个主瓣宽度时 (a) 的结论按近似成立,小于时未刻画。
到此为止我们得到了什么
任务格本身。任务类到划分的映射单调、保并、不保交。像夹在最优动作划分与似然划分之间,本身是一个格。
无线的第一张 Hasse 图有三条支路,两径模型上其中两条支路的充分划分被显式写出:波束类只要主导 AoD,LoS 类要首径能量比。
3.5 顶与底:Q1 天花板与任务地板#
格画出来了,接下来给顶和底标上比特。
3.5.1 顶、底与猜想 3.4#
顶
顶元素 \(\top=\Theta_\varepsilon\) 是"信道在精度 \(\varepsilon\) 下能分辨的环境等价类"。它有多少块?
先取第一部第 8 章的口径:会议室 \(a=5\) m、3.5 GHz,曲面观测的有效维度 \(d_{\mathrm{eff}}(E;\varepsilon)=\#\{j:\sigma_j(\mathrm{D}\Phi[E])>\varepsilon\sigma_1\}\approx1.3\times10^{5}\)。
把信道可见的那一部分环境看成一个 \(d_{\mathrm{eff}}\) 维的有界集合。在相对精度 \(\varepsilon\) 下能分辨的块数,就是它的 \(\varepsilon\)-覆盖数(covering number)。覆盖数指最少要多少个边长 \(\varepsilon\) 的小格才能把集合盖满,换成半径 \(\varepsilon\) 的小球只差一个常数倍。每个小格就是一个"内部差别分不清"的块。
覆盖数的对数按维数计数。用长 \(\varepsilon\) 的小段盖满 \([0,1]\) 要 \(1/\varepsilon\) 段,\(\varepsilon=10^{-3}\) 时是 \(1000\) 段、约 \(10\) 比特。\(d\) 维时每一维各切一次,块数约 \((1/\varepsilon)^{d}\)。
所以每个可见维度贡献约 \(\log_2(1/\varepsilon)\) 比特。这里用到单位球的 \(\varepsilon\)-覆盖数 \(\sim(c/\varepsilon)^{d}\),\(c\) 为与维数无关的常数。于是
底
单任务 \(T\) 的地板是 \(\mathcal{S}_T\),其熵不超过 \(\log_2|A_T|\):
猜想 3.4(Q1 天花板与任务地板)【开放·本站原创】
设 \(\mathcal{E}\) 为无线环境族上的信道可见实验,任务类 \(\mathcal{T}\) 由损失在 \([0,1]\) 的信道任务组成。记 \(\Delta U_T(R)\) 为"用 \(R\) 比特描述环境所能带来的任务 \(T\) 的最大效用改善"(定义 3.4,下文),\(R^{\mathrm{sat}}_T\) 为其饱和点。猜想:
**(a) 天花板。**对一切 \(T\in\mathcal{T}\),
且在 \(R\ge R_{\mathrm{ceil}}\) 处任何任务的风险与"环境全知"的风险之差为 \(O(\varepsilon)\)。会议室的数字:\(1.3\times10^{5}\times\log_2 10^{3}\approx1.3\times10^{6}\) 比特 \(\approx160\) kB【本站推算】。这是第一部第 9 章"CKM 的香农曲线"\(\Delta C(R_{\mathrm{env}})\) 右端点的比特坐标。
**(b) 地板。**对单个任务 \(T\)(无平局),\(R^{\mathrm{sat}}_T=H(\mathcal{S}_T)\le\log_2|A_T|\):64 波束 \(\le6\) 比特、固定门限切换 \(\le1\) 比特。
**(c) 中间。**对任务类 \(\mathcal{T}\),\(R^{\mathrm{sat}}_{\mathcal{T}}=H(\mathcal{S}_{\mathcal{T}})\),且饱和点在格上单调:\(\mathcal{S}_{\mathcal{T}}\preceq\mathcal{S}_{\mathcal{T}'}\Rightarrow R^{\mathrm{sat}}_{\mathcal{T}}\le R^{\mathrm{sat}}_{\mathcal{T}'}\)。
已知与未知的边界
- (b) 的"\(\le\)"方向是平凡的(直接传 \(a^\star\),见定理 3.5(b))。
- (a) 的"知道顶就知道一切"是数据处理不等式。
- 未知的是 (a) 里 \(R_{\mathrm{ceil}}\) 是否是紧的。任务对环境的依赖具有物理 Lipschitz 结构(第一部第 10 章猜想形态 \(R_{e'}(f)\le R_e(f)+C\cdot d(e,e')\)),很可能使一切实际任务在远低于 \(R_{\mathrm{ceil}}\) 处饱和。这是 Q3 曲线"中段形状未知"(凹增 / 阈值跳变 / 早饱和)的另一种问法。
- (c) 的单调性由命题 3.2(b) 与熵的单调性可证,但"饱和点 = 熵"需要率失真意义下的精确化(§3.6)。
3.5.2 算例 3.4:会议室的五个数字#
算例 3.4(会议室的五个数字:一本量纲分明的账)
同一间会议室(第一部第 8 章:8 m × 5 m × 3 m,3.5 GHz,\(\lambda\approx8.57\) cm),五个数字,三种量纲:
| 层 | 数字 | 量纲 | 出处 |
|---|---|---|---|
| 环境完整描述 | \(\approx1.9\times10^{8}\) | 参数个数(\(\lambda/10\) 体素数) | 第一部第 8 章 |
| 信道可见维度 \(d_{\mathrm{eff}}\) | \(\approx1.3\times10^{5}\) | 维数 | 第一部第 8 章 |
| 到通信精度的天花板 \(R_{\mathrm{ceil}}\) | \(\approx1.3\times10^{6}\) | 比特 | 本章【本站推算】 |
| 波束索引图 BIM,每位置 | \(6\) | 比特 / 位置 | 算术事实 |
| 固定门限切换,每判决 | \(1\) | 比特 / 判决 | 算术事实 |
天花板的算式。\(\varepsilon\) 取第一部第 8 章工程动态范围 \([10^{-6},10^{-3}]\)(幅度)的宽松端 \(10^{-3}\):
换成字节:\(1.296\times10^{6}/8=1.62\times10^{5}\) B \(\approx160\) kB。
三个量纲不能互换。
- \(1.9\times10^{8}\) 是"要写多少个数"。
- \(1.3\times10^{5}\) 是"这些数里有多少个独立方向被信道看见"。
- \(1.3\times10^{6}\) 是"把看得见的方向写到通信精度要多少比特"。
第一部第 8 章已提醒,前者是参数个数,后两者是维数,不宜与比特混写。本章把第三种量纲补齐:维数乘以每维的分辨率比特,才是比特。
校验
- (a) \(\log_2 10^{3}=9.966\) 用另一条路径:\(2^{10}=1024\),故 \(\log_2 1000=10-\log_2 1.024=10-0.0342=9.966\) ✓。
- (b) \(1.3\times10^{5}\times9.966=1.2956\times10^{6}\),四舍五入 \(1.3\times10^{6}\) ✓。
- (c) 对 \(\varepsilon\) 的敏感性:\(\varepsilon=10^{-6}\) 时 \(\log_2 10^{6}=19.93\),\(R_{\mathrm{ceil}}\approx2.6\times10^{6}\) 比特 \(\approx320\) kB。整个工程动态范围只让天花板变化 2 倍,所以天花板对 \(\varepsilon\) 是对数敏感,对 \(d_{\mathrm{eff}}\) 是线性敏感 ✓。
- (d) \(d_{\mathrm{eff}}\) 自身复算:\(k=2\pi/\lambda=73.3\) rad/m,\(ka=366.5\),\((ka)^2=1.34\times10^{5}\),与第一部口径 \(1.3\times10^{5}\) 一致 ✓。
- (e) 体素数复算:\(120\ \mathrm{m}^3/(8.57\ \mathrm{mm})^3=120/6.30\times10^{-7}=1.9\times10^{8}\) ✓。
3.5.3 算例 3.5:BIM 的原始存储#
算例 3.5(BIM 的原始存储:任务比特 ≪ 原始存储 ≪ 天花板)
把 64 波束的波束索引图铺在 10 m × 10 m 的区域上,按 \(\lambda/2\) 栅格存。CKM 教程 [19] 的定性原则是:小尺度知识需要与波长同量级的定位精度。教程没有给出存储字节数,以下全是本站按 \(\lambda/2\) 栅格的推算【本站推算】。
第一步:波长与栅格。\(\lambda=c/f=3\times10^{8}/3.5\times10^{9}=0.08571\) m,\(\lambda/2=0.04286\) m。
**第二步:位置数。**每边 \(10/0.04286=233.3\) 格,共 \(233.3^2=5.44\times10^{4}\) 个位置。
**第三步:原始比特。**每位置 6 比特:\(5.44\times10^{4}\times6=3.27\times10^{5}\) 比特 \(\approx41\) kB。
第四步:与天花板比。\(3.27\times10^{5}\) 与 \(1.3\times10^{6}\) 同量级(差 4 倍)。这说明原始 BIM 几乎和"信道看得见的一切"一样大,这显然不对:BIM 是顶元素的一个函数(Hasse 图里从 \(\top\) 向下三层),信息量不可能接近顶。
**第五步:熵编码后。**波束索引不在 \(\lambda\) 尺度上变化,而在环境特征尺度 \(L\) 上变化。第一部第 2 章指出,\(\lambda/L\) 决定环境哪些细节被信道看见。最优波束随位置的切换发生在遮挡边缘与反射面边界,尺度 \(L\sim1\) m。
若索引在 \(L=1\) m 的区域内分片常值,独立区域约 \((10/1)^2=100\) 个,\(100\times6=600\) 比特,再加区域边界的描述。这比原始存储低两到三个数量级。
这就是"任务需要的比特 \(\ll\) 原始存储"的实例:原始存储在为 \(\lambda\) 尺度的采样付费,任务只在 \(L\) 尺度上有信息。
校验
- (a) 改用截断到四位小数的 \(\lambda/2=0.0428\) m 复算:\((10/0.0428)^2=5.46\times10^{4}\),与 \(5.44\times10^{4}\) 相差 \(0.4\%\),同为 \(5.4\)–\(5.5\times10^{4}\) ✓。
- (b) 比特数复算:\(5.44\times10^{4}\times6=3.266\times10^{5}\),\(/8=40.8\) kB ✓。
- (c) 数据处理不等式的一致性:BIM 熵编码后的比特(\(\sim10^{3}\))\(<\) 原始存储(\(3.3\times10^{5}\))\(<\) 天花板(\(1.3\times10^{6}\)),三者的序与 Hasse 图的方向一致 ✓。
- (d) 极限:\(L\to\lambda/2\)(波束随每个位置独立变化)时熵编码退化为原始存储 \(3.3\times10^{5}\) ✓;\(L\to10\) m(整片区域同一波束)时只需 6 比特 ✓。
到此为止我们得到了什么
格的两端各一个数。顶是 \(d_{\mathrm{eff}}\log_2(1/\varepsilon)\approx1.3\times10^{6}\) 比特(160 kB),这是 Q3 曲线右端点的比特坐标。底是 \(H(a^\star)\le\log_2|A_T|\)。
两者之间差六个数量级,而 BIM 的原始存储与熵编码之间又差两三个数量级。"任务需要什么"从此有了上下界。
3.6 给格元素定价:间接率失真#
格告诉我们"要哪一部分",还没告诉"要多少比特"。熵 \(H(\mathcal{S})\) 是零失真的价格。允许一点任务损失时价格会降,降多少由率失真函数决定。
但这里有个特殊之处:我们压缩的是观测 \(X\)(信道、CSI),而任务关心的是隐变量 \(\theta\)(环境、位置、下一时刻的增益)。这叫间接(indirect / remote)率失真,1962 年就有编码定理。
3.6.1 模型与定理 3.5#
直觉
你不能直接看到 \(\theta\),只能看到它的带噪版本 \(X\),还要把 \(X\) 压缩后传给别人去猜 \(\theta\)。问题看起来比普通率失真难,其实可以化归:把"猜错 \(\theta\) 的损失"换算成"看到 \(X\) 后的期望损失",就变回了以 \(X\) 为源的普通率失真,只是失真度量换了一个。
模型
- \((\theta_i,X_i)\) 独立同分布,\(\theta_i\sim\pi\),\(X_i\sim W(\cdot\mid\theta_i)\)(有限字母表)。
- 编码器只见 \(X^n\),输出 \(nR\) 比特;译码器输出 \(\hat{\theta}^n\);失真 \(d(\theta,\hat\theta)\ge0\) 有界。
- 速率 \(R\) 在失真 \(D\) 下可达,若存在编码序列使 \(\limsup_n\frac1n\sum_{i=1}^{n}\mathbb{E}\,d(\theta_i,\hat\theta_i)\le D\)。\(R_{\mathrm{ind}}(D)\) 为可达速率的下确界。
定理 3.5(间接率失真,Dobrushin–Tsybakov 1962 / Witsenhausen 1980)【已解决(经典)·本站搬运】
定义修正失真(modified distortion)
(a) 对 \(D\ge D_{\min}:=\mathbb{E}\bigl[\min_{\hat\theta}d'(X,\hat\theta)\bigr]\),
即以 \(X\) 为源、\(d'\) 为失真的直接率失真函数;\(D<D_{\min}\) 不可达。
(b)【本站演算·由 (a) 直接推出】 若在每个正概率的 \(x\) 处 \(\arg\min_{\hat\theta}d'(x,\hat\theta)\) 唯一(记为 \(a^\star(x)\)),则
即在任务能达到的最小损失处,所需速率恰是任务地板的熵。
出处:Dobrushin–Tsybakov 1962 [3](含噪信源的最优编码)。Witsenhausen 1980 [7] 的"断连原理"给出统一表述,并推广到噪声相关、译码端边信息、失真第二自变量再过信道等情形。教科书处理见 Berger 1971 [4]。
3.6.2 定理 3.5 的证明#
证明。
**第一步:关键恒等式。对任何编码,\(\theta\) 上的平均失真等于 \(X\) 上的平均修正失真。**固定任一编码,\(\hat\theta_i\) 是 \(X^n\) 的函数,记 \(\hat\theta_i=\hat\theta_i(x^n)\)。按定义展开期望:
这一步只是"先对 \(X^n\) 条件、再对 \(\theta_i\) 求期望"。
**第二步:无记忆性把条件从 \(x^n\) 缩到 \(x_i\)。**因 \((\theta_j,X_j)\) 独立同分布,
相除得 \(P(\theta_i=\theta\mid x^n)=P(\theta,x_i)/P(x_i)=P(\theta\mid x_i)\)。*给定 \(X_i\),其余的 \(X_j\) 对 \(\theta_i\) 不再提供任何信息。这是无记忆性的全部作用,也是"\(\hat\theta_i\) 依赖整个 \(x^n\)"不碍事的原因。*代回第一步:
**第三步:两个问题的可达区域相同。**第二步对每个 \(i\) 与每个编码成立。所以任一编码在间接问题里的失真 \(\frac1n\sum_i\mathbb{E}d(\theta_i,\hat\theta_i)\),与它在"源 \(X\)、失真 \(d'\)"的直接问题里的失真 \(\frac1n\sum_i\mathbb{E}d'(X_i,\hat\theta_i)\) 逐编码相等。
编码器都只看 \(X^n\),两个问题的编码集合是同一个集合。于是可达 \((R,D)\) 对的集合相同,\(R_{\mathrm{ind}}(D)=R^{\mathrm{direct}}_{X,d'}(D)\)。
**第四步:引用直接率失真定理。**Shannon 的率失真定理(预备篇 4.9;Berger [4])说:对有限字母表的无记忆源与有界失真,直接问题的最小可达速率是 \(\min_{p(\hat\theta\mid x):\mathbb{E}d'\le D}I(X;\hat\theta)\)。代入即得 (a)。
\(D<D_{\min}\) 时约束集为空:任何编码的失真 \(\ge\mathbb{E}\min_{\hat\theta}d'(X,\hat\theta)=D_{\min}\)(逐符号取最小)。
**第五步:证 (b)。**在 \(D=D_{\min}\) 处,约束 \(\mathbb{E}d'(X,\hat\theta)\le D_{\min}\) 迫使 \(\hat\theta\in\arg\min d'(x,\cdot)\) 几乎必然,否则某个正概率的 \(x\) 处期望严格超过最小值。唯一性给出 \(\hat\theta=a^\star(X)\) 几乎必然,是 \(X\) 的确定函数,故 \(I(X;\hat\theta)=H(a^\star(X))\)。
这个速率可达:把 \(a^\star(X^n)\) 无损传输,速率 \(H(a^\star(X))\),失真恰为 \(D_{\min}\)。\(\blacksquare\)
物理意义
- 修正失真 \(d'(x,\hat\theta)\) 就是看到 \(x\) 之后采取动作 \(\hat\theta\) 的后验期望损失。它是定理 2.2 证明第二步里那个 \(g_\theta(z)\)(固定 \(\theta\) 时的期望损失)按后验 \(P(\theta\mid x)\) 对 \(\theta\) 加权平均的版本。
- 间接率失真于是说:任务导向压缩,等于以"后验期望损失"为失真度量的普通压缩。任务不必被显式传输,它以失真度量的身份进入了编码定理。
- (b) 把两章接上了:格给出地板 \(\mathcal{S}_T\),率失真在 \(D_{\min}\) 处给出它的价格 \(H(\mathcal{S}_T)\)。同一个东西,两种语言。
行为分析
- **\(D_{\min}\) 是不可约失真。**无论多少比特,隔着噪声观测猜 \(\theta\) 总有一个下限。这是 §3.1 里"中断预测要一条尾 CDF"的编码论解释:尾部信息隔着单次观测本来就看不清。
- **\(d'\) 由任务的损失与观测模型共同决定,与编码器无关。**这回答了语义通信的那个老问题(§3.7)。
- **从单任务到任务类。**任务类对应一组修正失真 \(\{d'_T\}_{T\in\mathcal{T}}\),自然的推广是多失真约束的率失真 \(\min I(X;Z)\) s.t. \(\mathbb{E}d'_T\le D_T\ \forall T\)。Liu–Zhang–Poor 2021/2022 [16][17] 的"语义率失真"正是双失真的这种形式(一个约束对不可观测的内在状态、一个对外在观测)。闭式只在高斯观测与二元分类等特例下已知【部分结果】。
3.6.3 算例 3.6:二元间接率失真曲线#
算例 3.6(二元间接率失真曲线:\(R(D)=1-h\bigl((D-q)/(1-2q)\bigr)\))【已解决·本站演算实例】
\(\theta\sim\mathrm{Bern}(1/2)\),\(X=\theta\oplus Z\),\(Z\sim\mathrm{Bern}(q)\),\(q<1/2\),汉明失真 \(d(\theta,\hat\theta)=\mathbf{1}[\theta\ne\hat\theta]\)。
**第一步:后验。**先算 \(P(X=x)=\tfrac12(1-q)+\tfrac12q=\tfrac12\),所以 \(X\) 也等概,第四步要用。由 Bayes 公式,\(P(\theta=x\mid X=x)=\tfrac12(1-q)\big/\tfrac12=1-q\),\(P(\theta\ne x\mid X=x)=q\)。
第二步:修正失真。\(d'(x,\hat\theta)=P(\theta\ne\hat\theta\mid X=x)\):若 \(\hat\theta=x\) 则 \(=q\);若 \(\hat\theta\ne x\) 则 \(=1-q\)。写成一个式子:
第三步:把约束换算到 \(X\) 上。\(\mathbb{E}\,d'(X,\hat\theta)=q+(1-2q)\Pr\{\hat\theta\ne X\}\le D\),即
*这一步说:在 \(\theta\) 上容忍 \(D\),等于在 \(X\) 上容忍 \(D_{\mathrm{eff}}\),做法是把不可约的 \(q\) 扣掉,再按 \(1-2q\) 缩放。*这里的 \(D_{\mathrm{eff}}\) 是"折算到 \(X\) 上的有效失真",与 §3.5 的有效维度 \(d_{\mathrm{eff}}\) 无关。
**第四步:直接率失真。**因为 \(1-2q>0\),第三步两边除过去不等号不变向,约束 \(\mathbb{E}\,d'(X,\hat\theta)\le D\) 与 \(\Pr\{\hat\theta\ne X\}\le D_{\mathrm{eff}}\) 是同一个约束。
于是定理 3.5(a) 要求的,恰是 \(X\sim\mathrm{Bern}(1/2)\)(第一步已得)在汉明失真下的直接率失真函数 \(\min_{p(\hat\theta\mid x):\,\Pr\{\hat\theta\ne X\}\le D_{\mathrm{eff}}}I(X;\hat\theta)\)(定义见预备篇 4.9)。对 \(D_{\mathrm{eff}}\in[0,1/2]\),它等于 \(1-h(D_{\mathrm{eff}})\)(Berger [4]),分两步验证:
- **下界。**记 \(N:=X\oplus\hat\theta\),则 \(\Pr\{N=1\}\le D_{\mathrm{eff}}\)。\(I(X;\hat\theta)=H(X)-H(X\mid\hat\theta)=1-H(N\mid\hat\theta)\ge1-H(N)\ge1-h(D_{\mathrm{eff}})\)。第二个等号:\(H(X)=1\),且给定 \(\hat\theta\) 时 \(X\) 与 \(N\) 一一对应;第一个不等号:条件不增熵;最后一步:\(h\) 在 \([0,1/2]\) 上递增。
- **可达。**取 \(\hat\theta\sim\mathrm{Bern}(1/2)\) 与 \(N\sim\mathrm{Bern}(D_{\mathrm{eff}})\) 独立,令 \(X=\hat\theta\oplus N\)。这样的 \(X\) 确实等概,由联合分布可读出一个合法的 \(p(\hat\theta\mid x)\)。此时 \(\Pr\{\hat\theta\ne X\}=D_{\mathrm{eff}}\),\(H(N\mid\hat\theta)=H(N)=h(D_{\mathrm{eff}})\),上面的不等式全部取等。
第五步:代回。
端点来自 \(D_{\mathrm{eff}}\in[0,\tfrac12]\):\(D_{\mathrm{eff}}=0\iff D=q\);\(D_{\mathrm{eff}}=\tfrac12\iff D-q=\tfrac12(1-2q)\iff D=\tfrac12\)。
\(D<q\) 对应 \(D_{\mathrm{eff}}<0\),即要求 \(\Pr\{\hat\theta\ne X\}<0\),不可能。这就是定理 3.5 的 \(D_{\min}\):每个 \(x\) 处 \(\min_{\hat\theta}d'(x,\hat\theta)=q\),故 \(D_{\min}=q\)。
数值(\(q=0.1\),\(D=0.2\))。\(D_{\mathrm{eff}}=0.1/0.8=0.125\),\(h(0.125)=0.125\times3+0.875\times0.1926=0.375+0.1686=0.5436\),其中 \(\log_2(1/0.125)=3\),\(\log_2(1/0.875)=0.1926\)。所以 \(R=1-0.5436=0.456\) 比特,与下图 \(q=0.1\) 曲线在 \(D=0.2\) 处的值一致。
校验
- (a) 两端点:\(D=q\) 时 \(D_{\mathrm{eff}}=0\),\(R=1-h(0)=1\)。这是把 \(X\) 原样无损传输(\(H(X)=1\)),失真恰为不可约的 \(q\),与定理 3.5(b) 吻合:\(a^\star(x)=x\),\(H(a^\star(X))=H(X)=1\) ✓。\(D=1/2\) 时 \(D_{\mathrm{eff}}=1/2\),\(R=1-h(1/2)=0\),什么也不传、瞎猜,错一半 ✓。
- (b) 三种参数化同一个数:\(R_{q=0.1}(0.30)\)、\(R_{q=0}(0.25)\)、\(R_{q=0.2}(0.35)\) 的 \(D_{\mathrm{eff}}\) 都是 \(0.25\),三者都等于 \(1-h(0.25)=1-0.8113=0.1887\) ✓。曲线族只是直接曲线沿横轴的仿射变换 \(R_q(D)=R_0\bigl((D-q)/(1-2q)\bigr)\)。
- (c) 极限 \(q\to0\):\(R\to1-h(D)\),退化为直接二元率失真 ✓。\(q\to1/2\):可达区间 \([q,1/2]\) 缩成一点,观测与 \(\theta\) 独立,任何速率都无用 ✓。
- (d) 曲线在 \(D=q\) 处的斜率 \(=-h'(0^+)/(1-2q)=-\infty\)。从不可约失真出发的第一比特最值钱,与第三部 \(V(I)\)"在小 \(I\) 处极陡"同形 ✓。
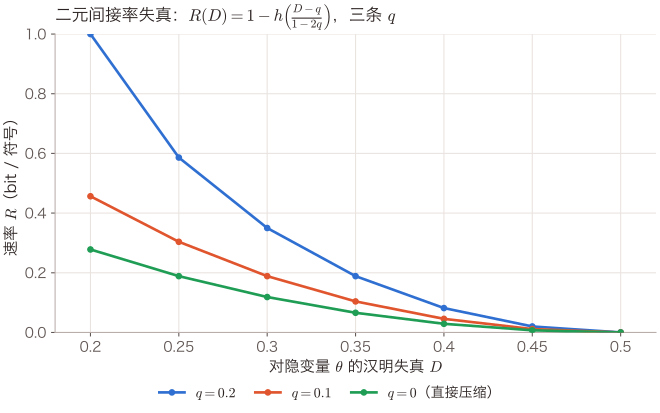
怎么读这张图
- 三条曲线自上而下是 \(q=0.2\)、\(q=0.1\)、\(q=0\)(直接压缩,无观测噪声)。
- 横轴从 \(0.2\) 起,因为 \(q=0.2\) 的曲线在 \(D<0.2\) 处不存在(不可达)。\(q=0.1\) 的曲线在图外的 \(D=0.1\) 处到达 \(R=1\)。
- 观测噪声 \(q\) 越大,曲线整体右移、变陡:同样的任务失真要花更多比特,且"第一比特"更值钱。
- 三条曲线在 \(D_{\mathrm{eff}}=0.25\) 处的值都是 \(0.1887\)(分别在 \(D=0.35,0.30,0.25\)),这就是校验 (b)。数据由算例 3.6 的闭式逐点算出。
到此为止我们得到了什么
格元素的价签。任务导向压缩在 1962 年就有编码定理,秘诀是把任务损失换成"看到观测后的后验期望损失"作为失真度量。在最小可达失真处,价格恰是任务地板的熵,格与率失真在此接口。
二元算例给出了整条曲线与它的不可约失真 \(q\)。
3.7 任务汇率族:四个场景与方法盘点#
本章最后把格接回全站的价目表,再盘点当代方法各自解决了什么、回答不了什么。
3.7.1 任务汇率族#
第一部第 9 章定义了知识汇率 \(\Delta C(R_{\mathrm{env}})=\sup_{\text{env codes}}[C(\text{prior}+\text{env code})-C(\text{prior})]\),意思是用 \(R_{\mathrm{env}}\) 比特描述环境能换多少容量。本章的观点是:它不是一条曲线,而是一族。
定义 3.4(任务汇率族)【本站提法】
对任务 \(T\),记 \(U_T(\cdot)\) 为在给定知识下的最优期望效用(\(=-\,\)Bayes 风险)。任务汇率曲线
饱和点 \(R^{\mathrm{sat}}_T:=\inf\{R:\Delta U_T(R)=\Delta U_T(\infty)\}\)。第一部的 \(\Delta C(R_{\mathrm{env}})\) 是 \(T=\)"容量"(动作 = 码本与功率分配、效用 = 可达速率)这一个成员。
猜想 3.6(汇率族的膝点由格决定)【开放·本站提法】
每条 \(\Delta U_T(R)\) 单调不减;饱和点满足 \(R^{\mathrm{sat}}_T=H(\mathcal{S}_T)\)(单任务,无平局)与 \(R^{\mathrm{sat}}_{\mathcal{T}}=H(\mathcal{S}_{\mathcal{T}})\)(任务类);曲线在 \(R\to0^+\) 处的斜率由间接率失真曲线在 \(D_{\min}\) 附近的形状决定。
已知
- 单调性显然由定义得出。
- \(R^{\mathrm{sat}}_T\le H(\mathcal{S}_T)\) 由"直接传 \(a^\star\)"得出。
- \(D_{\min}\) 处的速率等于 \(H(\mathcal{S}_T)\) 是定理 3.5(b)。
未知
- 饱和点是否恰好等于(而非小于)\(H(\mathcal{S}_T)\)。这要求在 \(D_{\min}\) 以下不存在"更便宜的近似",即 \(\Delta U_T\) 在饱和前严格递增,这依赖损失的具体形状。
- 容量任务的膝点是否远低于 \(R_{\mathrm{ceil}}\)(猜想 3.4(a) 的紧性)。
同样的比特对不同任务值不同的钱,这句话现在有了精确的形态:\(\Delta U_T(R)\) 在 \(R\approx H(\mathcal{S}_T)\) 处拐弯,而 \(H(\mathcal{S}_T)\) 沿格单调。切换类在 1 比特处饱和,波束类在 6 比特处饱和,容量任务的饱和点在 \(10^{6}\) 比特以下的某处(未知)。
CKM 该存哪几层,就是问:要服务的任务类 \(\mathcal{T}\) 的 \(\mathcal{S}_{\mathcal{T}}=\bigvee_T\mathcal{S}_T\) 是格里的哪个元素。命题 3.2(a) 说答案是"各任务地板的并",引理 3.3 给了第一个实例(BIM 层与 K 因子层缺一不可)。
这与第一部第 7 章"地图是分布泛函 \(m_T(\mathbf{x})=T[P(h\mid\mathbf{x})]\)"互为对偶:那里按泛函列举地图种类,这里按任务类决定该存哪些泛函【本站提法】。
3.7.2 四个场景#
场景一:语义 / 目标导向通信
Strinati–Barbarossa 2021 [14]、Kountouris–Pappas 2021 [15]、Gündüz 等 2023 [18] 的共识是:语义熵没有公认定义,语义通信没有编码定理,缺的是失真度量从哪来(预备篇第 9 章口径:"换了度量不是破了定理")。这是文献共识,不是本站发现。
本站的答案【本站提法】:失真度量从任务类的损失来。单任务给 \(d'_T(x,a)=\mathbb{E}[L_T(\theta,a)\mid x]\)(定理 3.5),任务类给一组 \(\{d'_T\}\),而"够用的表示"就是格元素 \(\mathcal{S}_{\mathcal{T}}\)。这样一来编码定理是现成的(1962 年),真正开放的是任务类版本的多失真率失真的可计算性。
2025 年的一份预印本 [22]【预印本·未评审】把失真从点估计换成条件分布之间的距离,在双对称二元源上得到带阈值效应的闭式。这是"失真度量从哪来"的另一个候选答案,与本站"从任务损失来"的口径可以并存:分布型失真对应的任务是"报告整条后验"(对数损失或 Brier 类损失),它在格里是 \(M_{\mathrm{all}}\) 附近的高层元素。
场景二:CKM 该存哪几层
已在上文用命题 3.2(a) 与引理 3.3 回答:存 \(\bigvee_{T\in\mathcal{T}}\mathcal{S}_T\)。CKM 教程 [19] 给出的是定性的栅格原则:大尺度知识按相关距离栅格化,小尺度知识需波长量级定位精度。教程没有存储字节数,算例 3.5 的 41 kB 与 \(\sim10^{3}\) 比特是本站推算。
开放的是第一部第 7 章 \(\Delta U(\varepsilon)\):地图带误差 \(\varepsilon\) 建成时,格上每一层各损失多少。第 6 章的误差预算给数值实例。
场景三:ISAC 感知精度该定多高
第一部第 10 章已写明 ISAC 两条路径不同构:信息论路径给容量–失真 \(C(D)\),估计论路径给 CRB–rate 折中与边际价格 \(\nu(R)=\mathrm{d}\epsilon^\star(R)/\mathrm{d}R\)【本站提法】。其中 CRB 即 Cramér–Rao 界,是任何无偏估计器方差的下界,见预备篇 9.4。
两条路径回答的都是"精度值多少速率",没有回答"任务要多高的精度"。本章的回答是:精度要求来自任务类的宽度。
- 固定门限切换(\(k=2\))只要角度 / 距离估计能把符号判对。
- 波束选择(\(k=64\))要主导 AoD 分辨到扇区宽度(引理 3.3(a))。
- LoS 判决类要的根本不是角度,而是首径能量比(引理 3.3(c))。
所以给 CRB 定目标之前,先在格上找到 \(\mathcal{S}_{\mathcal{T}}\),CRB 目标就是让感知估计的划分细于它。
场景四:边缘推理传特征还是传结论
- 传结论 = 传 \(a^\star\),即格的底 \(\mathcal{S}_T\),最省比特(\(\le\log_2|A_T|\)),但只服务这一个任务。
- 传特征 = 传格上较高的一个元素,服务一个任务类,多花的比特由 \(H(\mathcal{S}_{\mathcal{T}})-H(\mathcal{S}_T)\) 计量。
Shlezinger–Eldar–Rodrigues 2019 [11] 的任务导向量化在线性任务(恢复线性参数)上给出闭式,并实证"考虑任务后少量比特即可逼近向量量化器"。这是"地板远低于天花板"的工程证据。非线性任务无闭式。
3GPP 两侧模型的 CSI 压缩传的是"重建信道",这是格上较高的元素;而基站的任务只需要格上更低的元素。第 1 章 TR 38.843 的结果是中间 KPI 改善了、最终 KPI 没有跟着涨,这就是"传得比 \(\mathcal{S}_{\mathcal{T}}\) 更高,不会自动更好"的实测版本。
Rel-16 eType II 码本到底报了什么(TS 38.214 第 5.2.2.2.5 节)
以 Rel-16 eType II 码本为例,按 TS 38.214 第 5.2.2.2.5 节,报告内容如下:
- 先报各层共用的 \(L\) 个空间波束,每层再报 \(M_\upsilon\) 个频域基,\(\upsilon\) 为秩。
- 再报一张 \(2LM_\upsilon\) 比特的位图,标出哪些线性组合系数非零。
- 最强的那个系数只报位置,幅度与相位归一、不报。
- 另报一个 4 比特的参考幅度,给不含最强系数的那个极化。
- 其余每个非零系数各报 3 比特幅度(8 级)和 4 比特相位(16PSK)。
- 非零系数每层不超过 \(K_0\)、各层合计不超过 \(2K_0\),\(K_0=\lceil\beta\cdot 2LM_1\rceil\)。
- \(L\)、\(\beta\) 与决定 \(M_\upsilon\) 的比例 \(p_\upsilon\) 都由 paramCombination-r16 配置,所以比特数随空间波束数、频域基数目与秩增长。
3.7.3 方法盘点#
| 方法 | 解决了什么 | 回答不了什么 | 与本章的接口 |
|---|---|---|---|
| 信息瓶颈 IB(Tishby 1999;综述 Goldfeld–Polyanskiy 2020 [12]) | 给定任务变量 \(Y\),用互信息刻画"压缩 vs 保留"的曲线;\(\beta\to\infty\) 极限是最小充分统计量(Gilad-Bachrach 等 2003 [9]) | 一般损失下无编码定理(第 1 章 §1.6 的陷阱框);是曲线不是格;只对一个 \(Y\) | IB 的极限点 = 本章 \(M_{\mathrm{all}}\);任务类版本无对应 |
| 间接率失真(Dobrushin–Tsybakov 1962 [3]、Witsenhausen 1980 [7]、Berger 1971 [4]) | 有编码定理:任务导向压缩 = 修正失真下的直接压缩 | 失真度量外生;多任务 / 多终端版本基本空白 | 定理 3.5;本章把 \(d'\) 内生为任务损失的后验期望 |
| Blackwell 序与 \(k\)-亏格(第 2 章;Torgersen 1991 [8]) | 任务无关 / 任务限制的最坏风险界,充分性的等价刻画 | \(\delta_k\) 的显式计算与 \(\delta_k\)–\(\delta\) 的量化桥(据本站检索未见显式陈述) | 定义 3.1(c);引理 3.1 |
| 亏格瓶颈(Banerjee–Montúfar 2020 [13]) | 用 Le Cam 亏格替代互信息做表示学习的瓶颈,亏格有"决策问题最优风险差"的操作意义;其变分上界受 VIB 目标控制 | 仍是变分近似;无线任务类上无实例 | 任务类亏格 ↔ 表示学习的最直接文献桥 |
| 贝叶斯充分表示(Sevetlidis 2026 [21]【预印本】) | 单任务充分性的严格定义与刻画:\(\mathcal{I}_{\ell,P}=\sigma(a^\star)\) | 只有单任务;无任务类、无格、无率 | 本章任务地板的文献版本 |
| 任务导向量化(Shlezinger 等 2019 [11]) | 线性任务的硬件受限量化闭式;少量比特即可 | 非线性任务无闭式 | 场景四 |
| 语义率失真(Liu 等 2021/2022 [16][17];Zhao 等 2025 [22]【预印本】) | 双失真 / 分布型失真的率失真,特例闭式,阈值效应 | 失真度量仍由外部指定;一般情形无闭式 | 任务类版本的多失真率失真 |
| 率–失真–感知(Blau–Michaeli 2019 [10]) | 感知约束抬高 R–D 曲线的严格证明 | 感知不是任务轴——不要把它混入任务格 | 对照用,第 1 章 §1.6 |
| 语义通信总纲([14][15][18]) | 图景与问题清单;"失真度量从哪来"的明确点名 | 无度量、无定理 | 场景一 |
表的最后一列是本章的落点。现有方法分三种情况:
- 有定理,但度量外生(间接率失真)。
- 度量内生,但无定理(IB、语义通信)。
- 只覆盖单任务(贝叶斯充分)或线性任务(任务量化)。
把"任务类 → 格元素 → 修正失真族 → 多失真率失真"串成一条线,是本章的组织方式【本站提法】。串起来之后,缺的那条定理有了名字:任务类的率失真函数及其 converse(开放问题 Q3.2)。
任务-知识格的工具谱系
| 年份 | 工作 | 要点 |
|---|---|---|
| 1953 | Shannon 信息格 | 信息元素 = 划分,偏序 = 细化,交与并 |
| 1954 | Bahadur | 抽象充分性与决策函数,最小充分性 |
| 1962 | Dobrushin–Tsybakov | 含噪信源的最优编码,间接率失真起点 |
| 1964 | Le Cam | 亏格 \(\delta\)(第 2 章) |
| 1971 | Berger | 修正失真化归的教科书处理 |
| 1973 | Gács–Körner | 公共信息远小于互信息 |
| 1975 | Wyner | 第二种公共信息(不是格运算) |
| 1980 | Witsenhausen | 间接率失真的统一表述 |
| 1991 | Torgersen | \(k\)-亏格与限制类比较 |
| 1999 | Tishby–Pereira–Bialek | 信息瓶颈 |
| 2003 | Gilad-Bachrach–Navot–Tishby | IB 极限 = 最小充分统计量 |
| 2019 | Shlezinger–Eldar–Rodrigues | 任务导向量化 |
| 2020 | Banerjee–Montúfar | 亏格瓶颈 |
| 2021 | Liu–Zhang–Poor 与 Strinati、Kountouris | 语义率失真、目标导向通信 |
| 2023 | Gündüz 等 | 任务导向通信总纲,失真度量从哪来 |
| 2025 | Akdemir 与 Zhao 等 | Le Cam 失真层级、分布型语义失真 |
| 2026 | Sevetlidis 与本站 | 贝叶斯充分表示、任务格 |
怎么读这张表
- **上段(1953–1980)**是三条独立的线:格(Shannon、GK、Wyner)、充分性(Bahadur、Le Cam、Torgersen)、含噪信源编码(Dobrushin–Tsybakov、Berger、Witsenhausen)。三条线各自在自己的学科里完成。
- 中段(1999–2020),机器学习把充分性与率失真重新发现为 IB 与亏格瓶颈。
- 下段(2021 起),无线在语义通信里第三次撞上同一个问题。
本章做的事是把三条线接成一条:格给"要哪一部分",充分性给"够用"的判据,间接率失真给价格。
到此为止我们得到了什么
一族曲线与四个落点:
- 第一部的知识汇率是按任务索引的一族曲线,膝点由格上的位置决定。
- 语义通信缺的失真度量来自任务类的损失。
- CKM 存"各任务地板的并"。
- ISAC 的精度目标先在格上找元素再定 CRB。
- 边缘推理传结论是底、传特征是高层,差价可计量。
所有现有方法的空白汇成同一个缺口:任务类的率失真定理。
跨部连线
本章所在的线索:任务与价值。
- 第三部第 5 章「第四级台阶」:任务的汇率曲线与 \(V(I)\) 在小信息量处同样陡峭:"第一比特最值钱"。
- 第四部 4.6 节:两个基站地图的"公共部分"是划分的交,它的熵就是 Gács–Körner 公共信息。
开放问题#
**Q3.1(\(k\)-亏格能紧多少)【部分结果】。**定义 3.1(c) 给出 \(\delta_{\mathcal{T}}\le\delta\)。
第 2 章 Q2.3 里 BEC(0.6)/BSC(0.2) 一对的 \(\delta_2=0.10\) 其实不必猜:硬判决本身就是一个两动作任务,它的风险差 \(0.30-0.20=0.10\) 给出 \(\delta_2\ge0.10\),又有 \(\delta_2\le\delta=0.10\)。
背后是一条一般的必要条件:被模拟的实验读数不超过 \(k\) 种时,\(\delta_k=\delta\)。理由是 \(\delta\) 等于对一切先验、一切任务取最坏的 Bayes 风险差。被模拟一方的 Bayes 规则至多用到读数个数那么多个动作。把任务的动作集删到只剩这些,它的 Bayes 风险不变,模拟方的只会变大,所以最坏的任务总能在不超过 \(k\) 个动作里找到【本站演算】。
比值要小于 1,被模拟的一方必须比 \(k\) 分得更细。这只是必要条件:反过来用 BSC 模拟 BEC 时,BEC 有 3 种读数,逐个枚举两动作规则算出的 \(\delta_2\) 仍等于 \(\delta=0.08\)。
- 精确陈述:对无线实验族与 \(k\in\{2,64\}\),求 \(\delta_k/\delta\) 的范围。形如 \(\delta\le c(k)\delta_k\) 的一般量化桥,本站读到的二手综述里都没有【表述待核:Torgersen [8] 第 6 章原书未读到】。
- 第一步可证引理:有限情形下 \(\delta_k\) 是一个带 \(k\) 个动作的极小极大问题,用引理 3.1 第三步的分离超平面写成有限个线性规划的最大值。
- AI 可攻子问题:对算例 2.3 的 LP 加"动作数 \(\le k\)"约束逐 \(k\) 求解,画出 \(\delta_k\) 随 \(k\) 的阶梯。
**Q3.2(任务类的率失真定理)【开放·本站提法】。**定理 3.5 只对单任务。
- 精确陈述:任务类 \(\mathcal{T}\) 对应修正失真族 \(\{d'_T\}\),定义 \(R_{\mathcal{T}}(\mathbf{D}):=\min\{I(X;Z):\mathbb{E}d'_T(X,Z)\le D_T\ \forall T\}\)。证明其可达性与 converse,并在 \(\mathbf{D}=\mathbf{D}_{\min}\) 处证明 \(R_{\mathcal{T}}=H(\mathcal{S}_{\mathcal{T}})\)(猜想 3.6 的核心)。
- 已知工具:多失真率失真是标准的凸规划形式;Liu 等 [16][17] 给出双失真特例。
- 第一步:两个 0-1 任务(算例 3.3 的 B 与 M)在同一二元观测噪声下的 \(R_{\{B,M\}}(D_B,D_M)\) 显式解。
Q3.3(猜想 3.4(a) 的紧性:任务在多低的比特处饱和)【开放·本站原创】。\(R_{\mathrm{ceil}}=d_{\mathrm{eff}}\log_2(1/\varepsilon)\) 是"知道一切"的价格,真实任务多半早得多就饱和。
- 精确陈述:对容量任务,\(R^{\mathrm{sat}}_C/R_{\mathrm{ceil}}\) 的量级。这等价于第一部 Q3 曲线的中段形状。
- 第一步可证引理:在引理 3.3 的两径族上,容量任务的 \(\mathcal{S}_T\) 是 \((|\alpha_1|,|\alpha_2|,\varphi_1,\varphi_2)\) 的哪个函数,其熵与 \(R_{\mathrm{ceil}}\) 之比。
**Q3.4(真实波束下的充分划分与相位)【部分结果】。**引理 3.3 依赖理想扇区波束。两径角距离小于主瓣宽度时最优索引依赖相位差,充分划分变细。
- 精确陈述:以角距离 \(\Delta\varphi\) 为参数,\(H(\mathcal{S}_{\mathrm{beam}})\) 如何随 \(\Delta\varphi/\text{主瓣宽度}\) 变化;相位敏感区的宽度是否为 \(\lambda/4\) 量级(接第 4 章相位 / 结构二分)。
**Q3.5(无平局假设之外的任务格)【开放】。**命题 3.2 在有平局时最粗充分划分可能不存在(§3.4 行为分析)。
- 精确陈述:把"最粗充分划分"换成"极小充分划分的集合",任务格是否仍是格;Sevetlidis [21] 命题 A.2 的"纤维上存在公共最优动作"是否给出正确的一般定义。
**Q3.6(格的交的可操作提取)【开放·文献共识】。**两个任务的公共知识是划分的交,其熵由 Gács–Körner 公共信息给出,但 GK 公共信息的计算与有限块长下的可提取性是已知的难题 [5]。
无线版本:两个基站各自的地图有多少"公共部分"可以零率同步。这与第三部第 6 章 \(C(\varepsilon)\)(两小区最小 CSI 交换 \(\lesssim56\) 比特)是同一问题的两端。
预告。本章全程假设"知识描述的就是当前环境",只有 garbling,没有 misspecification。换城市、换厂商、仿真到实网时,格上的每个元素都可能指错对象:BIM 存的是别处的波束。这是第二种退化,误配译码与物理泛化界的地盘,第 4 章处理。第 6 章则把本章的格与第 2 章的亏格接成数值实例。
参考文献#
- C. E. Shannon, 《The lattice theory of information》, Trans. IRE Prof. Group Inform. Theory, vol. 1, no. 1, pp. 105–107, 1953. https://doi.org/10.1109/TIT.1953.1188572
- R. R. Bahadur, 《Sufficiency and statistical decision functions》, Ann. Math. Statist., vol. 25, no. 3, pp. 423–462, 1954. https://projecteuclid.org/journals/annals-of-mathematical-statistics/volume-25/issue-3/Sufficiency-and-Statistical-Decision-Functions/10.1214/aoms/1177728715.full
- R. L. Dobrushin, B. S. Tsybakov, 《Information transmission with additional noise》, IRE Trans. Inform. Theory, vol. 8, no. 5, pp. 293–304, 1962. https://doi.org/10.1109/TIT.1962.1057738
- T. Berger, 《Rate Distortion Theory: A Mathematical Basis for Data Compression》, Prentice-Hall, 1971.【修正失真的教科书处理;二元 remote 例的系数记号本站按定理 3.5 自行演算,发稿前宜与原书核对】
- P. Gács, J. Körner, 《Common information is far less than mutual information》, Problems of Control and Information Theory, vol. 2, no. 2, pp. 149–162, 1973.
- A. D. Wyner, 《The common information of two dependent random variables》, IEEE Trans. Inform. Theory, vol. 21, no. 2, pp. 163–179, 1975.
- H. S. Witsenhausen, 《Indirect rate distortion problems》, IEEE Trans. Inform. Theory, vol. 26, no. 5, pp. 518–521, 1980. https://doi.org/10.1109/TIT.1980.1056251
- E. N. Torgersen, 《Comparison of Statistical Experiments》(Encyclopedia of Mathematics and its Applications, vol. 36), Cambridge Univ. Press, 1991.
- R. Gilad-Bachrach, A. Navot, N. Tishby, 《An information theoretic tradeoff between complexity and accuracy》, Proc. COLT 2003, LNCS, pp. 595–609, 2003.
- Y. Blau, T. Michaeli, 《Rethinking lossy compression: The rate-distortion-perception tradeoff》, Proc. ICML 2019, PMLR vol. 97, pp. 675–685, 2019. https://proceedings.mlr.press/v97/blau19a.html
- N. Shlezinger, Y. C. Eldar, M. R. D. Rodrigues, 《Hardware-limited task-based quantization》, IEEE Trans. Signal Process., vol. 67, no. 20, pp. 5223–5238, 2019.
- Z. Goldfeld, Y. Polyanskiy, 《The information bottleneck problem and its applications in machine learning》, IEEE J. Sel. Areas Inf. Theory, vol. 1, no. 1, pp. 19–38, 2020. https://doi.org/10.1109/JSAIT.2020.2991561
- P. K. Banerjee, G. Montúfar, 《The variational deficiency bottleneck》, Proc. IJCNN 2020, 2020. https://arxiv.org/abs/1810.11677
- E. C. Strinati, S. Barbarossa, 《6G networks: Beyond Shannon towards semantic and goal-oriented communications》, Computer Networks, vol. 190, art. 107930, 2021. https://arxiv.org/abs/2011.14844v3
- M. Kountouris, N. Pappas, 《Semantics-empowered communication for networked intelligent systems》, IEEE Commun. Mag., vol. 59, no. 6, pp. 96–102, 2021. https://arxiv.org/abs/2007.11579v2
- J. Liu, W. Zhang, H. V. Poor, 《A rate-distortion framework for characterizing semantic information》, Proc. IEEE ISIT 2021, pp. 2894–2899, 2021. https://arxiv.org/abs/2105.04278
- J. Liu, S. Shao, W. Zhang, H. V. Poor, 《An indirect rate-distortion characterization for semantic sources: General model and the case of Gaussian observation》, IEEE Trans. Commun., vol. 70, no. 9, pp. 5946–5959, 2022.
- D. Gündüz et al., 《Beyond transmitting bits: Context, semantics, and task-oriented communications》, IEEE J. Sel. Areas Commun., vol. 41, no. 1, pp. 5–41, 2023. https://doi.org/10.1109/JSAC.2022.3223408
- Y. Zeng, J. Chen, J. Xu, D. Wu, X. Xu, S. Jin, X. Gao, D. Gesbert, S. Cui, R. Zhang, 《A tutorial on environment-aware communications via channel knowledge map for 6G》, arXiv:2309.07460, 2023. https://arxiv.org/html/2309.07460v2 【教程只给定性栅格原则,未给存储字节数;本章 41 kB 等数字全为本站推算】
- D. Akdemir, 《Le Cam distortion: A decision-theoretic framework for robust transfer learning》, arXiv:2512.23617v1, 2025.【预印本·未评审】 https://arxiv.org/abs/2512.23617
- V. Sevetlidis, 《Bayes-sufficient representations in supervised learning》, arXiv:2606.04045v1, 2026.【预印本·未评审】 https://arxiv.org/html/2606.04045
- Y.-Q. Zhao, Z.-M. Ma, G. Y. Li, S. Yuan, T. Ye, C. Zhou, 《Semantic rate-distortion theory with applications》, arXiv:2509.10061v1, 2025.【预印本·未评审】 https://arxiv.org/html/2509.10061
未单列的备查条目:Tishby–Pereira–Bialek 1999(信息瓶颈,编号引用见第 1 章参考文献 7);最小充分性判据在一般测度空间上的技术性反例 arXiv:2603.10288【预印本·未评审】(正文 §3.2 以 arXiv 编号直引);3GPP TS 38.331 的 A3 事件定义与 TS 38.214 的 Rel-16 eType II 码本结构(本章只用 A3 判决式;码本的逐项构成按 ETSI TS 138 214 V16.17.0 第 5.2.2.2.5 节核对,https://www.etsi.org/deliver/etsi_ts/138200_138299/138214/16.17.00_60/ts_138214v161700p.pdf ,不引具体 payload 总数)。