5 · 认知三角:通信、感知、决策的三元折中#
一部基站,一份波形,三件事。
它要把数据送出去(通信)。它要用同一份回波看清周围有什么(感知)。它还要决定下一个时隙把波束打向哪里、给谁分资源、要不要切换(决策)。三件事花的是同一份孔径、同一份能量、同一段时间。
ISAC(integrated sensing and communication,通感一体化)已经把前两件事的折中做成了一张二维图:速率对 CRB。工程师顺理成章地问:第三件事呢?能不能画一张三维图,叫"感知–通信–决策 region"?
本章的答案分三层。
- 第一层是一个判断:这张三维图目前不适定(ill-posed)。决策后悔是感知质量经任务映射后的函数,不能当作独立的第三根轴。这是 Howard 1966 [3]"信息的价值不是熵的函数"在 ISAC 语境下的重述,第 3 章的任务格给了它精确的语言。
- 第二层是一个母体:真正的问题结构 1960 年就有了名字,即 Feldbaum 的对偶控制(dual control)[1]:动作既调节又探测。于是"认知三角"应当改写成"认知回路"。
- 第三层是本章的主结果,认知平衡点(cognitive equilibrium)【本站模型·本站演算】:系统该把多少资源永久投给"认识环境",由环境相干时间与第一部 Q3 汇率曲线的形状共同决定。同一个无量纲数 \(\Lambda=100\),饱和型汇率给出 3.5%,幂律型给出 26.5%,差一个数量级。Q3 曲线不解,认知平衡点就没有定理。
本章预备知识
只需概率论、线性代数、信号与系统的本科内容,以及本部前三章。用到的内容:
- 实验 = 行随机矩阵、Blackwell 序、Le Cam 亏格 \(\delta\)、风险界(定理 2.2)、引理 2.3 的三角不等式与两条单调性、链定理骨架(定理 2.4):第 2 章。本章不使用"共同后处理单调"\(\delta(\mathbf{R}\mathcal{E},\mathbf{R}\mathcal{F})\le\delta(\mathcal{E},\mathcal{F})\)。第 2 章 §2.6 已证它为假。
- 任务类充分统计量(定义 3.1)、任务格(命题 3.2)、Q1 天花板 \(R_{\mathrm{ceil}}=d_{\mathrm{eff}}\log_2(1/\varepsilon)\approx1.3\times10^{6}\) 比特 \(\approx160\) kB(猜想 3.4、算例 3.4)、任务汇率族与猜想 3.6:第 3 章。
- ISAC 的两条路径(容量–失真 / CRB–rate)不同构、边际价格 \(\nu(R)\):第一部第 10 章与预备篇第 9 章。
- 知识汇率 \(\Delta C(R_{\mathrm{env}})\) 与"CKM 的香农曲线"(两端点已知、中段形状未知)、Hassibi–Hochwald 最优训练长度:第一部第 9 章。
- 一阶常微分方程 \(\dot q=a-q/T\) 的解、一元函数极值的一阶条件、\(\ln\) 与 \(e^{x}\) 的基本性质:高中与大一微积分。
- 卡尔曼滤波的一步更新(本章只用标量情形,§5.3 从头推)。
不需要测度论,也不需要控制论课程。对偶控制只用到"后验方差依不依赖于你选的动作"这一句话。
5.1 回顾:ISAC 已经把两件事定了价,用的是两把不同的尺#
5.1.1 直觉与两条路径#
直觉
你有一盏手电筒,既想照亮前方的路(通信:把能量送到接收端),又想借它看清路边有没有障碍(感知:把能量打到目标上再收回来)。光只有一束。照路照得越亮,看障碍就越暗,这就是二元折中。
ISAC 理论把"越亮 / 越暗"换成两个数,并且画出所有能同时做到的数对。
第一部第 10 章已把 ISAC 的基本限分成两条不同构的路径,本章原样沿用,不混写:
| 路径 | 感知度量 | 承重结果 | 状态 |
|---|---|---|---|
| 信息论路径 | 状态估计失真 \(D\)(发射端经广义反馈估计状态) | 容量–失真函数 \(C(D)=\max_{p(x)\in\mathcal{P}(D)}I(X;Y\mid S)\),Ahmadipour–Kobayashi–Wigger–Caire [10] | 点对点【已解决】;广播只有内外界【部分结果】 |
| 估计论路径 | 参数估计的 CRB(Cramér–Rao bound) | CRB–rate 区域:两个角点 \(P_{\mathrm{SC}}\)(高斯信号达到)与 \(P_{\mathrm{CS}}\)(Stiefel 流形上均匀分布达到),区域本身只有外界与若干内界;折中是两重的——子空间折中 ST 与确定–随机折中 DRT,Xiong 等 [11] | 角点【已解决】;区域【部分结果】 |
| 估计论路径(MIMO 波束成形) | CRB | SVD 加注水的半闭式最优设计,Hua–Han–Xu [12] | 该模型下【已解决】 |
| 边际价格 | — | \(\nu(R):=\mathrm{d}\epsilon^{\star}(R)/\mathrm{d}R\),"多要 1 bit/s/Hz 要付多少感知精度" | 【本站提法】,第一部第 10 章 |
三条要记住的事实:
- 两条路径的横轴都是速率,纵轴一个是失真、一个是 CRB,二者不能互换。失真是贝叶斯量(有先验),CRB 是频率派量(任意无偏估计量方差的下界,不限于渐近意义)。
- 就连二维 region,在最成熟的高斯 ISAC 模型里也只解出了角点。区域整体仍是内外界夹着的一条带子 [11]。
- Xiong 等的 DRT 说了一件本章要反复用到的事:数据本身的随机性会伤害感知。你发的信息越多(越随机),回波越难解。这是 §5.3 里"动作影响信息"的第一个无线实例。
5.1.2 玩具模型:二元折中曲线与分时弦#
为了后面能画一条"分时弦",本节给一个极简示意模型。它不是文献 [11] 的曲线,只用来让"分时"与"联合设计"的差别可见。
算例 5.1(功率分割玩具:二元折中曲线与分时弦)【本站示意】
总功率 \(P=10\)(10 dB)。设一个份额 \(\rho\in[0,1]\) 的功率用于感知导频,其余 \((1-\rho)P\) 用于数据。
- 通信速率取 AWGN 容量 \(R(\rho)=\log_2\bigl(1+(1-\rho)P\bigr)\)。
- 感知对象是一个单位方差的高斯参数,经信噪比 \(\rho P\) 的 AWGN 观测,最小均方误差 \(D(\rho)=1/(1+\rho P)\)。
这是高斯参数经高斯观测的 MMSE 闭式:先验精度 \(1\) 加上观测精度 \(\rho P\),后验方差是总精度的倒数 \(1/(1+\rho P)\),见预备篇 4.10的"精度相加"。
**第一步:消去 \(\rho\)。**由 \(D=1/(1+\rho P)\) 得 \(\rho P=1/D-1\),故 \((1-\rho)P=P-1/D+1=11-1/D\),
这一步把两个关于 \(\rho\) 的参数方程合成一条 \(R\)–\(D\) 曲线:\(D=1/11\)(全部功率给感知)时 \(R=\log_2 1=0\);\(D=1\)(不感知)时 \(R=\log_2 11=3.459\)。
**第二步:两个角点与分时弦。**角点 \(A=(D,R)=(1,\,3.459)\)(只通信)、\(B=(1/11,\,0)\)(只感知)。以时间份额 \(t\) 用 \(B\)、\(1-t\) 用 \(A\),平均性能落在连线上:
第三步:逐点比较。
- \(D=0.25\):联合曲线 \(R=\log_2(12-4)=\log_2 8=3.000\);分时弦 \(R=3.459\times0.1591/0.9091=0.605\)。
- \(D=0.5\):联合 \(\log_2 10=3.322\),弦 \(1.557\)。
联合设计在每个内点都严格高于分时弦。
校验
- (a) 两端点代回:\(D=1\) 时 \(\log_2(12-1)=\log_2 11=3.459\),弦亦为 \(3.459\) ✓。\(D=1/11\) 时 \(\log_2(12-11)=0\),弦为 \(0\) ✓。
- (b) 另一条路径复算 \(D=0.25\) 的点:\(\rho P=1/0.25-1=3\),\(\rho=0.3\),\((1-\rho)P=7\),\(\log_2(1+7)=3.000\) ✓。
- (c) 凹性:\(R(D)=\log_2(12-1/D)\) 的二阶导 \(\propto-\bigl[(12-1/D)^{-2}D^{-4}+2(12-1/D)^{-1}D^{-3}\bigr]<0\),曲线凹,故必在弦之上,与第三步逐点结果一致 ✓。
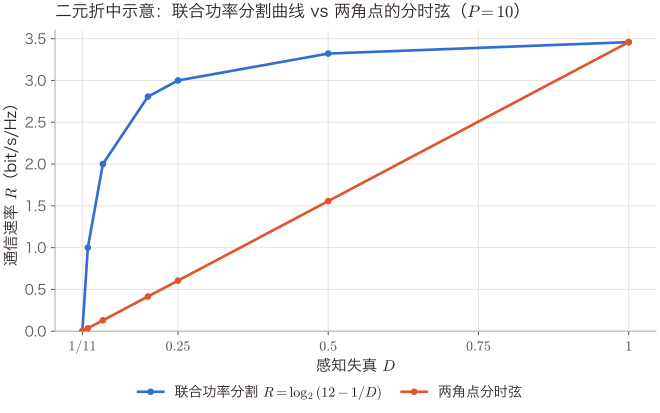
怎么读这张图:上方曲线是算例 5.1 的联合功率分割 \(R=\log_2(12-1/D)\),下方直线是只在两个角点之间做时间分配的"分时弦"。两者在端点重合、内部分开。分时永远可达(它是凸包),联合设计通常更好。
这个玩具只有一个自由度 \(\rho\),与文献 [11] 的高斯 ISAC 区域没有数值对应。用途是让 §5.7 的命题 5.4(分时凸包可达)与猜想 5.5(内部形状)在二维先有个图像。数据点由算例 5.1 的两个闭式逐点算出。
5.1.3 方法的边界#
两条路径回答的都是"精度值多少速率",回答不了两件事:
- 任务要多高的精度(甲)。这是第 3 章的格:在格上找 \(\mathcal{S}_{\mathcal{T}}\),再定 CRB 目标。
- 感知换来的知识明天还值不值钱(乙)。ISAC 基本限是单块(single block)的,感知得到的知识在块末就作废了。
第二件事就是本章要补的时间维。
到此为止我们得到了什么
一张二维图与它的两个边界。ISAC 把"精度值多少速率"定了价,用的是两把不能互换的尺,而且连二维区域都只解到角点。它不回答任务要多高精度,也不回答知识能用多久:前者归第 3 章,后者归本章。
5.2 第三轴为什么不独立:后悔是感知质量经任务映射后的函数#
5.2.1 感知实验与决策后悔#
直觉
两家体检机构,一家的 X 光片更清晰,另一家的血液指标更准。问"哪家的报告更能帮你做决定",答案取决于你要做什么决定:看骨折去第一家,查贫血去第二家。
"决策质量"不是体检报告的第三项指标,它是"报告 + 你要做的决定"共同算出来的一个数。把它当独立的轴画进图里,就等于把"你要做什么决定"这件事藏进了坐标系。
现在把它写成本部的语言。
定义 5.1(感知实验与决策后悔)
设环境 / 目标状态 \(\theta\in\Theta\)(有限)。感知实验(sensing experiment)\(\mathcal{E}_{\mathrm{sense}}=(P_\theta)_\theta\) 是一张行随机矩阵(定义 2.1):给定 \(\theta\),感知链路输出各读数的概率。记 \(\mathcal{E}_0\) 为"环境全知"(单位阵)。
对任务 \(T=(A_T,L_T,\pi_T)\),决策后悔(decision regret)
即"用这份感知去做决策,比全知多输多少 Bayes 风险"。非负性来自 \(\mathcal{E}_0\succeq\mathcal{E}_{\mathrm{sense}}\)(任何实验都是单位阵的 garbling)与定理 2.1 (i)\(\Rightarrow\)(ii)。
记号解释
- \(r_T(\cdot)\) 是第 2 章定义的 Bayes 风险(\(=\sum_j\psi_T(\mathbf{v}_j)\))。下标 \(T\) 提醒读者这个数带着任务。
- 回忆第 2 章定理 2.1 证明里的两个记号。\(\mathbf{v}_j\) 是读数 \(y_j\) 那一列按先验加权得到的向量,第 \(i\) 个分量 \(\pi_iP_{\theta_i}(y_j)\) 是"状态为 \(\theta_i\) 且读数为 \(y_j\)"的联合概率。
- \(\psi_T(\mathbf{v}):=\min_{a\in A_T}\sum_i v_i\,L_T(\theta_i,a)\) 是"看到这个读数后选最好的动作"所付的损失。
- 记号提醒:算例 5.1 的 \(\rho\) 是功率份额。从这里起 \(\rho_T\)(§5.7 省略下标写作 \(\rho\)、\(\rho_n\))专指决策后悔。§5.5 的 \(\rho_{\mathrm{eff}}\) 又是有效信噪比。三者无关。
5.2.2 关键结论:第三轴不独立#
关键结论(第三轴不独立)【本站判断;Howard 1966 论点在 ISAC 语境下的重述】
(a) 给定感知实验,后悔由任务唯一决定:\(\rho_T=g_T(\mathcal{E}_{\mathrm{sense}})\),其中 \(g_T\) 是定理 2.1 证明里的凹函数 \(\psi_T\) 沿实验各列求和再减常数。它不是可以独立于感知拨动的第三个资源汇。
(b) 对一切损失在 \([0,1]\) 的任务同时成立的上界:
这是定理 2.2 取 \(\mathcal{F}=\mathcal{E}_0\) 的直接实例。
(c) 不存在任何单一的感知标量(CRB、MSE、互信息、亏格)\(s(\mathcal{E}_{\mathrm{sense}})\) 与单调函数 \(f\),使 \(\rho_T=f(s)\) 对一切任务成立。这是第 1 章命题 1.2(Howard [3])在感知语境下的样子,算例 5.2 当场给出反例。
产权。"信息的价值必须由后果定义、不能脱离决策"是 Howard 1966 [3] 的原话。"后悔是感知实验的任务泛函"是第 2 章定理 2.1 与第 3 章引理 3.1 的直接推论。本站在此没有新定理,新意只在把它用作否决三元 region 独立第三轴的理由。
证明(三行)
- (a) 由 \(r_T(\mathcal{E})=\sum_j\psi_T(\mathbf{v}_j)\)(定理 2.1 证明第四步),\(\mathbf{v}_j\) 是 \(\mathcal{E}_{\mathrm{sense}}\) 的第 \(j\) 列按先验加权,故 \(r_T\) 是矩阵 \(\mathbf{P}\) 与任务 \((A_T,L_T,\pi_T)\) 的函数。减去与 \(\mathcal{E}_{\mathrm{sense}}\) 无关的常数 \(r_T(\mathcal{E}_0)\) 即得。
- (b) 定理 2.2 给出 \(r_T(\mathcal{E}_{\mathrm{sense}})\le r_T(\mathcal{E}_0)+\|L_T\|\delta(\mathcal{E}_{\mathrm{sense}},\mathcal{E}_0)\)。
- (c) 见算例 5.2:两个感知实验在一个感知标量上的序与在某个任务上的后悔序相反,故不存在单调的 \(f\)。\(\blacksquare\)
5.2.3 算例:同一对传感器,两个任务#
算例 5.2(同一对传感器、两个任务、两种后悔排序)
两台"传感器"沿用算例 2.2:\(\theta\in\{+1,-1\}\) 等概("目标在 / 不在"),\(\mathcal{E}_{\mathrm{BEC}}=\) BEC(0.6),\(\mathcal{E}_{\mathrm{BSC}}=\) BSC(0.2)。\(\mathcal{E}_0\) 为完美观测。
感知标量
- 互信息:\(0.400\) 对 \(0.278\) 比特,BEC 更好。
- 归一化 MMSE(\(\theta=\pm1\) 约定,除以 4 使损失落在 \([0,1]\)):\(0.60/4=0.15\) 对 \(0.64/4=0.16\),BEC 更好。
两个 MMSE 这样来:
- BEC 以概率 \(0.6\) 擦除。擦除时后验等于先验、条件方差为 \(1\),未擦除时 \(\theta\) 被看准、方差为 \(0\),平均 \(0.60\)。
- BSC 看到 \(y\) 后 \(\theta=y\) 的后验概率是 \(0.8\),条件均值 \(0.8y-0.2y=0.6y\),条件方差 \(\mathbb{E}[\theta^2\mid y]-(0.6y)^2=1-0.36=0.64\)。
**任务甲(0-1 判决,\(\|L_T\|=1\))。**全知风险 0;BEC 风险 \(\epsilon/2=0.30\),BSC 风险 \(q=0.20\)。后悔 \(\rho_{\text{甲}}=0.30\) 对 \(0.20\):BSC 更好,与两个感知标量的序相反。
**任务乙(归一化二次损失 \(L=(\theta-a)^2/4\),动作 \(a\in[-1,1]\))。**全知风险 0;BEC 后悔 \(0.15\),BSC 后悔 \(0.16\):BEC 更好。二次损失下最优动作是条件均值,它落在 \([-1,1]\) 内,所以这里的 Bayes 风险恰是上面的归一化 MMSE。
亏格上界(关键结论 (b))
- BEC 的上界:用 BEC 模拟完美观测,擦除时扔硬币。\(\theta=+1\) 的输出分布 \((0.7,0.3)\) 对目标 \((1,0)\),半 \(L_1\) 距离 \(\tfrac12(0.3+0.3)=0.30\)(\(\theta=-1\) 对称)。亏格是"给 \(\mathcal{E}_{\mathrm{sense}}\) 配一个后处理去模拟 \(\mathcal{E}_0\),最坏状态下输出分布的差距"能压到的最小值,所以这个具体方案给出上界 \(\delta\le0.30\)。
- BEC 的下界:反过来用关键结论 (b)。0-1 任务 \(\|L_T\|=1\),后悔 \(0.30\le\delta\)。两边相夹,\(\delta(\mathcal{E}_{\mathrm{BEC}},\mathcal{E}_0)=0.30\)。
- BSC:同理 \(\delta(\mathcal{E}_{\mathrm{BSC}},\mathcal{E}_0)=0.20\)。直接照抄 BSC 的输出,\((0.8,0.2)\) 对 \((1,0)\) 差 \(0.20\),0-1 后悔 \(0.20\) 给下界。
- 与后悔对照:任务甲的后悔 \(0.30\le0.30\)、\(0.20\le0.20\)(取等)。任务乙的后悔 \(0.15\le0.30\)、\(0.16\le0.20\)(松一倍)。
校验
- (a) 三组数字与算例 2.2、2.3(d) 逐位一致 ✓。
- (b) 后悔非负且不超过亏格上界,四个不等式全部成立 ✓。
- (c) 极限:\(\epsilon\to0\) 时 BEC 两个后悔 \(\to0\)、亏格 \(\to0\)。\(q\to1/2\) 时 BSC 的 0-1 后悔 \(\to0.5\)、亏格 \(\to0.5\),与"一无所知"的判决风险 \(1/2\) 一致 ✓。
- (d) 反例成立的判据:由第 2 章 §2.5 的反转区 \(2q<\epsilon<4q(1-q)\),即 \(0.40<0.60<0.64\) ✓。
算例 5.2 把 §5.2 的判断落到了数字上:同一份感知,换一个任务,"决策轴"上的排序就翻转。
若把 \((R,\epsilon,\rho_T)\) 画成三维图,固定任务 \(T\) 时第三个坐标是前两个的函数(更准确地说,是感知实验本身的函数),三维图塌成一张二维曲面。换任务 \(T\),整张曲面搬家。
所谓"三元 region",只有两种读法:
- 一族随任务索引的二维曲面。那就回到了 ISAC 二维图加第 3 章的任务格。
- 为决策另开一个独立的资源汇。这是 §5.7 猜想 5.5 的前提。
到此为止我们得到了什么
一个否决与一个前提。三元组 \((R,\epsilon,\rho_T)\) 里真正独立的资源汇只有两个:现在传数据,以及认识环境。第三个是估值,由任务映射算出。它受第 2 章风险界控制,不能写成任何感知标量的函数(算例 5.2)。要让三维 region 适定,必须给决策另配一个资源汇。
5.3 母体:对偶控制,动作既调节又探测#
5.3.1 对偶控制是什么#
直觉
你在黑暗里推一扇不知道有多重的门。推得轻,门不动,你也不知道它有多重。推得重,门开了,同时你也知道了它的重量,下次就能推得刚刚好。"推"这个动作有两个后果:它改变门的状态(调节),也改变你对门的认识(探测)。
1960 年 Feldbaum [1] 把这个结构叫对偶控制(dual control)。被控对象的特性未知时,控制器有两个互相冲突的目标:按现有知识做最优控制,以及注入探测扰动去改进未来的知识。原则上最优解可由动态规划求得,但计算上几乎总是不可行。这一点到今天仍然成立(Mesbah 2018 综述 [8])。
无线里处处是这扇门:
- 导频是纯探测:占用资源、不送数据、换来 CSI。
- 数据传输是纯利用。
- ISAC 波形两者兼做。按 Xiong 等的 DRT [11],数据的随机性还会反过来伤害探测。
- 波束扫描更明显:你把波束打向哪里,决定了你能学到哪个方向的环境。
什么时候可以把"调节"和"探测"分开设计?Bar-Shalom–Tse 1974 [2] 给了精确判据,它是本章"认知回路何时非平凡"的唯一严格语言。
5.3.2 对偶效应与确定性等价的判据#
定义 5.2(对偶效应、确定性等价,Bar-Shalom–Tse 1974)【已解决(经典)】
离散时间随机系统,状态 \(x_k\),控制 \(u_k\),观测 \(y_k\);时刻 \(k\) 的信息集 \(I_k=\{y_0,\dots,y_k,u_0,\dots,u_{k-1}\}\)。
(a) 若对一切 \(k\),状态的条件误差协方差 \(\mathbf{P}_{k}:=\mathrm{Cov}(x_k\mid I_k)\) 不依赖于过去的控制 \(u_0,\dots,u_{k-1}\),称系统无(二阶)对偶效应(no dual effect of second order);否则称有对偶效应。
(b) 确定性等价(certainty equivalence,CE)控制:先把未知量换成其条件均值,再按完全信息下的最优控制律行动。分离(separation):最优控制律可以写成"估计器 + 完全信息控制律"的串联。
出处:[2],定义 4 与定理 2【表述待核:原文用"neutral"与"dual effect of order 2"两个术语,本站按"条件协方差不依赖于控制"这一等价说法改写】。
定理(Bar-Shalom–Tse 对偶效应判据)【已解决(经典)】
(i) 若系统无对偶效应,则最优闭环策略退化为反馈策略,决策者不能通过选择控制去改善未来的信息。线性高斯二次(LQG:线性动态、高斯噪声、线性观测、二次代价)系统无对偶效应,且 CE 最优、分离成立。
(ii) 若系统有对偶效应,闭环策略可以"主动自适应"(用控制去探测),反馈策略只能"被动自适应"。一般地 CE 不再最优,分离失效,探测与利用必须联合设计。
出处:[2]。下面给出 (i) 中"LQG 无对偶效应"的标量完整证明,以及 (ii) 的一个数字实例。(i) 的后半句(CE 最优)与 (ii) 的一般陈述见原文。
读这条定理要分清三组词
- **反馈策略与闭环策略。**按 [2] 的用法,反馈策略(feedback policy)只用已经到手的信息 \(I_k\) 做决定,不考虑"以后还会有观测"。闭环策略(closed-loop policy)还把"下一步会看到什么、看得多准"算进当前决策。这与控制课里"闭环 = 有反馈"的日常说法不同。
- **被动自适应与主动自适应。**被动自适应是观测来了顺便更新估计,主动自适应是为了学而故意改变动作。
- **探测与利用。**探测(probing)指为改进未来知识而付出的动作,相当于预备篇 8.1老虎机里的"探索"。利用(exploitation)指按现有知识拿眼前收益。
所以 (i) 的意思是:动作进不了后验方差时,考虑未来观测没有任何好处,闭环退化为反馈,也就用不着探测。
5.3.3 证明与实例#
证明((i) 的标量 LQG 情形,四步)
取标量系统 \(x_{k+1}=a\,x_k+b\,u_k+w_k\),\(y_k=x_k+v_k\),\(w_k\sim\mathcal{N}(0,Q)\),\(v_k\sim\mathcal{N}(0,R)\) 独立,\(a,b,Q,R\) 已知。
记号提醒:本节的 \(Q,R\) 是过程噪声与观测噪声的方差,\(P\) 是误差方差,与 §5.1 的速率 \(R\)、功率 \(P\) 以及第一部问题编号 Q3 都无关。
**第一步:预测步。**给定 \(I_k\),\(x_k\) 的条件分布是高斯,均值 \(\hat x_{k|k}\)、方差 \(P_{k|k}\)。因 \(u_k\) 是 \(I_k\) 的确定函数,\(x_{k+1}=a x_k+b u_k+w_k\) 的条件方差为
这一步做了什么:\(b u_k\) 是已知常数,加常数不改变方差。\(w_k\) 与 \(x_k\) 独立,方差相加。\(u_k\) 只出现在均值里,没出现在方差里。
**第二步:更新步。**观测 \(y_{k+1}=x_{k+1}+v_{k+1}\)。两个联合高斯变量的条件方差公式(预备篇 4.10)给出
这一步做了什么:\(\mathrm{Var}(x\mid y)=\mathrm{Var}(x)-\mathrm{Cov}(x,y)^2/\mathrm{Var}(y)\),其中 \(\mathrm{Cov}(x_{k+1},y_{k+1})=P_{k+1|k}\)、\(\mathrm{Var}(y_{k+1})=P_{k+1|k}+R\)。整个式子里没有 \(u_k\)。
高斯情形的条件方差只由协方差决定、与观测到的具体数值无关,所以 \(u_k\) 虽然挪动了 \(y_{k+1}\) 的取值,却改不了方差。
第三步:归纳。\(P_{0|0}\) 由先验给定,与控制无关。若 \(P_{k|k}\) 与 \(u_0,\dots,u_{k-1}\) 无关,则由第一、二步 \(P_{k+1|k+1}\) 只依赖 \(P_{k|k}\) 与已知常数 \(a,Q,R\),故与 \(u_0,\dots,u_k\) 无关。归纳得对一切 \(k\) 成立。
**第四步:结论。**按定义 5.2(a),系统无对偶效应。\(\square\)
(ii) 的实例
把"未知"从状态换到增益:\(y=\theta u+v\),\(\theta\sim\mathcal{N}(0,\sigma^2)\) 未知,\(v\sim\mathcal{N}(0,R)\)。用第二步同一个条件方差公式:\(\mathrm{Cov}(\theta,y)=u\sigma^2\),\(\mathrm{Var}(y)=u^2\sigma^2+R\),故
分子分母同除以 \(\sigma^2R\),得 \(\theta\) 的后验方差
它依赖于 \(u\):推得越重,知道得越准。这就是对偶效应。
与 LQG 的差别在 \(u\) 进入模型的方式。LQG 里 \(bu_k\) 是加上去的已知平移,只挪均值。这里 \(u\) 乘在未知量 \(\theta\) 上,决定观测对 \(\theta\) 有多敏感。
\(u^2/R\) 正是这次观测的精度,后验精度 = 先验精度 \(1/\sigma^2\) + 观测精度 \(u^2/R\),也就是预备篇 4.10的"精度相加"。\(\blacksquare\)
算例 5.3(对偶效应的最小数字:推门)
取 \(\sigma^2=1\)、\(R=1\)。
- \(u=0\):\(\mathrm{Var}(\theta\mid y)=(1+0)^{-1}=1\)。不推,什么也学不到。
- \(u=1\):\((1+1)^{-1}=0.5\)。
- \(u=2\):\((1+4)^{-1}=0.2\)。
- \(u=3\):\((1+9)^{-1}=0.1\)。
与此对照,标量 LQG(\(a=1,Q=0,R=1\),\(P_{0|0}=1\))里无论 \(u_0\) 取多少,\(P_{1|1}=1\times1/(1+1)=0.5\)。控制进不了方差。
校验
- (a) 后验方差公式用另一条路径复算:把 \(y/u\) 看成 \(\theta\) 的一次带噪观测,噪声方差 \(R/u^2\),两个高斯的精度相加 \(1/\sigma^2+u^2/R\) ✓。
- (b) 极限:\(u\to\infty\) 时方差 \(\to0\)(无穷大的探测把 \(\theta\) 完全测出)。\(u\to0\) 时退回先验 \(\sigma^2\) ✓。
- (c) LQG 情形的 \(P_{1|1}=0.5\) 用第二步公式 \(P R/(P+R)=1\times1/2\) 复算 ✓。
5.3.4 物理意义、ISAC 版对偶效应与谱系#
物理意义
判据把"要不要联合设计"变成一个可以检查的条件:看看你的动作进不进得了后验方差。
导频功率、波束方向、ISAC 波形的随机性都进得了,所以无线里几乎处处有对偶效应。只有在"信道已知、只剩加性高斯噪声"的教科书情形里,探测与利用才能分开。
行为分析
- 对偶效应的强度不是常数。算例 5.3 里 \(u\) 从 1 加到 3,方差从 0.5 降到 0.1,边际收益递减:后验越窄,再探测的收益越小。Baltussen 等 2026 [18]【预印本·未评审】把这一点量化成"分离间隙" \(S_t=\|u_t^{\mathrm{dual}}-u_t^{\mathrm{CE}}\|_2\),经验结论是后验协方差收缩时 \(S_t\to0\)。认知回路的增益随知识积累而消退。§5.4 的 \(\alpha^\star\sim\ln\Lambda/\Lambda\) 是同一件事在稳态下的样子。
- "cognitive"这个词在无线里的原意就是这个回路。Haykin 2006 [7] 的认知雷达有三个要素:与环境交互中学习、接收机到发射机的反馈、贝叶斯跟踪保留回波信息。三者合起来叫感知–行动回路(perception–action cycle)。
定义 5.3(ISAC 版的对偶效应)【本站提法】
把定义 5.2 的"状态"换成环境 / 信道知识(耐用品或易逝品),"控制"换成发射选择 \(u_k\)(导频占比、波束方向、ISAC 波形、数据随机性)。称一个无线系统有 ISAC 版对偶效应,若环境知识的条件协方差 \(\mathbf{P}_{k+1}=\mathrm{Cov}(\theta\mid I_{k+1})\) 依赖于 \(u_k\)。
实例
- (甲)导频:占比越大,CSI 后验方差越小,有。
- (乙)波束扫描:打向哪个方向就学到哪个方向,有。
- (丙)ISAC 数据随机性(DRT [11]):数据越随机,回波越难解,\(\mathbf{P}_{k+1}\) 越大。有,而且是反向的对偶效应(利用伤害探测)。
- (丁)固定导频、信道已知、只剩 AWGN:无。
**产权。**判据本身是 Bar-Shalom–Tse [2] 的,比本站任何叙述都精确。本站只做了"把状态换成环境知识"这一步翻译。
从对偶控制到认知回路:本章工具的谱系
| 年份 | 工作 | 要点 |
|---|---|---|
| 1960 | Feldbaum 对偶控制 I–IV | 动作既调节又探测,最优解原则上可求、计算上不可行 |
| 1966 | Howard 信息价值理论 | 信息的价值必须挂靠决策后果 |
| 1974 | Bar-Shalom–Tse | 对偶效应、确定性等价与分离的形式判据 |
| 1995 | Chaloner–Verdinelli | 贝叶斯实验设计——"测什么"的静态理论 |
| 2002 | Zheng–Tse | 非相干 MIMO 自由度 \(M^*(1-M^*/T)\) |
| 2003 | Hassibi–Hochwald | 多少训练才够——最优训练长度 \(=M\) |
| 2006 | Haykin 认知雷达 | 感知–行动回路,"cognitive" 的原意 |
| 2018 | Mesbah 对偶控制综述 | 主动学习不确定性的随机 MPC |
| 2020 | Liu–Yuan–Masouros–Yuan | 雷达辅助预测波束,感知服务通信 |
| 2021–2024 | Ahmadipour 等、Xiong 等、Hua 等 | 容量–失真、CRB–rate、ST/DRT |
| 2023–2024 | Zeng 等 CKM 教程、Xu–Zeng | 环境知识缓存工程化,"要多少数据" |
| 2026 | 分离间隙(Baltussen 等)与本站 | 后验收缩时对偶增益消退;认知平衡点 |
怎么读这张表:上段(1960–1974)控制论把"动作既调节又探测"写成定理。中段(1995–2006)统计学给出"测什么"的静态理论,无线给出"训练多长"的块内答案,雷达给出"认知"一词的原意。
下段(2018 起)ISAC 基本限、CKM 工程化与对偶控制回潮在同一时期发生,却互不引用。本章做的事是把上段接到下段:认知回路是对偶控制的稳态版本,Hassibi–Hochwald 是它的块内特例。
到此为止我们得到了什么
母体与判据。"感知要花资源、感知换来的知识才让通信与决策变好"这件事,1960 年就有了名字。"什么时候必须联合设计"有精确判据:动作进不进后验方差。无线里几乎处处进得了,所以"认知三角"应当改写成"认知回路"。
5.4 认知回路的最小模型与认知平衡点#
直觉
一家公司每年把一部分预算投给"了解市场"(调研、数据),其余投给"做生意"。了解市场的知识会过时:市场每隔一段时间就变一次,老知识按比例贬值。
投多少给调研?投得太少,生意做得盲目;投得太多,没钱做生意。答案取决于两件事:
- 市场变得多快(知识的折旧率);
- 多一分了解能多赚多少(知识的汇率曲线)。
第二件事的形状决定了答案的量级:多了解一点是一直有用,还是很快就够用了。本节把这段话写成一个可以算数的模型。
5.4.1 模型#
定义 5.4(认知回路最小模型)【本站模型】
时间连续,\(t\ge0\)。
(a) 知识量。\(q(t)\ge0\) 是系统当前持有的环境知识量,单位为比特("用多少比特描述环境",与第 3 章猜想 3.4 同一量纲)。饱和值取猜想 3.4(a) 的天花板 \(q_{\mathrm{sat}}:=R_{\mathrm{ceil}}=d_{\mathrm{eff}}\log_2(1/\varepsilon)\)。
(b) 感知占比。\(\alpha\in[0,1]\) 是长期投给"认识环境"的资源份额(时隙 / 功率 / 孔径的份额),其余 \(1-\alpha\) 用于传数据。
**(c) 获取。**感知资源以速率 \(\kappa\alpha\) 把知识写进 \(q\),\(\kappa>0\)(bit/s)是"全部资源投入感知时的知识获取率"。
(d) 折旧。环境以相干时间 \(T_{\mathrm{env}}\) 变化:知识按 \(q/T_{\mathrm{env}}\) 的速率作废(指数遗忘)。
**(e) 汇率。**持有 \(q\) 比特环境知识时的容量为 \(C_0+\Delta C(q)\),其中 \(C_0\) 是无环境知识的容量,\(\Delta C(\cdot)\) 就是第一部第 9 章的知识汇率曲线 \(\Delta C(R_{\mathrm{env}})\),单调不减、\(\Delta C(0)=0\)。
**(f) 目标。**长期吞吐 \(J(\alpha):=(1-\alpha)\bigl[C_0+\Delta C(q^\star(\alpha))\bigr]\),其中 \(q^\star(\alpha)\) 是 (c)(d) 的稳态。
无量纲数。\(\Lambda:=\kappa T_{\mathrm{env}}/q_{\mathrm{sat}}\),即"一个环境相干期内,全力感知能把知识池灌满几遍"。
**产权与最近亲缘。**据本站检索,文献中未见同形结果。最近的亲缘是 Hassibi–Hochwald [6] 的 \((1-T_\tau/T)\cdot C_{\mathrm{eff}}\) 结构(其定理 3)与 Zheng–Tse [5] 的 \(M^\star(1-M^\star/T)\)(其摘要)。
本站把"训练"换成"环境知识"、把块长换成 \(T_{\mathrm{env}}\)、并引入 \(\Delta C\) 的两族形状,属于新的(玩具级)构造,不可写成已知结果。
记号逐个解释:\(\kappa\) 的量纲是 bit/s,\(T_{\mathrm{env}}\) 是秒,\(q_{\mathrm{sat}}\) 是比特,故 \(\Lambda\) 无量纲。\(C_0\) 与 \(\Delta C\) 同量纲(bit/s/Hz 或任何速率单位,本节归一化 \(C_0=1\))。
先算一个具体的数,再推一般公式
取会议室(算例 3.4):\(q_{\mathrm{sat}}=1.3\times10^{6}\) 比特。
- 假设感知链路全力工作时每秒能写入 \(\kappa=10^{4}\) 比特的环境描述(一个量级估计,见 §5.6)。
- 环境相干时间 \(T_{\mathrm{env}}=1\) 小时 \(=3600\) s(家具级变化)。
则 \(\kappa T_{\mathrm{env}}=3.6\times10^{7}\) 比特,\(\Lambda=3.6\times10^{7}/1.3\times10^{6}=27.7\):一个相干期内全力感知能把知识池灌满约 28 遍。
若只投 \(\alpha=0.1\),稳态知识(下面推)为 \(\kappa\alpha T_{\mathrm{env}}=3.6\times10^{6}\) 比特,是 \(q_{\mathrm{sat}}\) 的 2.8 倍。超出的部分是冗余,饱和型汇率会把它折算成"已经接近饱和"。
5.4.2 稳态:四步#
**第一步:写出微分方程。**由 (c)(d),
这一步说:知识的变化率 = 写入率 − 作废率。
**第二步:找稳态。**令右端为零:\(\kappa\alpha=q^\star/T_{\mathrm{env}}\),
这一步说:稳态知识 = 每秒写入的量 × 一份知识平均能活多久。
**第三步:验证稳态是吸引的。**令 \(e(t):=q(t)-q^\star\),则 \(\dot e=-e/T_{\mathrm{env}}\),解为 \(e(t)=e(0)e^{-t/T_{\mathrm{env}}}\),故
这一步说:无论从多少知识起步,一两个相干期后系统就在 \(q^\star\) 附近。长期吞吐只看 \(q^\star\)。
第四步:无量纲化。\(q^\star/q_{\mathrm{sat}}=\kappa\alpha T_{\mathrm{env}}/q_{\mathrm{sat}}=\Lambda\alpha\)。于是
5.4.3 认知平衡点:一阶条件#
认知平衡点就是让长期吞吐最大的感知占比 \(\alpha^\star:=\arg\max_{\alpha\in[0,1]}J(\alpha)\)。
叫它"平衡点",是因为在 \(\alpha^\star\) 处,把最后一点资源投给认识环境与投给传数据,收益恰好相等。下面的命题把这句话写成等式。
命题 5.1(认知平衡点的一阶条件)【本站演算】
设 \(\Delta C\) 在 \((0,\infty)\) 上可微。若 \(\alpha^\star\in(0,1)\) 是 \(J(\alpha)\) 的内点极大值,则
读法:左边是"多投一单位资源去认识环境,换来的容量增量(乘以剩余的传输份额)",右边是"这一单位资源若拿去传数据能换的容量"。平衡点就是两者相等之处。
若 \(\Delta C\) 还是单调不减的凹函数,且 \(\Delta C'(0^+)\kappa T_{\mathrm{env}}\le C_0\),则 \(\alpha^\star=0\)(不值得永久感知)。
凹性不能省:先凸后凹的 S 形曲线在 \(0^+\) 处斜率可以为零,最优点却可以在内部,§5.5 的阈值跳变就是它的极端情形。
证明(三步)
第一步:把 \(J\) 写成两个因子的乘积并求导。\(J(\alpha)=u(\alpha)\,v(\alpha)\),\(u=1-\alpha\),\(v=C_0+\Delta C(\kappa\alpha T_{\mathrm{env}})\)。这里 \(u,v\) 是临时记号,与 §5.3 的控制 \(u\) 无关。下文的 \(q^\star\) 指任意 \(\alpha\) 下的稳态 \(q^\star(\alpha)=\kappa\alpha T_{\mathrm{env}}\),不只是最优点处的值。乘积法则:
这一步做了什么:\(u'=-1\) 是"多感知一分就少传一分"。第二项是"多感知一分换来的容量"。
第二步:链式法则。\(\frac{\mathrm{d}}{\mathrm{d}\alpha}\Delta C(\kappa\alpha T_{\mathrm{env}})=\Delta C'(q^\star)\cdot\frac{\mathrm{d}q^\star}{\mathrm{d}\alpha}=\Delta C'(q^\star)\,\kappa T_{\mathrm{env}}\)。代入:
这一步做了什么:把"对 \(\alpha\) 求导"换成"对知识量求导再乘上知识量对 \(\alpha\) 的斜率 \(\kappa T_{\mathrm{env}}\)"。
**第三步:内点极值的必要条件。**内点极大值处 \(J'(\alpha^\star)=0\),移项即得命题的等式。
若 \(J'(0^+)=\Delta C'(0^+)\kappa T_{\mathrm{env}}-C_0\le0\) 且 \(J'\) 在 \((0,1)\) 上单调不增(下面两族都如此),则 \(J'\) 处处非正,\(J\) 在 \([0,1]\) 上不增,最大值在 \(\alpha=0\)。
为什么两族的 \(J'\) 都单调不增:只要 \(\Delta C\) 单调不减且凹,\(\Delta C'\) 就非负且随 \(q\) 递减。于是 \(J'\) 的第一项 \((1-\alpha)\Delta C'(q^\star)\kappa T_{\mathrm{env}}\) 是两个非负的递减因子之积,单调不增。第二项 \(-[C_0+\Delta C(q^\star)]\) 也单调不增。\(J'\) 单调不增,\(J'(0^+)\le0\) 就推出处处 \(\le0\)。
饱和型正是这种情形(推论 5.2 第二步)。幂律型的 \(\Delta C'(0^+)=+\infty\),根本落不到这个情形。\(\blacksquare\)
物理意义
一阶条件是一条等边际原理:最后一单位资源,投给"认识环境"与投给"传数据"要一样值钱。
左边多了一个因子 \(\kappa T_{\mathrm{env}}\),可以叫它知识的"杠杆":写得快(\(\kappa\) 大)或活得久(\(T_{\mathrm{env}}\) 长),同样一份资源换来更多稳态知识。
这就是第一部第 9 章"耐用品摊销"的定理化。耐用品之所以便宜,是因为 \(T_{\mathrm{env}}\) 把一次投入摊到了整个相干期。
行为分析
等式两边都依赖 \(\Delta C\) 的形状:左边是斜率 \(\Delta C'\),右边是水平 \(\Delta C\)。
- 若 \(\Delta C\) 很快饱和,斜率在 \(q^\star\) 稍大处就趋于零,\(\alpha^\star\) 必须很小。
- 若 \(\Delta C\) 一直在涨,斜率不消失,\(\alpha^\star\) 可以很大。
两族形状,两种结论,下面分别算。
为什么是这两族
第一部第 9 章给"CKM 的香农曲线"的中段列了三条候选:凹增、阈值跳变、早饱和。这里取两个能解析求解、又分处两端的函数族:
- 指数饱和族 \(\Delta C_{\max}(1-e^{-q/q_{\mathrm{sat}}})\) 代表"早饱和":知识攒到 \(q_{\mathrm{sat}}\) 的几倍之后再多也几乎不值钱。
- 幂律族 \(c\,(q/q_{\mathrm{sat}})^{\beta}\) 是"凹增"的理想化:边际收益递减,但在所关心的范围内不封顶(真实曲线终会饱和,见算例 5.5 校验 (e))。
阈值跳变留到 §5.5,它恰好对应训练理论。两族都满足 \(\Delta C(0)=0\)、单调增、凹,命题 5.1 可以直接套用。
5.4.4 形状一:饱和型汇率#
推论 5.2(饱和型汇率的认知平衡点)【本站演算】
取 \(\Delta C(q)=\Delta C_{\max}\bigl(1-e^{-q/q_{\mathrm{sat}}}\bigr)\)。则
(a) 阈值。\(\alpha^\star=0\) 当且仅当 \(\Lambda\le\Lambda_c:=C_0/\Delta C_{\max}\)。
(b) 唯一性。\(\Lambda>\Lambda_c\) 时 \(J\) 在 \((0,1)\) 内有唯一驻点,且为全局最大值。
(c) 精确不动点。\(\alpha^\star\) 是方程
在 \((0,1)\) 内的唯一解。
(d) 大 \(\Lambda\) 闭式。
故 \(\alpha^\star\to0\),且按 \(\ln\Lambda/\Lambda\) 消失。
证明
第一步:写出 \(J'\)。\(\Delta C'(q)=(\Delta C_{\max}/q_{\mathrm{sat}})e^{-q/q_{\mathrm{sat}}}\),故 \(\Delta C'(q^\star)\kappa T_{\mathrm{env}}=\Delta C_{\max}\Lambda e^{-\Lambda\alpha}\)。命题 5.1 第二步给出
这一步做了什么:把 \(\kappa T_{\mathrm{env}}/q_{\mathrm{sat}}\) 合并成 \(\Lambda\),\(q^\star/q_{\mathrm{sat}}\) 合并成 \(\Lambda\alpha\)。
第二步:单调性。\(A(\alpha)\) 是两个正的严格减函数 \(e^{-\Lambda\alpha}\) 与 \(1-\alpha\) 之积,严格减。\(B(\alpha)\) 因 \(1-e^{-\Lambda\alpha}\) 递增而严格增。故 \(J'=A-B\) 在 \([0,1]\) 上严格减。\(J'(1)=0-[C_0+\Delta C_{\max}(1-e^{-\Lambda})]<0\)。
这一步做了什么:\(J'\) 严格减意味着 \(J\) 先增后减(或一直减),最多一个驻点。
第三步:(a) 与 (b)。\(J'(0)=\Delta C_{\max}\Lambda-C_0\)。
- 若 \(\Lambda\le C_0/\Delta C_{\max}\),则 \(J'(0)\le0\),由严格减 \(J'<0\) 于 \((0,1]\),\(J\) 递减,\(\alpha^\star=0\)。
- 若 \(\Lambda>C_0/\Delta C_{\max}\),则 \(J'(0)>0>J'(1)\),由连续与严格减恰有一个零点 \(\alpha^\star\in(0,1)\)。其左 \(J'>0\)、其右 \(J'<0\),故为全局最大。\(\square\)
**第四步:(c)。**令 \(J'(\alpha)=0\):\(\Delta C_{\max}\Lambda e^{-\Lambda\alpha}(1-\alpha)=C_0+\Delta C_{\max}-\Delta C_{\max}e^{-\Lambda\alpha}\)。把含 \(e^{-\Lambda\alpha}\) 的项移到一边:
两边取对数、除以 \(-\Lambda\),得 (c)。\(\square\)
这一步做了什么:只是代数移项。注意右边的分母里仍含 \(\alpha\),所以是不动点方程,不是闭式。
**第五步:(d)。**记 \(\alpha_0:=\frac1\Lambda\ln\frac{\Delta C_{\max}\Lambda}{C_0+\Delta C_{\max}}\)。(c) 的右端与 \(\alpha_0\) 之差为
先确认 \(\alpha^\star\) 确实小。(c) 的对数里 \(1-\alpha+1/\Lambda\le1+1/\Lambda\),而 \(\ln(1+x)\le x\),故 \(\alpha^\star\le\alpha_0+1/\Lambda^{2}=O(\ln\Lambda/\Lambda)\)。
于是可以对对数做一阶展开:\(\ln(1+x)=x+O(x^2)\),取 \(x=-\alpha+1/\Lambda\),得 \(\ln(1-\alpha+1/\Lambda)=-\alpha+1/\Lambda+O(\alpha^2+1/\Lambda^2)\)。代回 (c),在 \(\alpha=\alpha^\star\) 处:
这一步做了什么:把 (c) 的右端拆成不含 \(\alpha\) 的主项 \(\alpha_0\) 与一个量级为 \(1/\Lambda\) 倍的修正。
把含 \(\alpha^\star\) 的项移到左边:\(\alpha^\star(1+1/\Lambda)=\alpha_0+1/\Lambda^2+\dots\)。两边除以 \(1+1/\Lambda\),用 \(1/(1+1/\Lambda)=1-1/\Lambda+O(1/\Lambda^2)\),得 \(\alpha^\star=\alpha_0(1-1/\Lambda)+O(1/\Lambda^{2})\)。
最后,\(\alpha_0/\Lambda\) 与 \(1/\Lambda^2\) 都是 \(O(\ln\Lambda/\Lambda^{2})\),故 \(\alpha^\star=\alpha_0+O(\ln\Lambda/\Lambda^{2})\)。\(\blacksquare\)
算例 5.4(饱和型:三组 \(\Lambda\) 的数值最优与闭式近似)
取 \(C_0=1\)、\(\Delta C_{\max}=0.5\)(环境全知最多把容量提高 50%)。阈值 \(\Lambda_c=1/0.5=2\)。
闭式 (d) 化为 \(\alpha_0=\ln(\Lambda/3)/\Lambda\),因为 \(\Delta C_{\max}/(C_0+\Delta C_{\max})=0.5/1.5=1/3\)。
表中各列的算法:
- "数值最优"一列是 (c) 的不动点。
- \(J(\alpha^\star)\) 一列把它代回 \(J(\alpha)=(1-\alpha)\bigl[1+0.5(1-e^{-\Lambda\alpha})\bigr]\),例如 \(\Lambda=10\) 时 \(0.8815\times\bigl[1+0.5\times(1-0.3058)\bigr]=0.8815\times1.3471=1.1875\)。
- 增益一列就是 \(J(\alpha^\star)-1\)。
| \(\Lambda\) | 闭式 \(\alpha_0=\ln(\Lambda/3)/\Lambda\) | 数值最优 \(\alpha^\star\)((c) 的不动点) | \(J(\alpha^\star)\) | 相对 \(J(0)=1\) 的增益 |
|---|---|---|---|---|
| 10 | \(\ln3.333/10=1.2040/10=\mathbf{0.1204}\) | \(\mathbf{0.1185}\) | 1.1875 | +18.7% |
| 100 | \(\ln33.33/100=3.5066/100=\mathbf{0.0351}\) | \(\mathbf{0.0348}\) | 1.4329 | +43.3% |
| 1000 | \(\ln333.3/1000=5.8091/1000=\mathbf{0.0058}\) | \(\mathbf{0.0058}\) | 1.4898 | +49.0% |
不动点迭代(\(\Lambda=10\),两轮)
- 第一轮:从 \(\alpha_0=0.1204\) 起,\(\Lambda(1-\alpha)+1=10\times0.8796+1=9.796\),\(0.5\times9.796/1.5=3.265\),\(\ln3.265=1.1834\),\(\alpha=0.1183\)。
- 第二轮:\(10\times0.8817+1=9.817\),\(0.5\times9.817/1.5=3.272\),\(\ln3.272=1.1855\),\(\alpha=0.1186\)。
收敛到 \(0.1185\)。
这一步做了什么:把当前的 \(\alpha\) 代入 (c) 的右端,算出的值当作新的 \(\alpha\)。
收敛这么快,是因为右端对 \(\alpha\) 的导数只有 \(-1/[\Lambda(1-\alpha)+1]\approx-0.10\):每一轮误差缩到约十分之一并改变符号,所以迭代值在 \(0.1185\) 两侧来回(\(0.1204\to0.1183\to0.1186\)),两轮就到四位精度。
校验
- (a) 代回一阶条件(\(\Lambda=10\),\(\alpha^\star=0.1185\)):左边 \(A=0.5\times10\times e^{-1.185}\times0.8815=5\times0.3058\times0.8815=1.348\),右边 \(B=1+0.5\times(1-0.3058)=1.347\)。差 \(0.001\),在四位舍入内相等 ✓。\(\Lambda=100\),\(\alpha^\star=0.0348\):\(A=50\times e^{-3.48}\times0.9652=50\times0.03080\times0.9652=1.486\),\(B=1+0.5\times(1-0.0308)=1.485\) ✓。
- (b) 用 \(J\) 的直接搜索复算:在 \([0,1]\) 上以 \(10^{-6}\) 步长最大化 \(J\),得 \(0.1185/0.0348/0.0058\),与不动点解一致 ✓。
- (c) 近似误差的量级:(d) 预言 \(\alpha_0-\alpha^\star\approx\alpha_0/\Lambda\)。\(\Lambda=10\) 处 \(0.1204/10=0.012\) 对实际差 \(0.0019\),同量级,因为还有 \(+1/\Lambda^2=0.01\) 的抵消项:\(0.1204\times0.9+0.01=0.1184\) ✓。\(\Lambda=100\) 处 \(0.0351\times0.99+0.0001=0.0348\) ✓。
- (d) 两端极限:\(\Lambda\to\infty\) 时 \(\alpha^\star\to0\)(环境不变,一次建库永久受益)。\(\Lambda\le2\) 时 \(\alpha^\star=0\)(环境变得比你学得快,攒不下知识)。中间必有峰,数值上峰在 \(\Lambda\approx6.9\),\(\alpha^\star\approx0.124\) ✓。
- (e) 增益的饱和:\(J(\alpha^\star)\) 随 \(\Lambda\) 趋于 \(C_0+\Delta C_{\max}=1.5\),\(\Lambda=1000\) 时已达 \(1.49\) ✓。
5.4.5 形状二:幂律型汇率#
推论 5.3(幂律型汇率的认知平衡点)【本站演算】
取 \(\Delta C(q)=c\,(q/q_{\mathrm{sat}})^{\beta}\),\(c>0\)、\(0<\beta<1\)。则
(a) 对一切 \(\Lambda>0\),\(\alpha^\star\in(0,1)\) 存在、唯一、为全局最大。没有阈值,总值得感知。
(b) 精确不动点。
(c) 极限。\(\alpha^\star\) 随 \(\Lambda\) 严格增,且 \(\lim_{\Lambda\to\infty}\alpha^\star=\beta/(1+\beta)\),与 \(T_{\mathrm{env}}\) 无关。
证明
第一步:\(J'\) 的因式分解。\(\Delta C'(q)\kappa T_{\mathrm{env}}=c\beta(q/q_{\mathrm{sat}})^{\beta-1}\Lambda=c\beta\Lambda^{\beta}\alpha^{\beta-1}\)。命题 5.1 第二步:
这一步做了什么:提出公因子 \(c(\Lambda\alpha)^\beta>0\),于是 \(J'\) 的符号由方括号 \(F(\alpha)\) 决定。
第二步:\(F\) 在每个零点处下穿,由此得 (a)。\(\beta(1-\alpha)/\alpha\) 严格减。\(-C_0/(c\Lambda^\beta\alpha^\beta)\) 随 \(\alpha\) 严格增(负号翻转了 \(\alpha^{-\beta}\) 的递减)。所以 \(F\) 是"严格减 + 严格增",需要小心。
先看两端。改写第一项与第三项:
- 当 \(\alpha\to0^+\):\(\beta/\alpha\) 以 \(\alpha^{-1}\) 发散,第三项以 \(\alpha^{-\beta}\) 发散,但 \(\beta<1\),故 \(F\to+\infty\)。
- 当 \(\alpha=1\):\(F(1)=-1-C_0/(c\Lambda^\beta)<0\)。
再看 \(F\) 的导数:
在 \(F\) 的任何零点处,由 \(F=0\) 得 \(C_0c^{-1}\Lambda^{-\beta}\alpha^{-\beta}=\beta/\alpha-\beta-1\),故 \(C_0c^{-1}\Lambda^{-\beta}\alpha^{1-\beta}=\beta-(\beta+1)\alpha<\beta<1\)。于是 \(F'<0\):\(F\) 在每个零点处都是下穿。
连续函数从 \(+\infty\) 到负值且在零点只能下穿,零点唯一。左侧 \(J'>0\)、右侧 \(J'<0\),全局最大。\(\square\)
这一步做了什么:不直接证 \(F\) 单调(它未必单调),而证"每个零点都是下穿",这足以保证唯一。
为什么足够
假如有两个零点 \(z_1<z_2\)。
- \(F'(z_1)<0\),所以 \(F\) 在 \(z_1\) 右侧紧邻处为负。
- \(F'(z_2)<0\),所以 \(F\) 在 \(z_2\) 左侧紧邻处为正。
令 \(z_3:=\inf\{\alpha>z_1:F(\alpha)>0\}\),则 \(z_1<z_3<z_2\),由连续性 \(F(z_3)=0\),且 \(F\) 在 \((z_1,z_3)\) 上 \(\le0\)。可 \(F'(z_3)<0\) 要求 \(F\) 在 \(z_3\) 左侧紧邻处为正,矛盾。
零点的存在则来自介值定理:\(F\) 从 \(+\infty\) 连续地走到 \(F(1)<0\)。
第三步:(b)。\(F(\alpha^\star)=0\) 即 \(\beta(1-\alpha^\star)/\alpha^\star=1+C_0/(c(\Lambda\alpha^\star)^\beta)\)。两边乘 \(\alpha^\star\):\(\beta-\beta\alpha^\star=\alpha^\star\bigl[1+C_0/(c(\Lambda\alpha^\star)^\beta)\bigr]\),故 \(\alpha^\star\bigl[1+\beta+C_0/(c(\Lambda\alpha^\star)^\beta)\bigr]=\beta\)。取 \(C_0=1\) 即 (b)。\(\square\)
**第四步:(c) 的单调性与极限。**先看上界:(b) 的分母大于 \(1+\beta\),故 \(\alpha^\star<\beta/(1+\beta)\) 恒成立。
再看单调。固定 \(\alpha\),\(F\) 的第三项 \(-C_0c^{-1}\Lambda^{-\beta}\alpha^{-\beta}\) 随 \(\Lambda\) 严格增,故 \(\Lambda_1<\Lambda_2\) 时 \(F_{\Lambda_2}(\alpha)>F_{\Lambda_1}(\alpha)\) 对一切 \(\alpha\) 成立。在 \(\alpha^\star(\Lambda_1)\) 处 \(F_{\Lambda_2}>F_{\Lambda_1}=0\)。由第二步,\(F_{\Lambda_2}\) 在它唯一零点的左侧为正、右侧为负,所以 \(\alpha^\star(\Lambda_1)\) 落在该零点左侧,即 \(\alpha^\star(\Lambda_2)>\alpha^\star(\Lambda_1)\),严格增。
最后求极限。单调有界故有极限 \(\bar\alpha\),且 \(\bar\alpha\ge\alpha^\star(\Lambda_1)>0\),于是 \(\Lambda\alpha^\star\to\infty\)。记 \(\varepsilon(\Lambda):=1/(c(\Lambda\alpha^\star)^\beta)\)。它是 (b) 分母里那一项的简写,与 \(q_{\mathrm{sat}}\) 里的精度 \(\varepsilon\) 无关。于是 \(\varepsilon\to0\),(b) 给出 \(\bar\alpha=\beta/(1+\beta)\)。\(\blacksquare\)
算例 5.5(幂律型:\(\Lambda=100\) 的数值最优与极限 \(1/3\))
取 \(c=0.5\)、\(\beta=1/2\)、\(C_0=1\)。极限 \(\beta/(1+\beta)=0.5/1.5=\mathbf{1/3}\)。
| \(\Lambda\) | \(\alpha^\star\) | \(\Lambda\alpha^\star=q^\star/q_{\mathrm{sat}}\) | \(\Delta C(q^\star)=0.5\sqrt{\Lambda\alpha^\star}\) | \(J(\alpha^\star)\) |
|---|---|---|---|---|
| 10 | \(\mathbf{0.163}\) | 1.63 | 0.64 | 1.371 |
| 100 | \(\mathbf{0.265}\) | 26.5 | 2.57 | 2.627 |
| 1000 | \(\mathbf{0.310}\) | 310 | 8.80 | 6.764 |
| \(\to\infty\) | \(\to1/3\) | \(\to\infty\) | \(\to\infty\) | \(\to\infty\) |
不动点(\(\Lambda=100\))
把数值解 \(\alpha^\star=0.2647\)(\(\Lambda\alpha^\star=26.47\))代回推论 5.3(b) 的右端,看它能否把自己还原出来:\(\varepsilon=1/(0.5\sqrt{26.47})=1/(0.5\times5.145)=0.3887\),\(\alpha=0.5/(1.5+0.3887)=0.5/1.8887=0.2647\) ✓。
数值解本身可以从极限值 \(1/3\) 出发,反复代入 (b) 的右端求得:\(0.3333\to0.2708\to0.2653\to0.2648\to0.2647\)。
校验
- (a) 代回一阶条件(\(\Lambda=100\),\(\alpha^\star=0.2647\)):\(\beta(1-\alpha)/\alpha=0.5\times0.7353/0.2647=1.389\),\(1+1/(c(\Lambda\alpha)^\beta)=1+0.3887=1.389\) ✓。
- (b) \(J\) 的直接搜索:以 \(10^{-6}\) 步长最大化 \((1-\alpha)[1+0.5\sqrt{100\alpha}]\),得 \(0.2647\) ✓。
- (c) 与极限对照:\(0.265/0.333=0.79\),\(\Lambda=1000\) 时 \(0.310/0.333=0.93\),\(\Lambda=10^{6}\) 时 \(0.3326\),单调逼近 \(1/3\) ✓。
- (d) 极限公式的独立推导:\(\Lambda\to\infty\) 时略去 \(\varepsilon\),\(J\approx(1-\alpha)c\Lambda^{\beta}\alpha^{\beta}\),对 \(\alpha\) 求导 \(\propto\beta\alpha^{\beta-1}(1-\alpha)-\alpha^\beta=\alpha^{\beta-1}[\beta-(1+\beta)\alpha]\),零点 \(\alpha=\beta/(1+\beta)\) ✓。
- (e) 物理性提醒:\(\Lambda=100\) 时 \(q^\star=26.5\,q_{\mathrm{sat}}\),\(\Delta C=2.57\,C_0\)。幂律族在此处已越过猜想 3.4 的天花板,物理上不再合理。它描述的是"在所关心的范围内汇率一直在涨"这一理想化,真实曲线必在某处饱和。两族形状是真实曲线的两个包络,本算例的用途是显示答案对形状的敏感度,不是预言 26.5% 本身。
关键结论:认知平衡点由 Q3 曲线的形状决定【本站提法·可证伪预言】
同一个 \(\Lambda=100\)("一个相干期内能把知识池灌满一百遍"):
- 饱和型汇率 \(\Rightarrow\) \(\alpha^\star=3.5\%\),且随 \(T_{\mathrm{env}}\) 按 \(\ln\Lambda/\Lambda\) 消失;
- 幂律型汇率 \(\Rightarrow\) \(\alpha^\star=26.5\%\),且随 \(T_{\mathrm{env}}\) 趋于常数 \(\beta/(1+\beta)\)。
两者差一个数量级。\(\Lambda\) 大 \(\ne\) 少感知,要看 \(\Delta C\) 会不会饱和。
第一部第 9 章"CKM 的香农曲线"两端点已知、中段形状未知(凹增 / 阈值跳变 / 早饱和三条候选)。本章把这个未知翻译成工程量的未知:
- 数字孪生该多久同步一次;
- CKM 该分多少测量给建库;
- ISAC 波形该留多少给探测。
Q3 不解,这些数就没有定理,只有启发式。
可证伪判据
在一个可以人为改变环境变化率的试验台(数字孪生仿真、可移动散射体的暗室)上,测量"吞吐最优的感知占比"随 \(T_{\mathrm{env}}\) 的变化:
- 若按 \(1/T_{\mathrm{env}}\)(乘一个对数)衰减,Q3 曲线在该场景饱和;
- 若趋于一个与 \(T_{\mathrm{env}}\) 无关的常数,Q3 曲线在该范围内仍是幂律增长。
证据现状:截至 2026 年 9 月,据本站检索,文献中没有任何直接给出 \(\Delta C\)(容量增益对环境信息量)曲线的 CKM 仿真数字。Xu–Zeng [15] 给的是地图精度(AMSE)对采样密度,不是容量增益。感知辅助波束"节省 93% 训练开销"[17] 是感知已就绪时的增益,不是 \(\Delta C\) 的标定值。所以这条结论是本站模型的预言,不是已被数据支持的事实。
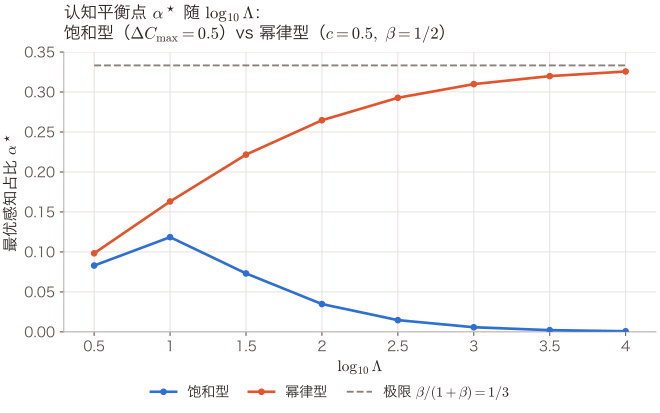
怎么读这张图:横轴是 \(\log_{10}\Lambda\)(环境越静、感知越快,\(\Lambda\) 越大)。下方先升后降的曲线是饱和型:\(\Lambda\le2\) 处为零(图外),峰在 \(\Lambda\approx7\),随后按 \(\ln\Lambda/\Lambda\) 归零。中间单调上升的曲线是幂律型,逼近上方水平线 \(\beta/(1+\beta)=1/3\)。
两条曲线在 \(\log_{10}\Lambda=2\) 处相差 \(0.265/0.035\approx7.6\) 倍,在 \(\log_{10}\Lambda=4\) 处相差 400 倍。数据点由推论 5.2(c) 与推论 5.3(b) 的不动点方程逐点解出(算例 5.4、5.5),全部是本站模型的输出,不是文献数字。
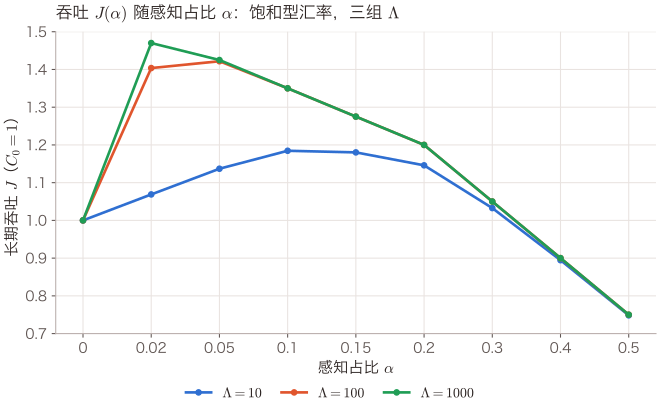
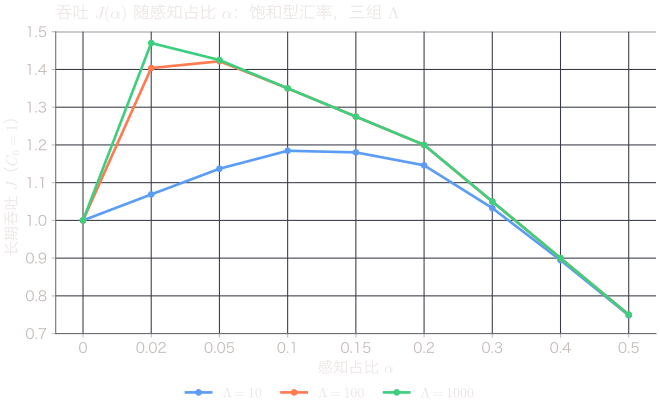
怎么读这张图:三条曲线自下而上对应 \(\Lambda=10,100,1000\),都从 \(J(0)=1\)(不感知)出发。\(\Lambda=10\) 的峰在 \(\alpha\approx0.12\)、高度 1.19。\(\Lambda=100\) 的峰在 \(0.035\)、高度 1.43。\(\Lambda=1000\) 的峰几乎贴着纵轴(\(0.006\))、高度 1.49。
\(\Lambda\) 越大,峰越靠左、越高:一次投入换来更多,也更快饱和。\(\alpha\ge0.1\) 之后三条曲线几乎重合:知识早已饱和,多感知只是少传数据,\(J\approx1.5(1-\alpha)\)。数据由 \(J(\alpha)=(1-\alpha)[1+0.5(1-e^{-\Lambda\alpha})]\) 逐点算出。
flowchart TB
    S["感知资源份额 $$\alpha$$<br/>(导频 / 波束扫描 /<br/>ISAC 探测)"] -->|"获取率 $$\kappa\alpha$$"| Q["环境知识 $$q(t)$$<br/>稳态 $$q^\star=\kappa\alpha T_{\mathrm{env}}$$"]
    Q -->|"折旧 $$q/T_{\mathrm{env}}$$"| Q
    Q -->|"Q3 汇率曲线 $$\Delta C(q)$$"| C["容量 $$C_0+\Delta C(q^\star)$$"]
    C -->|"乘以传输份额 $$(1-\alpha)$$"| J["长期吞吐 $$J(\alpha)$$"]
    J -->|"一阶条件(命题 5.1)"| S
    T["环境相干时间 $$T_{\mathrm{env}}$$<br/>(行人 s · 家具 h–d ·<br/>建筑 月–年)"] -.-> Q
    K["知识天花板<br/>$$q_{\mathrm{sat}}=d_{\mathrm{eff}}\log_2(1/\varepsilon)$$<br/>(第 3 章猜想 3.4)"] -.-> C
    M["例行测量<br/>(RRM 上报 · 空闲态测量 · MDT)"] -.->|"$$\kappa_0$$,不占 $$\alpha$$"| Q
怎么读这张图:实线是回路本身:感知 → 知识 → 汇率 → 容量 → 资源 → 感知。它与 Haykin 的感知–行动回路 [7] 同形,只是每条边都标了本章模型里的量。
三条虚线是外生的:\(T_{\mathrm{env}}\) 决定折旧(§5.6 把它拆成三层),\(q_{\mathrm{sat}}\) 决定汇率曲线的横轴刻度,例行测量带来一条不占 \(\alpha\) 的知识流 \(\kappa_0\)(下一小节)。回路的"增益"由 \(\Delta C\) 那条边的形状决定,这就是本站与第一部 Q3 的接口。
5.4.6 加一条免费的知识流:例行测量不占感知份额#
上面的模型把"认识环境"全部记在 \(\alpha\) 的账上,好像每一比特环境知识都要从传数据的资源里挤出来。实际的网络不是这样。
终端本来就一直在测:
- 连接态要做 RRM 测量并上报;
- 空闲态要为小区重选测量;
- 运维还会让终端顺手记下带位置的测量(最小化路测,MDT)。
一条 RSRP 从测到报到被记下来的全过程,见预备篇第 6 章"一条 RSRP 的一生"。这些测量为了别的目的照做不误,顺带就把一部分环境知识写进了库里,不占 \(\alpha\)。
真实的代价多半出在别处:把测量汇聚起来、存下来、算成地图,以及跨系统的信令。预备篇第 11 章算过一笔存储账。
把这条免费的流记作 \(\kappa_0\ge0\)(bit/s),定义 5.4(c) 的获取项改成 \(\kappa_0+\kappa\alpha\):
稳态的推导与前面的四步完全相同,只是写入率多了一个常数。与 \(\Lambda\) 对应,记 \(\Lambda_0:=\kappa_0T_{\mathrm{env}}/q_{\mathrm{sat}}\):一个环境相干期内,免费流自己能把知识池灌满几遍。
命题 5.1′(加上被动知识流的认知平衡点)【本站演算】
设 \(\Delta C\) 可微、单调不减且凹,\(J(\alpha)=(1-\alpha)\bigl[C_0+\Delta C(q^\star(\alpha))\bigr]\),\(q^\star(\alpha)=(\kappa_0+\kappa\alpha)T_{\mathrm{env}}\)。
(a) 不值得主动感知的条件。\(\alpha^\star=0\) 当且仅当
**(b) 饱和型汇率的门槛。**取 \(\Delta C(q)=\Delta C_{\max}(1-e^{-q/q_{\mathrm{sat}}})\),\(\Lambda>\Lambda_c\)。则 \(\alpha^\star=0\) 当且仅当
\(\Lambda_0<\Lambda_0^\star\) 时,\(\alpha^\star\) 是方程 \(\Lambda_0+\Lambda\alpha=\ln\dfrac{\Delta C_{\max}\bigl(\Lambda(1-\alpha)+1\bigr)}{C_0+\Delta C_{\max}}\) 在 \((0,1)\) 内的唯一解。
证明
命题 5.1 的第一、二步原样适用,只是 \(q^\star\) 多了常数项,求导时 \(\mathrm{d}q^\star/\mathrm{d}\alpha\) 仍是 \(\kappa T_{\mathrm{env}}\):
(a) 的推导。\(\Delta C\) 单调不减且凹,\(J'\) 的第一项是两个非负递减因子之积,第二项也递减,所以 \(J'\) 在 \([0,1]\) 上单调不增。于是 \(J'(0)\le0\) 推出处处 \(J'\le0\),\(\alpha^\star=0\)。反过来 \(J'(0)>0\) 时 \(J\) 在 \(0\) 右侧上升,\(\alpha^\star>0\)。\(J'(0)\le0\) 写出来就是 (a)。
**(b) 的推导。**代入饱和族,\(\Delta C'(q)\kappa T_{\mathrm{env}}=\Delta C_{\max}\Lambda e^{-q/q_{\mathrm{sat}}}\),\(J'(0)\le0\) 化为 \(\Delta C_{\max}\Lambda e^{-\Lambda_0}\le C_0+\Delta C_{\max}(1-e^{-\Lambda_0})\)。把含 \(e^{-\Lambda_0}\) 的项移到左边:\(e^{-\Lambda_0}\Delta C_{\max}(\Lambda+1)\le C_0+\Delta C_{\max}\),取对数即得门槛。
内点情形令 \(J'(\alpha)=0\),照推论 5.2 第四步移项、取对数,得到 (b) 的方程。\(\blacksquare\)
读法
(b) 的方程左边是总量 \(\Lambda_0+\Lambda\alpha\),也就是稳态知识按 \(q_{\mathrm{sat}}\) 计的倍数。右边只通过 \(1-\alpha\) 依赖 \(\alpha\),而 \(\alpha\) 本来就只有几个百分点,右边几乎是常数。
所以最优的总知识量几乎不随 \(\Lambda_0\) 变:免费流来多少,主动探测就让出多少,直到免费流单独就超过原来的最优量,主动探测归零。
数值
沿用算例 5.4 的口径 \(C_0=1\)、\(\Delta C_{\max}=0.5\)。\(\Lambda=100\) 时门槛 \(\Lambda_0^\star=\ln(50.5/1.5)=3.52\)。会议室那组 \(\Lambda=27.7\) 时 \(\Lambda_0^\star=\ln(14.35/1.5)=2.26\)。
| \(\Lambda_0\) | \(\Lambda=100\):\(\alpha^\star\) | 主动量 \(\Lambda\alpha^\star\) | 总量 \(\Lambda_0+\Lambda\alpha^\star\) | \(J(\alpha^\star)\) | \(\Lambda=27.7\):\(\alpha^\star\) |
|---|---|---|---|---|---|
| 0 | 3.48% | 3.48 | 3.48 | 1.433 | 7.87% |
| 1 | 2.49% | 2.49 | 3.49 | 1.448 | 4.39% |
| 2 | 1.50% | 1.50 | 3.50 | 1.463 | 0.90% |
| 3 | 0.51% | 0.51 | 3.51 | 1.478 | 0(已过门槛) |
怎么读这张表:第一行就是算例 5.4 的 \(\Lambda=100\),3.48% 与那里的 3.5% 一致。往下每多一份免费流,主动量就少一份,总量从 3.48 只挪到 3.51。吞吐 \(J\) 却一路上涨,因为同样多的知识不再占传数据的资源。
会议室那组的 \(\Lambda\) 小,原来的最优总量只有 2.18,免费流到 \(\Lambda_0=2.26\) 就把主动探测完全顶掉。数值由 (b) 的方程求根得出,并用 \([0,1]\) 上 \(2\times10^5\) 格的直接搜索复核,两者在表中精度内一致【本站演算】。
这件事的工程含义很直接:先数清网络里已经在流动的测量能提供多少知识(\(\Lambda_0\)),再决定要不要专门为认识环境花资源。对饱和型汇率,\(\Lambda_0\) 一旦超过 \(\ln\frac{\Delta C_{\max}(\Lambda+1)}{C_0+\Delta C_{\max}}\),专门的探测就是浪费。还没超过时,专门探测只需补足差额。
两池的细化
免费流有一个盲区:它只覆盖实际测得到的那部分链路,也就是终端驻留和走过的小区、栅格、波束。没人去过的地方,例行测量一比特也写不进去。
更贴切的模型要把知识池拆成两个:可观测池 \(q_{\mathrm{o}}\) 由 \(\kappa_0+\kappa\alpha_{\mathrm{o}}\) 写入,不可观测池 \(q_{\mathrm{u}}\) 只能靠主动探测 \(\kappa\alpha_{\mathrm{u}}\) 写入,汇率按两池的覆盖份额加权。上面的结论只对可观测池成立。不可观测池里的知识仍得花 \(\alpha\) 去买,而它值不值得买,取决于那些地方会不会有用户去【本站提法】。
因果可行性:这些界都是设计期的工具
\(\alpha^\star\)、门槛 \(\Lambda_0^\star\)、本章各处的后悔与吞吐,都是在知道 \(\kappa\)、\(T_{\mathrm{env}}\) 和汇率曲线 \(\Delta C\) 的前提下算出来的。运行期没有这些量的真值,尤其拿不到"用真实信道算出来的后悔":真实信道要是在手,也就不需要地图了。
所以它们适合在设计期决定预算、周期和测量配置,不能直接拿来当运行期的更新触发器。这个因果圈套在预备篇第 11 章有更具体的说法。
运行期怎么触发更新:用看得见的漂移,和固定周期比
运行期站得住的触发信号,只能来自可观测池:在实际测到的链路上比较地图的预测与实测,残差持续变大,说明环境变了、知识过时了。标准里有两类现成的先例,都是"用运行期拿得到的量决定测多测少":
- Rel-16 起的放松测量(TS 38.304 §5.2.4.9):低移动、不在小区边缘的终端可以少测。
- 非地面网络里按位置、按时间启动邻区测量(TS 38.304 §5.2.4.2):离参考位置够近就先不测,到服务结束时刻之前再开始测。
任何更聪明的触发方案都要和一个简单基线比:按 \(T_{\mathrm{env}}\) 的量级固定周期更新(家具层按天、建筑层按月)。它不依赖任何运行期真值,实现也最简单。比不过它的触发规则,没有理由上线【本站判断】。
到此为止我们得到了什么
- 一个能算数的回路与它的平衡点。稳态知识 \(q^\star=\kappa\alpha T_{\mathrm{env}}\),吞吐 \(J=(1-\alpha)[C_0+\Delta C(q^\star)]\),一阶条件是等边际原理。
- 饱和型汇率给出带阈值 \(\Lambda_c=C_0/\Delta C_{\max}\)、按 \(\ln\Lambda/\Lambda\) 消失的 \(\alpha^\star\)。幂律型给出趋于 \(\beta/(1+\beta)\) 的常数。\(\Lambda=100\) 处是 3.5% 对 26.5%。
- 平衡点的位置由第一部 Q3 曲线的形状决定,这是本章的可证伪预言。
- 加上例行测量带来的免费知识流后,最优的总知识量几乎不变,主动探测几乎一比一地让位,免费流超过门槛 \(\Lambda_0^\star\) 就归零。
5.5 同一条律:耐用品与易逝品,从 \(T_{\mathrm{coh}}\) 到 \(T_{\mathrm{env}}\)#
5.5.1 Hassibi–Hochwald 的答案与并排对照#
直觉
"多少训练才够"是无线里最老的资源分配问题之一:每个相干块里花几个符号发导频、剩下几个发数据。它和"多少资源投给认识环境"是同一个问题,只是知识的对象从信道(易逝品,活一个相干块)换成了环境(耐用品,活一个 \(T_{\mathrm{env}}\))。
如果认知回路是对的,它应当在"对象 = CSI"时退化成教科书答案。
教科书答案是 Hassibi–Hochwald 2003 [6]:Rayleigh 块衰落、\(M\) 根发射天线、相干长度 \(T\) 符号,训练与数据功率可独立分配时,最优训练符号数 \(T_\tau=M\),恰是让信道可辨识的最小长度。容量下界具有 \((1-T_\tau/T)\log(1+\rho_{\mathrm{eff}})\) 的结构,其中 \(\rho_{\mathrm{eff}}\) 由训练与数据功率的最优分配决定。
功率不可变(等功率)时最优 \(T_\tau\) 可能大于 \(M\),且随 SNR 变化:高 SNR 下只略长于 \(M\),SNR 越低越长,低 SNR 下趋于半个相干块([6] 第 III-D 节与第 V 节)。
Zheng–Tse 2002 [5] 从非相干角度给出同一结构:高 SNR 下 SNR 每增加 3 dB,容量增加 \(M^\star(1-M^\star/T)\) 比特/秒/赫兹,即自由度 \(M^\star(1-M^\star/T)\),\(M^\star=\min(M,N,\lfloor T/2\rfloor)\)([5] 摘要)。
把两者并排:
| 认知回路(本章) | Hassibi–Hochwald [6] | |
|---|---|---|
| 知识对象 | 环境(耐用品) | 信道 CSI(易逝品) |
| 时间常数 | \(T_{\mathrm{env}}\)(秒到年) | 相干块长 \(T\)(毫秒级) |
| 资源份额 | \(\alpha\) | \(T_\tau/T\) |
| 吞吐结构 | \((1-\alpha)[C_0+\Delta C(q^\star)]\) | \((1-T_\tau/T)\log(1+\rho_{\mathrm{eff}})\) |
| 知识饱和值 | \(q_{\mathrm{sat}}=d_{\mathrm{eff}}\log_2(1/\varepsilon)\) | \(M\) 个复系数(可辨识性) |
| 汇率形状 | 未知(Q3 三条候选) | 阈值型:不足 \(M\) 个符号不可辨识,超过 \(M\) 个只是浪费时间 |
| 最优份额 | \(\ln\Lambda/\Lambda\)(饱和型)/ 常数(幂律型) | \(M/T\) |
最后两行是重点。Hassibi–Hochwald 的"超过 \(M\) 个训练符号只是浪费",在本章语言里就是一条阈值型汇率:\(\Delta C(q)=\Delta C_{\max}\cdot\mathbf{1}[q\ge q_{\mathrm{sat}}]\)(知识不到饱和值时几乎无用,到了就全有)。这是第一部 Q3 三条候选形状之一。
5.5.2 算例:把对象换成 CSI,回路是否退化#
算例 5.6(一致性检验:把对象换成 CSI,回路是否退化为 \(T_\tau=M\))
设 \(M=4\)、\(T=100\)。Hassibi–Hochwald:训练占比 \(T_\tau/T=4/100=\mathbf{4\%}\)。
回路的翻译
- 知识对象 = 本块的 \(M=4\) 个信道系数,故 \(q_{\mathrm{sat}}=M=4\)(以"系数个数"计)。
- 每个训练符号写入一个系数,\(\kappa=1\) 系数/符号。
- 块末全部作废,\(T_{\mathrm{env}}=T=100\) 符号。
于是 \(\Lambda=\kappa T/q_{\mathrm{sat}}=100/4=25\)。
阈值型汇率
\(J(\alpha)=(1-\alpha)[C_0+\Delta C_{\max}\mathbf{1}[\Lambda\alpha\ge1]]\):
- \(\alpha<1/\Lambda\) 时 \(J=(1-\alpha)C_0\) 递减;
- \(\alpha\ge1/\Lambda\) 时 \(J=(1-\alpha)(C_0+\Delta C_{\max})\) 递减。
跳变发生在 \(\alpha=1/\Lambda\)。两段都递减,最大值只能在两处取到:\(\alpha=0\) 处 \(J=C_0\),跳变点处 \(J=(1-1/\Lambda)(C_0+\Delta C_{\max})\)。后者更大 \(\iff(\Lambda-1)(C_0+\Delta C_{\max})>\Lambda C_0\iff\Delta C_{\max}>C_0/(\Lambda-1)\)。此时最大值在跳变点
回路在阈值型汇率下精确退化为 Hassibi–Hochwald。
饱和型汇率(指数)
推论 5.2(c) 在 \(\Lambda=25\)、\(\Delta C_{\max}=0.5\) 下给 \(\alpha^\star=\mathbf{0.083}\),闭式 \(\ln(25/3)/25=2.120/25=0.085\)。比 \(M/T\) 大一倍:指数饱和比阈值"软",值得多学一会儿。
随 \(T\) 的标度
- 阈值型:\(\alpha^\star T=M=4\),常数。
- 指数型:由推论 5.2(d) 的闭式,\(\alpha^\star T\approx(q_{\mathrm{sat}}/\kappa)\ln\!\bigl(\kappa T/(3q_{\mathrm{sat}})\bigr)\)(给 \(8.5\) 与 \(17.7\))。按不动点精确解,\(T=100\) 时 \(8.3\),\(T=1000\) 时 \(17.6\)。
两者同样是 \(1/T\) 的形态,差一个对数因子。
校验
- (a) 阈值型的条件 \(\Delta C_{\max}>C_0/(\Lambda-1)=1/24=0.042\) 在 \(\Delta C_{\max}=0.5\) 下成立 ✓。
- (b) 指数型 \(\alpha^\star=0.083\) 代回一阶条件:\(A=0.5\times25\times e^{-2.076}\times0.917=12.5\times0.1254\times0.917=1.437\),\(B=1+0.5\times(1-0.1254)=1.437\) ✓。
- (c) \(T=1000\):\(\Lambda=250\),\(\alpha^\star=0.01764\)(不动点),\(\alpha^\star T=17.6\)。闭式 \(\ln(250/3)/250=4.423/250=0.01769\) ✓。
- (d) 极限一致:
- \(T\to\infty\) 时两种形状的 \(\alpha^\star\) 都 \(\to0\),与"块长无穷时训练开销可忽略"一致 ✓。
- \(T\to M\)(\(\Lambda\to1\))时两种形状也都给 \(\alpha^\star=0\)(干脆不训练、非相干传输),只是门槛不同。指数型在 \(\Lambda\le\Lambda_c=2\) 时就不值得感知。阈值型要越过门槛须投入 \(\alpha\ge1/\Lambda\),\(\Lambda\to1\) 时这等于把整块都拿去训练、数据份额趋于零,按 (a) 的条件只有 \(\Lambda>1+C_0/\Delta C_{\max}=3\) 才划算。
- 短块上知识不值得买,与 Zheng–Tse 非相干自由度 \(M^\star(1-M^\star/T)\) 在 \(T\) 小时要把所用天线数缩到 \(M^\star=\lfloor T/2\rfloor\) 是同一个方向([5] 摘要)。其定理 12 另指出,发射天线多于接收天线数 \(N\) 且 \(T\ge2N\) 时,只用 \(N\) 根发射天线就能达到高 SNR 容量,多出的天线不添自由度 ✓。
5.5.3 0.035 与 0.04 的巧合,以及方法的边界#
直觉:0.035 与 0.04 的巧合
算例 5.4 里 \(\Lambda=100\) 的饱和型 \(\alpha^\star=3.5\%\),与 \(M=4\)、\(T=100\) 的 Hassibi–Hochwald 训练占比 \(4\%\) 数值相近。这只是类比级的巧合,不是推导:前者的 \(\Lambda=100\) 与后者的 \(\Lambda=25\) 并不相同,汇率形状也不同(指数对阈值)。
它的教学价值只有一句话:耐用品与易逝品服从同一条律 \((1-\alpha)\cdot f(\alpha)\),只是时间常数从 \(T_{\mathrm{coh}}\) 换成 \(T_{\mathrm{env}}\)。
第一部第 9 章说"易逝品已有定价理论、耐用品还没有",原因现在可以说得更准:易逝品的汇率形状是已知的(可辨识性给出阈值),耐用品的汇率形状是 Q3 的开放问题。
方法的边界
Hassibi–Hochwald 解决了块内的"训练多长",且给出闭式。它回答不了跨块的知识累积(块末全部作废是它的模型假设)。Zheng–Tse 解决了非相干极限的自由度。两者都没有"环境"这个层次。
认知回路把块长换成 \(T_{\mathrm{env}}\),代价是引入了一条形状未知的曲线。这就是本部缺失定理的落点:耐用品汇率的形状。
到此为止我们得到了什么
一次一致性检验。把认知回路的对象从环境换成 CSI、把 \(T_{\mathrm{env}}\) 换成块长、把汇率换成可辨识性给出的阈值型,回路精确退化为 \(T_\tau=M\)。换成指数饱和型,则给出同为 \(1/T\) 形态、差一个对数因子的答案。耐用品与易逝品同律,差别只在时间常数与汇率形状,而后者恰是耐用品那侧的未知。
5.6 多时间尺度:\(T_{\mathrm{env}}\) 不止一个,知识应分层折旧#
5.6.1 环境变化的三个层#
直觉
同一间房里,有些东西一秒钟就变(走过的人),有些东西几天变一次(搬动的桌椅),有些东西几年不变(墙)。把它们的知识记在同一本账上按同一个折旧率摊销,显然不对:墙的知识值得花一次大成本永久保存,人的知识根本不值得保存。它们要按各自的寿命分开记账。
量级估计(不是实测)
本站检索到的文献里只有一条相关口径:Bykhovsky 2020 [19] 实测室内光无线(可见光 / 红外)信道的相干时间,结论是多数移动场景下信道约 100 ms 内变化缓慢。它量的是终端移动引起的光链路变化,不是射频信道,也不是环境本身的变化,只能当量级旁证。文献里没有"人员 / 家具 / 建筑"三级的实测分层数字。
下表按量级估计写,明确标注为估计【本站估计】:
| 层 \(\ell\) | 环境要素 | \(T_{\mathrm{env},\ell}\)(量级估计) | 在第 3 章格里的层 | 与 \(\lambda/L\) 的关系(第一部第 2 章) |
|---|---|---|---|---|
| 1 快 | 行人、车辆、门 | \(10^{0}\) s(秒级) | 尾 CDF、瞬时 LoS 指示 | 遮挡边缘,\(L\sim1\) m,\(\sqrt{\lambda/L}\approx0.3\) |
| 2 中 | 家具、货架、临时隔断 | \(10^{4}\)–\(10^{5}\) s(小时到天) | 增益向量、BIM 的局部修正 | 反射面,\(L\sim1\) m |
| 3 慢 | 墙体、地形、建筑 | \(10^{7}\)–\(10^{8}\) s(月到年) | APS、BIM 的主体、K 因子 | 大尺度结构,\(L\gg\lambda\) |
5.6.2 分层模型与等杠杆边际条件#
分层模型(定义 5.4 的直接推广)
设知识分 \(\ell=1,\dots,L\) 层,各层独立折旧:
总感知占比 \(\alpha=\sum_\ell\alpha_\ell\)。若汇率对各层可加(这是一个额外假设,见下),\(\Delta C(q_1,\dots,q_L)=\sum_\ell\Delta C_\ell(q_\ell)\),则
对 \(\alpha_m\) 求偏导。乘积法则加链式法则,与命题 5.1 的三步逐字相同,只是 \(u=1-\sum\alpha_\ell\) 对 \(\alpha_m\) 的偏导仍是 \(-1\):
物理意义
- 右边对所有层相同:最后一单位资源去传数据换来的容量。
- 左边每层各一个:该层的边际汇率乘以该层的杠杆 \(\kappa_mT_{\mathrm{env},m}\)。
所以所有被投资的层在最优点有相同的"杠杆化边际汇率"。杠杆太小的层(\(\Delta C_m'(0^+)\kappa_mT_{\mathrm{env},m}\le\) 右边)一分钱也不投。
行为分析
各层的无量纲数 \(\Lambda_\ell=\kappa_\ell T_{\mathrm{env},\ell}/q_{\mathrm{sat},\ell}\) 相差许多个数量级。
- 慢层:在饱和型汇率下 \(\alpha_\ell^\star\sim\ln\Lambda_\ell/\Lambda_\ell\) 极小(一次建库,长期受益)。
- 快层:若 \(\Lambda_\ell\le\Lambda_c\) 则 \(\alpha_\ell^\star=0\)。快层的知识不该进耐用品的账本,它属于易逝品,用 CSI 级的即时感知处理。
这给第 3 章"CKM 该存哪几层"(存 \(\bigvee_T\mathcal{S}_T\))加上了时间维:存格上那些 \(\Lambda_\ell>\Lambda_c\) 的层。
5.6.3 算例:三层各自的 \(\Lambda\) 与 \(\alpha^\star\)#
算例 5.7(三层各自的 \(\Lambda\) 与 \(\alpha^\star\):量级账)【本站估计】
会议室天花板 \(q_{\mathrm{sat}}=1.3\times10^{6}\) 比特(算例 3.4)按层拆分(估计):慢层 \(10^{6}\)(墙体几何与材质占了绝大部分可见维度)、中层 \(10^{5}\)、快层 \(10^{4}\)。
各层感知写入率都取 \(\kappa_\ell=10^{3}\) bit/s(一个量级估计:相当于每秒把一条 CSI 的环境相关部分写进地图)。各层 \(\Delta C_{\max,\ell}=0.5\)、\(C_0=1\),饱和型。
| 层 | \(q_{\mathrm{sat},\ell}\) | \(T_{\mathrm{env},\ell}\) | \(\Lambda_\ell=\kappa_\ell T_\ell/q_{\mathrm{sat},\ell}\) | \(\alpha_\ell^\star\)(单层近似,推论 5.2) |
|---|---|---|---|---|
| 慢(建筑) | \(10^{6}\) | \(10^{7}\) s(约 4 个月) | \(10^{3}\times10^{7}/10^{6}=10^{4}\) | \(\ln(10^{4}/3)/10^{4}=8.11/10^{4}=\mathbf{0.08\%}\) |
| 中(家具) | \(10^{5}\) | \(10^{5}\) s(约 1 天) | \(10^{3}\times10^{5}/10^{5}=10^{3}\) | \(\ln(10^{3}/3)/10^{3}=5.81/10^{3}=\mathbf{0.58\%}\) |
| 快(行人) | \(10^{4}\) | \(1\) s | \(10^{3}\times1/10^{4}=0.1\) | \(0.1<\Lambda_c=2\Rightarrow\mathbf{0}\) |
读法
- 建筑层:一年 \(3\times10^{7}\) s 里只需约 \(2.5\times10^{4}\) s(7 小时)的感知资源,"一次路测管一年"。
- 家具层:每天 \(0.58\%\times86400\approx500\) s(8 分钟),"每天扫一遍"。
- 行人层:不值得建任何耐用知识。行人的影响(第一部第 5 章:一个未建模行人 = 21–30 dB)必须由即时感知(CSI / 雷达回波,易逝品)承担。
校验
- (a) \(\Lambda\) 的量纲:bit/s × s / bit = 无量纲 ✓。
- (b) 慢层的绝对数用另一条路径复算:\(\alpha^\star T_{\mathrm{env}}=8.11\times10^{-4}\times10^{7}=8.1\times10^{3}\) s \(\approx2.3\) 小时每 4 个月,一年即 \(6.8\) 小时,与"7 小时"一致 ✓。
- (c) 分层比单层合理:若把三层合成一个 \(T_{\mathrm{env}}\)(比如取中层的 \(10^{5}\) s、总 \(q_{\mathrm{sat}}=1.3\times10^{6}\)),\(\Lambda=10^{3}\times10^{5}/1.3\times10^{6}=77\),\(\alpha^\star=\ln(77/3)/77=4.2\%\)。这比分层后的总和 \(0.66\%\) 高 6 倍,因为它按家具的寿命去折旧墙体的知识 ✓。
- (d) 可加性假设的边界:若三层知识对容量的贡献不可加(比如墙体知识只有在家具知识也准确时才值钱,即"并"而非"和"),上式失效。这与命题 3.2(d)"交只有不等式"是同一类困难 ✓。
方法的边界
数字孪生文献里"同步频率–保真度–能耗"的折中与 drift-adaptive 同步(变化快时提频、平稳时抑制)与本节的 \(\alpha_\ell\) 分配同构。但据本站检索均为启发式或应用型结果,没有基本极限。
CKM 文献从"能不能"转向"要多少数据、多久更新"(Zeng 等教程 [14]、Xu–Zeng [15]),后者给出的是地图精度对采样密度的标度,尚未连接到容量增益。
回答不了的部分,即各层的 \(\Delta C_\ell\) 形状与可加性,正是本部缺失定理的落点。
到此为止我们得到了什么
时间维上的分层。\(T_{\mathrm{env}}\) 是一族数,不是一个数。各层在最优点有相同的杠杆化边际汇率。\(\Lambda_\ell\) 低于阈值的层根本不该进耐用品账本。第 3 章的"CKM 该存哪几层"由此加上了一条时间判据:存 \(\Lambda_\ell>\Lambda_c\) 的层。
5.7 三元 region:分时凸包可达,内部形状开放#
现在回到章标题。§5.2 否决了"决策后悔当独立第三轴"的三元 region。本节给出让它适定的前提,证明在此前提下能证的部分(分时凸包),并把剩下的写成猜想。
5.7.1 三资源设定与三条前提#
直觉
三个人分一块蛋糕(资源),各做各的事:一个传数据,一个看路上的车(外部目标),一个研究这条路本身好不好走(自身信道)。三个人各得多少、各做成多少,是一个三维图。
图里最容易证明的一件事是:如果三种分法各自可行,那么"轮流用"也可行。这就是分时凸包。
定义 5.5(三资源设定与三元 region)【本站提法】
时间分块,每块长 \(T_b\)。每块内资源(时隙 / 功率)按份额 \((\gamma_{\mathrm{c}},\gamma_{\mathrm{s}},\gamma_{\mathrm{k}})\),\(\gamma_{\mathrm{c}}+\gamma_{\mathrm{s}}+\gamma_{\mathrm{k}}=1\),分给三个互不重叠的资源汇:
- 通信 \(\gamma_{\mathrm{c}}\):传数据,每块交付的比特数 \(B_n\);
- 外部感知 \(\gamma_{\mathrm{s}}\):估计一个外部目标(不是自身信道)的状态,每块的感知损失 \(\epsilon_n\in[0,1]\)(例如归一化均方误差);
- 自身知识 \(\gamma_{\mathrm{k}}\):获取关于自身信道 / 环境的知识,用于任务 \(T\) 的决策,每块的决策后悔 \(\rho_n\in[0,1]\)(定义 5.1)。
一个策略是份额序列与各汇内部编码 / 估计 / 决策规则的选择。性能三元组为长期平均
(极限存在时)。三元 region \(\mathcal{R}_T\) 是所有策略可达三元组集合的闭包。
前提:(P1) 感知对象是外部目标,其感知损失不由自身信道知识决定;(P2) 决策的知识来自独立的资源汇 \(\gamma_{\mathrm{k}}\);(P3) 三个度量都是每块可加的量。
为什么要这三条前提
- 没有 (P1),感知的对象就是自身信道,\(\epsilon\) 与 \(\rho\) 由同一份知识决定,退回 §5.2 的塌缩。
- 没有 (P2),\(\rho\) 不是独立可拨动的。
- 没有 (P3),"轮流用"的平均性能不是各段性能的平均。CRB 就不是每块可加的(它是方差下界,不是损失),所以本定义用 MSE 一类的损失而非 CRB。
5.7.2 分时凸包可达#
命题 5.4(分时凸包可达)【本站演算·标准分时论证】
在定义 5.5 的前提下,\(\mathcal{R}_T\) 是凸集。特别地,若三个"纯"策略(\(\gamma\) 分别取 \((1,0,0)\)、\((0,1,0)\)、\((0,0,1)\))可达的三个角点为 \(\mathbf{p}_{\mathrm{c}},\mathbf{p}_{\mathrm{s}},\mathbf{p}_{\mathrm{k}}\in\mathbb{R}^3\),则它们的凸包
证明(三步)
**第一步:两个可达点的有理分时。**设策略 \(\sigma_1,\sigma_2\) 分别可达 \(\mathbf{p}_1,\mathbf{p}_2\),取有理数 \(t=a/b\in[0,1]\)(\(a,b\) 正整数)。构造策略 \(\sigma\):把时间按每 \(b\) 块一组分组,每组前 \(a\) 块运行 \(\sigma_1\)、后 \(b-a\) 块运行 \(\sigma_2\)。
这一步做了什么:因为三个资源汇互不重叠且各块独立((P1)(P2)),在一块里运行 \(\sigma_1\) 不影响另一块里 \(\sigma_2\) 的性能。这是分时论证成立的全部前提。
**第二步:平均性能是凸组合。**由 (P3),前 \(N=kb\) 块的平均为
这一步做了什么:把求和按"哪个策略在跑"分成两堆,每堆各自的平均趋于该策略的性能,权重恰是时间份额。非整倍数的 \(N\) 只多出不到 \(b\) 块,对平均的影响是 \(O(b/N)\to0\)。
**第三步:无理分时与闭包。**无理 \(t\) 用有理数列 \(t_j\to t\) 逼近,对应的可达点 \(t_j\mathbf{p}_1+(1-t_j)\mathbf{p}_2\to t\mathbf{p}_1+(1-t)\mathbf{p}_2\),落在闭包 \(\mathcal{R}_T\) 中。于是 \(\mathcal{R}_T\) 对任意两点的凸组合封闭,即凸。
三点的凸包由两两凸组合迭代得到(先取 \(\mathbf{p}_{\mathrm{s}},\mathbf{p}_{\mathrm{k}}\) 的凸组合,再与 \(\mathbf{p}_{\mathrm{c}}\) 取凸组合),故包含于 \(\mathcal{R}_T\)。\(\blacksquare\)
物理意义
这是 ISAC 文献里"分时内界"(time-sharing inner bound)的三维版本,与算例 5.1 的弦是同一件事。它给出三元 region 的一个内界,是一个三角形。
行为分析
- **(P3) 不是装饰。**把 \(\epsilon\) 换成 CRB,第二步的"平均 = 凸组合"就不成立:两段各自的 CRB 不能按时间平均成整体的 CRB。文献里 CRB–rate 区域的分时内界因此需要单独论证 [11]。
- **凸包通常不紧。**算例 5.1 已在二维显示联合设计严格高于弦。三维里三个汇共用一份波形时(ISAC 波形既传数据又探测目标又学信道),预期同样如此。
- **放弃前提 (P1) 会怎样。**感知目标 = 自身信道时,\(\gamma_{\mathrm{s}}\) 与 \(\gamma_{\mathrm{k}}\) 合并,\(\epsilon\) 与 \(\rho\) 由同一份知识经两个任务映射得到,region 塌成一张由 \(\alpha\) 与任务索引的曲面。那就是 §5.4 的 \(J(\alpha)\) 曲线加第 3 章的任务格。
5.7.3 三角形内界的算例与形状猜想#
算例 5.8(三角形内界的一个点)【本站示意】
沿用算例 5.1 的功率分割玩具给出角点(后悔用算例 2.4 的 0.25 作"无自身知识"时的值,有自身知识时为 0):
- \(\mathbf{p}_{\mathrm{c}}=(R,\epsilon,\rho)=(3.459,\ 1,\ 0.25)\):全部通信,外部目标不感知(\(\epsilon\) 取先验方差 1),无自身知识;
- \(\mathbf{p}_{\mathrm{s}}=(0,\ 0.0909,\ 0.25)\):全部感知外部目标;
- \(\mathbf{p}_{\mathrm{k}}=(0,\ 1,\ 0)\):全部学自身信道,决策无后悔。
取时间份额 \((1/2,1/4,1/4)\):
校验
- (a) 份额之和 \(1/2+1/4+1/4=1\) ✓。
- (b) 每个坐标都落在三个角点对应坐标的最小值与最大值之间:\(R\in[0,3.459]\)、\(\epsilon\in[0.0909,1]\)、\(\rho\in[0,0.25]\) ✓。
- (c) 与二维弦的一致性:把 \(\gamma_{\mathrm{k}}=0\)、份额 \((1-t,t,0)\) 代入,得 \((R,\epsilon)=((1-t)3.459,\ 1-0.9091t)\),消去 \(t\) 恰是算例 5.1 的弦 \(R=3.459(\epsilon-0.0909)/0.9091\) ✓。
- (d) 联合设计的证据:在 \(\epsilon=0.25\) 处弦给 \(R=0.605\)、联合功率分割给 \(3.000\)。凸包内界离真实边界很远,这就是猜想 5.5(a) 的二维证据 ✓。
猜想 5.5(三元 region 的形状)【开放·本站提法】
在定义 5.5 的前提 (P1)–(P3) 下:
**(a) 严格大于凸包。**当三个资源汇共用同一份波形(ISAC 波形同时传数据、探测目标、学信道)时,\(\mathcal{R}_T\supsetneq\mathrm{conv}\{\mathbf{p}_{\mathrm{c}},\mathbf{p}_{\mathrm{s}},\mathbf{p}_{\mathrm{k}}\}\),且边界在内部处处严格凸。
(b) 两个投影已知。\(\rho=\rho_{\max}\)(不学信道)的切片是 ISAC 二维 region([10][11] 的两条路径各给一个版本)。\(\epsilon=\epsilon_{\max}\)(不感知外部目标)的切片在稳态下是 §5.4 的曲线 \(\{(J(\alpha),\rho(\alpha))\}\),其中 \(\rho(\alpha)\) 由稳态知识 \(q^\star(\alpha)\) 经任务映射得到。
**(c) 后悔轴的刻度由任务格决定。**对任务类 \(\mathcal{T}\),\(\rho\) 轴应替换为 \(\sup_{T\in\mathcal{T}}\rho_T\),其可达下界由 \(\|L_T\|\delta_{\mathcal{T}}(\mathcal{E}_{\mathrm{k}},\mathcal{E}_0)\)(定义 3.1(c) 的任务限制亏格)控制。\(\mathcal{T}\) 越宽,region 越小。
已知与未知的边界
- 已知:凸包可达(命题 5.4);(b) 的第一个切片在点对点高斯模型下已有角点与内外界 [11];(b) 的第二个切片是本章模型的输出。
- 未知:(a) 的严格性(需要一个三资源共用波形的显式可达方案);region 的任何外界;(c) 里 \(\delta_{\mathcal{T}}\) 的显式值(第 3 章 Q3.1)。
- 文献状态:截至 2026 年 9 月,ISCC 文献(含综述 [16]【预印本·未评审】)只做三类多目标优化的问题表述,把第三维取作"计算"而非"决策"。据本站检索未见感知–通信–决策三维性能区域的形式化刻画,也未见对其适定性的讨论。把 control 作为第三维的工作以 UAV 跟踪等应用型论文为主,无基本极限结果。本猜想是本站提法,文献既未证实也未证否。
到此为止我们得到了什么
一个适定的三元 region 与它已知的部分。前提是三个互不重叠的资源汇、外部感知目标、每块可加的度量。
在此前提下,凸包(三角形)可达,两个二维切片分别是 ISAC 二维图与认知回路曲线。内部形状、任何外界、任务类版本的刻度全部开放。没有这些前提,三元 region 退回 §5.2 的塌缩。
5.8 两种信息的合流、四个场景与方法盘点#
5.8.1 关于未来与关于环境:双变量版本#
本部与第三部互为姊妹。第一部 Q3 的 \(\Delta C(R_{\mathrm{env}})\) 定价"关于环境的信息",第三部第 5 章的 \(V(I):=\sup_{q:\,I(\xi;M)\le I}\sup_{\pi\in\Pi(M)}J(\pi,q)\)【本站原创】定价"关于未来的信息"(单调不减、凹、小 \(I\) 处极陡)。
一部真实系统同时在买两种信息:CKM 建库是前者,CSI 预测 / 流量预测是后者,两者花同一份预算。把认知回路推广成双变量:
定义 5.6(双信息认知回路)【本站提法】
感知份额 \(\alpha_{\mathrm{e}}\) 投给环境知识(稳态 \(q^\star=\kappa_{\mathrm{e}}\alpha_{\mathrm{e}}T_{\mathrm{env}}\)),份额 \(\alpha_{\mathrm{f}}\) 投给关于未来的信息(稳态 \(I^\star=\kappa_{\mathrm{f}}\alpha_{\mathrm{f}}T_{\mathrm{pred}}\),\(T_{\mathrm{pred}}\) 为预测信息的有效寿命)。在可加假设下,
一阶条件的形态(与 §5.6 的分层推导逐字相同):
物理意义
两种信息的杠杆化边际价格相等,且都等于传数据的边际价格。\(V\) 是凹的(第三部定理),所以 \(V'\) 递减,\(\alpha_{\mathrm{f}}\) 一侧总有唯一内点解或角点解。\(\Delta C\) 的形状未知,所以 \(\alpha_{\mathrm{e}}\) 一侧的解依赖 Q3。
状态:【开放·本站提法】。可加假设未经论证:两种信息很可能互补(知道环境让预测更准),不能简单相加。\(T_{\mathrm{pred}}\) 与第一部 Q2 的预测半径 \(r_{\max}\approx1.5\) m \(\approx17\lambda\) 的关系未建立。这是第 7 章纲领里"与四条 converse 的接口表"的一行。
5.8.2 四个场景:每个场景对应回路的一个环节#
| 场景 | 回路环节 | \(\Lambda\) 的量级估计【本站估计】 | 已有方法解决了什么 | 回答不了什么 |
|---|---|---|---|---|
| ISAC 波形设计 | "感知 → 知识"这条边:探测与利用共用波形,有 ISAC 版对偶效应(DRT 是反向对偶) | 块内 \(\Lambda\sim T/M\sim10\)–\(10^{2}\)(易逝品) | 容量–失真 [10]、CRB–rate 角点与 ST/DRT [11]、MIMO 半闭式 [12];雷达辅助预测波束在车联网实证"感知服务通信" [9];Demirhan–Alkhateeb 实测雷达辅助波束预测 top-5 约 90%、节省约 93% 波束训练开销 [17]【预印本 / WCNC】 | 跨块的知识累积;93% 是感知已就绪时的增益,不是 \(\Delta C\) 的标定值 |
| 主动感知(选测什么) | "资源 → 感知"这条边:在给定份额内选测量 | 与对象同 | 贝叶斯实验设计 [4]:效用期望最大化,线性模型 + Shannon 效用 \(\Rightarrow\) D-最优;不同效用给不同准则——这正是第 3 章"任务决定要哪部分"的统计学版本 | 静态:不含折旧与稳态,没有 \(T_{\mathrm{env}}\) |
| 数字孪生的更新预算 | 整条回路:\(\alpha^\star\) 就是"同步频率"的工程读法 | 网络级 \(\Lambda\sim10^{3}\)–\(10^{4}\)(小时到天级的运维对象) | drift-adaptive 同步(变化快时提频)与本章 \(\alpha_\ell\) 分配同构【据本站检索为启发式】 | 无基本极限;孪生的 misspecification 归第 4 章 |
| CKM 的测量–使用循环 | "知识 → 汇率 → 容量"这条边 | 建库级 \(\Lambda\sim10^{4}\)(算例 5.7 慢层) | CKM 教程 [14]:栅格原则;Xu–Zeng [15]:地图精度对采样密度的标度(AMSE) | \(\Delta C\)(容量增益对环境信息量)的曲线数字——本章最大的证据缺口 |
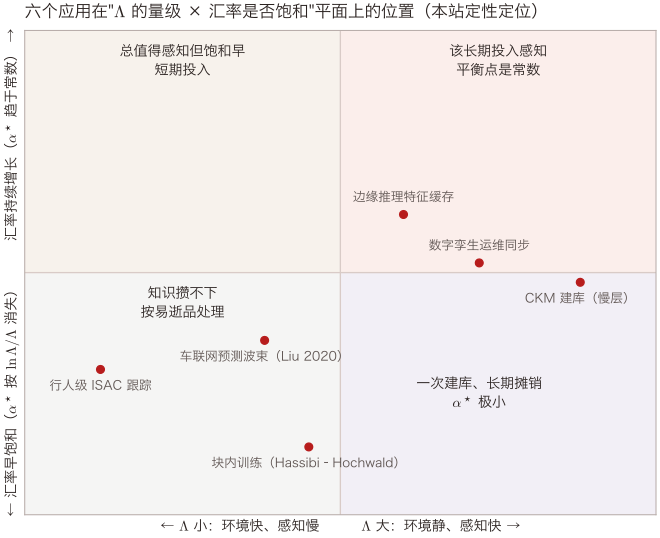
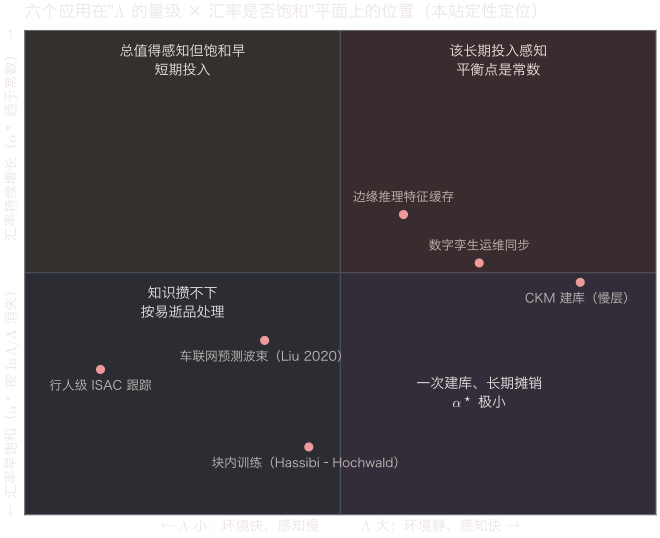
怎么读这张图:横轴是 \(\log\Lambda\) 的定性位置,纵轴是"该场景的汇率曲线更像饱和型还是幂律型"。纵坐标是未知量(Q3 的形状),本站只按物理直觉定性放置:块内训练的汇率是阈值型(可辨识性),故放在最下;CKM 与数字孪生的汇率形状完全未知,故放在纵轴中央。
左下(行人级跟踪)\(\Lambda<\Lambda_c\),知识攒不下,按易逝品处理。右下是"一次建库、长期摊销"。这张图的用途是指出:同一场景在纵轴上的位置一旦确定,\(\alpha^\star\) 的量级就随之确定。这就是把 Q3 的形状问题翻译成工程量的方式【本站定位,非测量值】。
5.8.3 方法盘点#
| 方法谱系 | 解决了什么 | 回答不了什么 | 落点 |
|---|---|---|---|
| ISAC 基本限(两条路径 [10][11][12]) | 点对点"精度值多少速率";角点;ST/DRT 两重折中 | 组网 / 多用户只有特例;CRB 域整体;波形受限;单块,无知识累积 | §5.1;猜想 5.5(b) 的第一个切片 |
| 对偶控制(Feldbaum [1]、Bar-Shalom–Tse [2]、Mesbah [8]、分离间隙 [18]) | 原理与判据:动作进后验方差则须联合设计;LQG 下分离 | 有原理无闭式:最优解计算不可行;无稳态 / 摊销版本 | §5.3;认知回路是其稳态玩具 |
| POMDP 信息价值 | 信息价值的动态定义 | 有定义无闭式;不含物理结构 | 第三部第 4 章"四种不知道"的第三种 |
| 贝叶斯实验设计 [4] | "测什么"的静态最优准则 | 静态,无折旧 | §5.8 场景二 |
| 感知辅助通信的启发式与 DRL [9][17] | 实测增益(93% 开销节省、top-5 约 90%) | 有增益无极限;不给 \(\Delta C\) | 场景一 |
| 训练开销理论(Hassibi–Hochwald [6]、Zheng–Tse [5]) | 块内最优训练长度 \(T_\tau=M\)、非相干自由度 | 块末知识作废;无环境层 | §5.5 同律 |
| CKM 工程化([14][15]) | 栅格原则、数据量–精度标度 | 精度到容量的汇率;更新周期与 \(T_{\mathrm{env}}\) 的关系 | §5.6;证据缺口 |
| 认知回路(本章【本站模型】) | 稳态平衡点、两种形状两种结论、与 HH 同律、分层折旧 | \(\Delta C\) 的形状(Q3);可加性;三元 region 内部 | 第 7 章纲领的暗线四件套 |
表的最后一列说明:现有方法要么有极限但无时间维(ISAC、训练理论),要么有时间维但无闭式(对偶控制、POMDP),要么有数字但无极限(DRL、CKM 工程化)。认知回路把三者接在一起的代价是引入一条形状未知的曲线。
所有"回答不了"最终汇到同一个缺口:耐用品汇率 \(\Delta C(R_{\mathrm{env}})\) 的中段形状。
到此为止我们得到了什么
- 两种信息在同一预算下的等边际条件(开放)。
- 四个场景,各对应回路的一条边与一个 \(\Lambda\) 量级。
- 一张方法表。所有方法的空白汇成同一个缺口:Q3 曲线的形状。它同时是第一部的开放问题与本章平衡点定理的前提。
跨部连线
- 第三部第 4 章「一句「不知道未来」,四种严格化」:同一个"边做边学"的困难,在资源分配里有四种严格化,各自给出不同的性能语言。
- 第三部第 5 章「第四级台阶」:预测的价值 \(V(I)\) 与本章的环境知识汇率,可以放进同一个平衡条件(第二部 7.7 节的双信息回路,尚未证明)。
- 第四部 9.8 节:探测者不止一个时,"谁去感知、测多密、给不给别人看"成了群体决策问题。
开放问题#
Q5.1(\(\Delta C\) 曲线的第一组数)【开放·本站提法】
- 精确陈述:在第一部第 10 章的单反射面玩具族上,对 \(R_{\mathrm{env}}\in\{1,2,\dots,20\}\) 比特的环境描述(反射面位置 / 材质的量化),计算 \(\Delta C(R_{\mathrm{env}})=\sup[C(\text{prior}+\text{env code})-C(\text{prior})]\),判定其形状属于三条候选中的哪一条。
- 已知工具:第 3 章定理 3.5 的间接率失真给出"每比特能换多少任务效用"的编码论上界;第 2 章 Q2.5 的夹逼关系给出亏格上界。
- 第一步可证引理:单反射面 + 两径模型下,\(\Delta C\) 在 \(R_{\mathrm{env}}\to\infty\) 处的极限 \(\Delta C_{\max}\) 是反射系数与几何的闭式。
- AI 可攻子问题:在校准射线追踪(第一部第 5 章:3–6 dB RMSE)的仿真环境里数值扫描 \(\Delta C\) 对环境描述比特数。
这是本章一切结论的前提。
Q5.2(认知平衡点的可证伪检验)【开放·本站提法】
在可控 \(T_{\mathrm{env}}\) 的试验台上测"吞吐最优感知占比"随 \(T_{\mathrm{env}}\) 的标度:\(\ln\Lambda/\Lambda\) 对常数。
第一步:数字孪生仿真中人为设置散射体移动周期,扫 \(T_{\mathrm{env}}\) 三个数量级。
Q5.3(认知回路的严格版本:对偶控制的稳态极限)【开放】
定义 5.4 是玩具:线性获取、指数折旧、可加汇率。
- 精确陈述:对一个 POMDP(环境状态马尔可夫链,相干时间 \(T_{\mathrm{env}}\);动作 = 份额 \(\alpha\);观测 = 感知输出;回报 = 传输速率),证明其长期平均最优策略在 \(T_{\mathrm{env}}\to\infty\) 时收敛到命题 5.1 的平衡点,并给出有限 \(T_{\mathrm{env}}\) 的修正项。
- 已知工具:Bar-Shalom–Tse 判据 [2] 保证问题非平凡;分离间隙随后验收缩消失的经验规律 [18]【预印本·未评审】。
- 第一步可证引理:两状态环境("墙在 / 不在")、二元感知信道的 POMDP 显式解。
Q5.4(可加性与"并")【开放·本站提法】
§5.6 与定义 5.6 都假设汇率对层 / 对信息种类可加。命题 3.2(d) 说任务的公共知识是"交只有不等式",暗示汇率更可能是并的函数。
精确陈述:\(\Delta C(q_1,q_2)\ge\Delta C_1(q_1)+\Delta C_2(q_2)\)(互补)还是 \(\le\)(替代)?在两径模型上算出 \(\Delta C(\text{方向},\text{能量比})\) 的交叉项符号。
Q5.5(三元 region 的外界)【开放·本站提法】
命题 5.4 只给内界。
精确陈述:在定义 5.5 的前提下,给出 \(\mathcal{R}_T\) 的任何非平凡外界。候选形态是把 ISAC 的容量–失真 converse [10] 与第 2 章定理 2.4 的风险界叠加:\(\rho\ge\) 由 \(\gamma_{\mathrm{k}}\) 决定的亏格下界。
第一步:证明在 \(\epsilon=\epsilon_{\max}\) 切片上 \(J(\alpha)\) 曲线本身是外界(即定义 5.4 的稳态是该切片的最优)。
Q5.6(\(T_{\mathrm{env}}\) 的可测定义)【开放·文献共识】
环境时变尺度没有统一的可测量定义,本章三层数字全是量级估计。
精确陈述:以第一部第 8 章的环境等价类 \([E]_\varepsilon\) 为对象,定义 \(T_{\mathrm{env}}(\varepsilon):=\)"环境离开当前等价类的平均时间",并给出从 CSI 时间序列估计它的统计量。它与 CSI 相干时间的关系(后者是易逝品的 \(T\))应当是 \(T_{\mathrm{env}}\gg T_{\mathrm{coh}}\),比值即 \(\Lambda\) 的一个因子。
预告
本章全程假设知识描述的就是当前环境:回路里只有折旧,没有误配。换城市、换厂商、仿真到实网时,\(q\) 里存的可能是别处的环境,折旧率再低也没用。这是第二种退化,后面几章接着处理:
- 第 4 章的相位 / 结构二分(泛化半径 \(\lambda/4\) 对特征尺度 \(L\))处理的就是这种误配。
- 第 6 章把本章的 \(\alpha^\star\) 与第 2 章的亏格接成一条三环链的数值预算。
- 第 7 章把"Q3 形状的可证伪判据"作为本部对第一部的反馈写进纲领。
参考文献#
- A. A. Feldbaum, 《Dual control theory, I–IV》, Avtomatika i Telemekhanika, vol. 21, no. 9, pp. 1240–1249; no. 11, pp. 1453–1464, 1960; vol. 22, no. 1, pp. 3–16; no. 2, pp. 129–142, 1961(俄文原刊);英译 Automation and Remote Control, vol. 21, pp. 874–880, 1033–1039; vol. 22, pp. 1–12, 109–121。英译比原刊晚出(前两部分的英译刊于 1961 年),各库年份不一由此而来,本站按原刊写 1960–1961。https://www.mathnet.ru/eng/at12149
- Y. Bar-Shalom, E. Tse, 《Dual effect, certainty equivalence, and separation in stochastic control》, IEEE Trans. Automatic Control, vol. 19, no. 5, pp. 494–500, Nov. 1974. https://www.semanticscholar.org/paper/4a7b9c2b542d656e7c6a7bfe36f6c94237842c72
- R. A. Howard, 《Information value theory》, IEEE Trans. Systems Science and Cybernetics, vol. 2, no. 1, pp. 22–26, 1966. https://doi.org/10.1109/TSSC.1966.300074
- K. Chaloner, I. Verdinelli, 《Bayesian experimental design: A review》, Statistical Science, vol. 10, no. 3, pp. 273–304, 1995. https://projecteuclid.org/journals/statistical-science/volume-10/issue-3/Bayesian-Experimental-Design-A-Review/10.1214/ss/1177009939.full
- L. Zheng, D. Tse, 《Communication on the Grassmann manifold: A geometric approach to the noncoherent multiple-antenna channel》, IEEE Trans. Inf. Theory, vol. 48, no. 2, pp. 359–383, Feb. 2002. DOI: 10.1109/18.978730. https://web.stanford.edu/~dntse/papers/grassmann.pdf
- B. Hassibi, B. M. Hochwald, 《How much training is needed in multiple-antenna wireless links?》, IEEE Trans. Inf. Theory, vol. 49, no. 4, pp. 951–963, 2003. https://authors.library.caltech.edu/records/y6rsb-e9851
- S. Haykin, 《Cognitive radar: A way of the future》, IEEE Signal Processing Magazine, vol. 23, no. 1, pp. 30–40, Jan. 2006. https://ui.adsabs.harvard.edu/abs/2006ISPM...23...30H/abstract
- A. Mesbah, 《Stochastic model predictive control with active uncertainty learning: A survey on dual control》, Annual Reviews in Control, vol. 45, pp. 107–117, 2018. https://www.sciencedirect.com/science/article/abs/pii/S1367578817301232
- F. Liu, W. Yuan, C. Masouros, J. Yuan, 《Radar-assisted predictive beamforming for vehicular links: Communication served by sensing》, IEEE Trans. Wireless Commun., vol. 19, no. 11, pp. 7704–7719, 2020. https://discovery.ucl.ac.uk/id/eprint/10117126/
- M. Ahmadipour, M. Kobayashi, M. Wigger, G. Caire, 《An information-theoretic approach to joint sensing and communication》, IEEE Trans. Inf. Theory, vol. 70, no. 2, pp. 1124–1146, 2024(arXiv:2107.14264, 2021). https://arxiv.org/abs/2107.14264
- Y. Xiong, F. Liu, Y. Cui, W. Yuan, T. X. Han, G. Caire, 《On the fundamental tradeoff of integrated sensing and communications under Gaussian channels》, IEEE Trans. Inf. Theory, vol. 69, no. 9, pp. 5723–5751, Sept. 2023. https://arxiv.org/abs/2204.06938
- H. Hua, T. X. Han, J. Xu, 《MIMO integrated sensing and communication: CRB-rate tradeoff》, IEEE Trans. Wireless Commun., vol. 23, pp. 2839–2854, 2024. https://arxiv.org/pdf/2209.12721
- S. Lu, F. Liu, Y. Li, et al., 《Integrated sensing and communications: Recent advances and ten open challenges》, IEEE Internet of Things Journal, vol. 11, no. 11, pp. 19094–19120, 2024. https://arxiv.org/abs/2305.00179
- Y. Zeng, J. Chen, J. Xu, et al., 《A tutorial on environment-aware communications via channel knowledge map for 6G》, IEEE Communications Surveys & Tutorials, 2024. https://arxiv.org/abs/2309.07460
- X. Xu, Y. Zeng, 《How much data is needed for channel knowledge map construction?》, arXiv:2312.06966, 2023.【预印本·未评审;给出的是 AMSE 对采样密度,不是容量增益】 https://arxiv.org/abs/2312.06966
- 《A survey on integrated sensing, communication, and computation》, arXiv:2408.08074, 2024.【预印本·未评审;三维取"计算"而非"决策",未定义性能区域】
- U. Demirhan, A. Alkhateeb, 《Radar aided 6G beam prediction》, arXiv:2111.09676 / IEEE WCNC 2022. https://arxiv.org/abs/2111.09676
- T. Baltussen, et al., 《The separation principle and the dual–certainty equivalence gap in MPC》, arXiv:2604.06045, 2026.【预印本·未评审】 https://arxiv.org/abs/2604.06045
- D. Bykhovsky, 《Coherence time evaluation in indoor optical wireless communication channels》, Sensors, vol. 20, no. 18, art. 5067, 2020. https://doi.org/10.3390/s20185067 (测的是室内光无线信道,不是射频信道)
未单列的备查条目:Torgersen 1991 的 \(k\)-亏格与 Le Cam 1964 的风险界按第 2 章参考文献 4、5编号引用;Shannon 1953 信息格与 Dobrushin–Tsybakov 间接率失真按第 3 章参考文献 1、3。