5 · 共享世界模型的协商:多智能体 LLM 缺的那块地基#
先交代本章的底子:本章是本部文献最薄的一章。硬的定理只有三条:
- Newman 定理:共享随机性最多省对数级话费 [1]。
- 误配信源编码的 KL 罚项:用错模型编码,每符号多付 \(D(p\|q)\) 比特。这是信息论教科书的标准结果。
- 推测解码的接受率 \(=1-\mathrm{TV}(p,q)\)(Leviathan–Kalman–Matias 2023 [2])。
其余内容都是本站的探索性提法,一律标【探索·本站提法】:
- 把三者排成一条"共享的阶梯"。
- 把推测解码读成两个智能体的协商协议。
- "自学的协议逼近下界但不能移动下界"。
- 章末关于"模型不一致的协商话费下界"的猜想。
还要先改正一个说法:推测解码的效率被两模型的散度锁死,这个结论不是本站最先看出来的。Daliri–Musco–Suresh 等 2024 已把它写成"无通信耦合"问题 [3],Kobus–Gündüz 2025 已把它与信道合成并列 [4](两篇均为【预印本·未评审】)。本站能做的,是把这块硬砖接进多智能体协商的话费表里。
为什么值得写一章?因为它正对着 2026 年的一个现实。两个 LLM 智能体协作完成一项任务,每一轮对话就是一轮通信。它们都装着近似相同的世界模型:同一批预训练数据,可能同一个基座,不同的微调版本。
经典通信复杂度问的是"两方算一个函数最少要说多少比特"。有共享随机性的版本也齐了(第三部第 6 章第一课已立 Yao 模型与公共硬币)。但"两方共享一个生成模型、但版本略有不同"的通信复杂度,目前不存在。多智能体 LLM 缺的就是这块地基:模型一致时协商最少要说多少话?模型不一致时多付多少?
本章沿本部导读的通信轴前进。第 4 章问"协调需要多少比特"(协调容量、解概念决定话费量级),本章问"共享模型能省多少比特、模型不一致要多付多少"。它是第二部收尾三块警示牌里"公共知识要花钱"这一块的第二站。
本章预备知识
只需初等概率(离散分布、期望、几何级数)与信息论基础(熵、条件熵、KL 散度、总变差)。用到的站内内容:
- 熵、条件熵、KL 散度"用错模型的罚款单":预备篇 4.1–4.4。
- Yao 双方模型、确定性 / 公共硬币 / 私有硬币复杂度、判等问题 \(\mathrm{EQ}_n\) 的 \(n+1\) 比特与公共硬币 2 比特:第三部第 6 章第一课。
- 两小区最小 CSI 交换 \(C(\varepsilon)\lesssim56\) 比特:同上第四节。
- 用错译码度量的速率损失是一个平均 KL(GMI,引理 4.2):第二部第 4 章。
- 格的交是划分、Gács–Körner 公共信息是它的熵:第二部第 3 章备注。
- 团队与博弈的分水岭、分散化代价 3.02% / 8.00%:第 2 章算例 2.2;嵌套亏欠 \(\nu\) 与相边界 \(d\le p\):第 3 章定义 3.4、命题 3.8。
- 大模型分割推理与分层代价 PoL:第三部第 7 章。
本章统一记号:
5.1 两个医生会诊:共享模型如何压缩语言#
两个合作了二十年的外科医生站在手术台前,一个说"老办法,先做左边",另一个点头,方案就定了,只用了四个字。换两个从未见过面的医生,同样的方案要从头解释:病人的病史、影像上的哪一处阴影、为什么先左后右、失败了怎么办,要说几千字。
两组人说的是同一种语言,面对同一个病人,要做同一个决定。差别在于共享的模型。老搭档脑子里有一个几乎相同的"世界如何运转"的模型,所以一句话只需要指出"这一次与默认情形的差别在哪",其余由对方脑中的模型补齐。用信息论的话说,消息可以按条件描述长度压缩:给定共享模型,只需描述模型没预测到的那一部分。
但老搭档也有一个陌生人没有的风险:以为对方懂了。两人的模型只要稍有不同,比如一个人上个月读了一篇新文献,改了对某种并发症的概率估计,"老办法"这四个字在两人脑子里就会展开成两套不同的方案,而且谁也不知道对方展开的是另一套。共享模型压缩了语言,也把"模型差异"藏进了每一句话里。
这就是本章要精确化的两件事:
- 共享模型值多少? 两人模型完全一致时,比起两个陌生人,协商能省多少话。
- 模型不一致要多付多少? 两人模型相差 \(\varepsilon\) 时,要么多说话,要么多犯错,罚项是 \(\varepsilon\) 的什么函数。
把它接到本部的六个新输入表上:这一章讨论的是通信预算 \(B\) 这一行的第二个问题。除了"能说多少话",还要问"以什么模型说"。第 4 章已经说明,同一个问题要"纯 Nash"还是"相关均衡",话费差一个指数(Hart–Mansour)。本章说明,同一个问题两人共享什么,话费又差一个量级。
直觉:为什么这是多智能体 LLM 的问题而不是人的问题
人类搭档的"共享模型"没法量化:两个人脑里的模型没有可比的表示。
LLM 智能体不同:它们的世界模型就是一个显式的条件分布 \(q(\text{下一个词}\mid\text{上文})\),两个智能体的模型差异可以逐字算出 \(\mathrm{TV}\) 或 KL。于是"以为对方懂了"从一句文学描写变成了一个可以算的量,"协商话费"从一个管理学话题变成了一个通信复杂度问题。这一章能写,全靠这一点。
到此为止我们得到了什么:
- 一个问题的两个半边:共享模型让消息可以按条件描述长度压缩(值多少?),但模型的微小差异会藏在压缩后的每句话里(多付多少?)。
- 这个问题为什么在 LLM 时代变成可算的。
5.2 通信复杂度的三级共享:无共享、共享随机、共享模型#
先回忆舞台。第三部第 6 章第一课的 Yao 模型是这样的:Alice 持 \(x\in\{0,1\}^n\),Bob 持 \(y\in\{0,1\}^n\),两人按事先约定的协议交替发比特,最后有人报出 \(f(x,y)\)。确定性复杂度 \(D(f)\) 是最坏输入下的最少总比特数。
允许随机化后有两种版本:
- 私有硬币:各自的随机数对方看不见,复杂度记为 \(R^{\mathrm{priv}}_\varepsilon(f)\)。
- 公共硬币:双方都看得见同一串随机比特,复杂度记为 \(R^{\mathrm{pub}}_\varepsilon(f)\)。
下标 \(\varepsilon\) 是允许的错误概率。
第三部已经给了一个极端的例子:判等 \(\mathrm{EQ}_n\) 的确定性话费是 \(n+1\) 比特,而公共硬币协议只要 2 比特。协议是这样的:把公共随机串的前 \(2n\) 位读成两个随机向量,Alice 发出 \(x\) 与这两个向量内积的奇偶,Bob 用 \(y\) 算同样两个奇偶来比对。
共享随机性把线性打到常数。读到这里,读者理应产生一个念头:共享的东西越多,话费越少,那共享一个整个世界模型,岂不是能省到极致?
本章要给的第一个答案出人意料:共享随机性其实很不值钱,判等只是个特例。
5.2.1 三级共享的定义#
定义 5.1(三级共享的通信模型)【零级、一级、一级半:标准;二级:探索·本站提法】
固定任务 \(T\)(一个函数 \(f(x,y)\),或更一般地一个联合决策 \(a(x,y)\) 与损失 \(L\))。
- 零级·无共享。 双方除协议本身外不共享任何东西,随机数各自私有。度量:\(D(T)\) 与 \(R^{\mathrm{priv}}_\varepsilon(T)\)。
- 一级·共享随机。 双方额外看到同一串与输入独立的随机比特。度量:\(R^{\mathrm{pub}}_\varepsilon(T)\)。
-
一级半·共享先验。 双方额外共同知道输入 \((x,y)\) 服从的一个联合分布 \(\mu\)。度量:Braverman–Rao 的信息复杂度 \(\mathrm{IC}(T,\mu)\)。它是协议 transcript 向双方泄露的关于对方输入的信息量 [5],即 \(I(\Pi;X\mid Y)+I(\Pi;Y\mid X)\) 在所有能完成 \(T\) 的协议上的最小值。transcript 指双方发出的全部消息按顺序连成的记录,记为随机变量 \(\Pi\)。
Braverman–Rao 证明它等于摊销通信:输入按 \(\mu\) 抽取、一次同时完成 \(n\) 个独立副本时,平均每个副本所需的最少比特数在 \(n\to\infty\) 时的极限。下文对照表里的 \(\lim_nD_\mu(f^{\otimes n})/n\) 说的就是这件事。
-
二级·共享生成模型。 双方各持一个生成模型 \(M_1,M_2\)(可对输入、对消息、对世界状态给条件分布),并且允许 \(M_1\ne M_2\),差异以 \(\mathrm{TV}\) 或 KL 度量为 \(\varepsilon\)。度量【探索·本站提法】:在真实模型 \(M\) 下正确完成 \(T\) 的最坏比特数 \(\mathrm{CC}_\varepsilon(T)\),\(\varepsilon=0\) 时退化为上面几级。
这个定义在说什么
前三级是通信复杂度教科书的标准分层,本站没有发明它们。层与层之间的差是有定理的:下面的定理 5.1 给一级与零级之差,Braverman–Rao [5] 给一级半的精确含义。
第四级是本站加的一层:把"共享先验 \(\mu\)"推广成"共享一个可采样的生成模型",并且允许两端的版本不一致。多智能体 LLM 恰恰住在这一级:模型是生成式的,消息是模型采出来的,两端的版本从来不完全相同。
flowchart TB
    L0["零级 · 无共享<br/>确定性或私有硬币<br/>Yao 1979:<br/>$$D(f)$$、$$R^{\mathrm{priv}}(f)$$"]
    L1["一级 · 共享随机<br/>公共硬币 $$R^{\mathrm{pub}}(f)$$<br/>Newman 1991:<br/>与零级最多差 $$O(\log n)$$"]
    L15["一级半 · 共享先验 $$\mu$$<br/>信息复杂度 $$\mathrm{IC}(f,\mu)$$<br/>Braverman–Rao 2011"]
    L2["二级 · 共享生成模型<br/>$$M_1\approx M_2$$<br/>条件描述长度、<br/>误配罚项 $$D(p\|q)$$<br/>核验协议接受率 $$1-\mathrm{TV}$$<br/>【探索·本站提法】"]
    L0 -->|"加一串公共随机比特"| L1
    L1 -->|"加一个双方共知的输入分布"| L15
    L15 -->|"先验变成可采样的生成模型,且允许两端版本不一致"| L2
怎么读这张图:从上到下,双方共享的东西越来越"厚"。前三级是标准通信复杂度的分层,每一步的层差都有定理。最后一步是本章加的一层,它的度量 \(\mathrm{CC}_\varepsilon(T)\) 目前只有定义、没有定理,这就是本章标题里那块"缺的地基"。
5.2.2 Newman 定理:公共随机性最多省对数级#
现在给出零级与一级之差的定理。
定理 5.1(Newman:公共随机性最多省对数级)【已解决(经典)】
对任意 \(f:\{0,1\}^n\times\{0,1\}^n\to\{0,1\}\) 与 \(\varepsilon,\delta>0\),
这个不等式的意思是:任何公共硬币协议都可以用一个私有硬币协议模拟,多付的话费是输入长度的对数,与函数 \(f\) 无关 [1]。
Newman 原文的写法
\(O(\log n+\log(1/\delta))\) 这一加性形式是后来教科书的写法。Newman 原文的定理 1.1 写成 \(C^{\mathrm{pri}}_{(1+\delta)\varepsilon}(f)=O\big(C^{\mathrm{com}}_{\varepsilon}(f)+\log\frac{n}{\varepsilon\delta}\big)\)。
原文里,复杂度按最坏输入上的期望比特数计,出错概率按乘性放宽,公共比特的话费外面还套着一个常数因子。结论相同,都是只差对数项。
证明思路(三步)
第一步:公共随机串其实只需要多项式多个。 设公共硬币协议 \(\Pi\) 用随机串 \(r\),对每个固定输入 \((x,y)\) 出错概率 \(\le\varepsilon\)。独立抽取 \(t\) 个随机串 \(r_1,\dots,r_t\)。
对固定的 \((x,y)\),"在这 \(t\) 个串上出错的比例超过 \(\varepsilon+\delta\)"是 \(t\) 个独立 0/1 变量均值偏离期望 \(\delta\) 以上的事件。这里第 \(j\) 个变量是"原协议用 \(r_j\) 时是否出错"的 0/1 指示量,期望 \(\le\varepsilon\)。Hoeffding 不等式给它的概率 \(\le e^{-2\delta^2t}\)。
Hoeffding 不等式说的是:独立、取值在 \([0,1]\) 内的随机变量,样本均值比期望高出 \(\delta\) 以上的概率随样本数 \(t\) 指数下降,上界就是这个 \(e^{-2\delta^2t}\)。数字感觉:\(\delta=0.1\) 时,\(t=100\) 给 \(e^{-2}\approx0.14\),\(t=1000\) 给 \(e^{-20}\approx2\times10^{-9}\)。
第二步:对所有输入取并。 输入共 \(2^{2n}\) 个,每个输入各有一个第一步那样的"坏事件"。至少一个坏事件发生的概率不超过各自概率之和(联合界),即 \(\le2^{2n}e^{-2\delta^2t}\)。
只要它 \(<1\)(两边取自然对数:\(2n\ln2-2\delta^2t<0\)),也就是
就存在一组 \(\{r_1,\dots,r_t\}\),使得对每一个输入,在这 \(t\) 个串上的出错比例都 \(\le\varepsilon+\delta\)。
这一步做了什么:把"对每个输入平均过全部 \(2^{|r|}\) 个随机串"换成了"平均过一个固定的、大小 \(t=O(n/\delta^2)\) 的样本集"。为什么可以:概率方法。坏事件的概率之和小于 1,所以存在一个全都不坏的样本集。这组串写进协议,成为协议的一部分(双方事先都知道)。
第三步:用私有硬币选下标。 Alice 用自己的私有硬币在 \(\{1,\dots,t\}\) 里均匀抽一个下标 \(i\),把 \(i\) 发给 Bob,然后两人按 \(r_i\) 跑原协议。发下标要 \(\lceil\log_2t\rceil=\log_2n+2\log_2\frac1\delta+O(1)\) 比特。
出错概率 \(\le\varepsilon+\delta\):对任一固定输入,\(i\) 均匀时的出错概率恰是"这 \(t\) 个串里出错的串所占的比例",第二步已保证它 \(\le\varepsilon+\delta\)。下标比特数的式子来自 \(t\approx n\ln2/\delta^2\):\(\log_2t=\log_2n+2\log_2\frac1\delta+\log_2\ln2\),末项是常数。\(\blacksquare\)
物理意义
一串大家都看得见的随机数,只值"报一个下标"的钱。
判等那个 \(n+1\to2\) 的坍缩,并不说明共享随机性有多神奇。原因是判等的确定性复杂度恰好高得反常。私有硬币的判等也只要 \(O(\log n)\) 比特,公共硬币把 \(O(\log n)\) 再压到 \(O(1)\),省的那一截正好是 Newman 说的对数。
行为分析
- (i) 对任何公共硬币复杂度已经达到 \(\Omega(\log n)\) 的问题,两种模型只差常数因子。绝大多数有意思的问题都是这样。
- (ii) 数量级:\(n=1024\) 比特输入、\(\delta=0.1\) 时,\(t\approx n\ln2/\delta^2\approx7.1\times10^4\),下标要 \(\lceil\log_2t\rceil=17\) 比特。\(n=2^{20}\) 时 27 比特。一百万比特的输入,共享随机性一共只值 27 比特。
- (iii) 注意 \(\delta\) 进的是 \(\log(1/\delta)\):要把错误概率的松动压到 \(\delta=0.01\),也只多付 7 比特。
- (iv) 定理说的是"至多省这么多",不是"总能省这么多"。它是一个负面结果:共享随机性不是万能钥匙。
5.2.3 三级共享的对照表#
下面把三级并成一张表。这是本章的第一张核心对照表【探索·本站提法:前三行标准,第四行为本站加的一级】。
| 级 | 双方共享的是什么 | 能省多少(相对上一级) | 代表定理 | 口径 | 状态 |
|---|---|---|---|---|---|
| 零级 | 只有协议 | — | Yao 1979;\(D(\mathrm{EQ}_n)=n+1\)(第三部第 6 章) | 最坏情形总比特 | 【已解决(经典)】 |
| 一级 | 一串独立于输入的随机比特 | 最多 \(O(\log n+\log\frac1\delta)\)(定理 5.1) | Newman 1991 [1] | 最坏情形总比特 | 【已解决(经典)】 |
| 一级半 | 输入的联合分布 \(\mu\) | 从"最坏输入"换成"典型输入":\(\mathrm{IC}(f,\mu)=\lim_n D_\mu(f^{\otimes n})/n\) | Braverman–Rao 2011 [5] | 摊销、每副本比特 | 【已解决】 |
| 二级 | 一个可采样的生成模型,两端版本相差 \(\varepsilon\) | 一致时可省相关知识的全部(5.3 节,每符号 \(I(X;Y)\));不一致时罚项 \(D(p\|q)\) 每符号(定理 5.3)、核验接受率 \(1-\mathrm{TV}\)(定理 5.4) | 本章 5.3–5.6 节 | 每符号速率 / 每 token 接受率 | 【探索·本站提法】 |
陷阱:三种口径不能放进同一列相加
表里有三种量纲:
- 零级、一级是最坏情形一次性总比特(Yao、Newman、以及第 4 章的 Hart–Mansour [6])。
- 一级半是摊销到每个副本的比特(\(n\to\infty\))。
- 二级的 KL 罚项与接受率是每符号 / 每 token 的量。
第三部的 \(C(\varepsilon)\lesssim56\) 比特属于第一种口径。把 \(I(X;Y)\) 与 56 比特直接相加是硬伤,第 4 章的"协商话费表"因此分栏,本章沿用。
到此为止我们得到了什么:
- 一把三级(外加半级)的阶梯:无共享、共享随机、共享先验、共享生成模型。
- 一条负面定理:共享随机性最多值 \(O(\log n)\) 比特,一百万比特的输入也只值 27 比特。
- 一张分口径的对照表,它的最后一行是本章的探索区。
5.3 为什么共享模型值钱、共享随机不值钱:两条定理并排#
上一节的表里,一级"最多省对数",二级"可省相关知识的全部"。这两句话并排就是本章的第一个判断。先把二级的"值钱"说清楚。
5.3.1 共享相关的知识:每符号省 \(I(X;Y)\)#
Alice 有一串 \(X^n\),要让 Bob 知道它。若 Bob 什么都不知道,无损描述至少要 \(H(X)\) 比特每符号(预备篇 4.1)。
若 Bob 手里有一串与 \(X^n\) 相关的边信息 \(Y^n\)(联合 i.i.d. 服从 \(p(x,y)\)),Alice 即使不知道 \(Y^n\) 的具体取值,也只需 \(H(X\mid Y)\) 比特每符号。这是 Slepian–Wolf 1973 的定理【已解决(经典)】。省下的是
比特每符号(预备篇 4.3)。
Bob 的边信息就是一个"共享模型"的最朴素形态:两人都知道 \(X\) 与 \(Y\) 怎么相关(\(p(x,y)\) 是公共知识),Bob 手里又有 \(Y\)。
为什么 Alice 不看 \(Y^n\) 也够:分箱(binning)
事先把所有可能出现的 \(X^n\)(约 \(2^{nH(X)}\) 个典型序列,见预备篇 4.5)随机分进 \(2^{nR}\) 个箱子,分法写进协议,双方都知道。
- Alice 只报 \(X^n\) 落在哪个箱,花 \(nR\) 比特。
- Bob 手里有 \(Y^n\),与它对得上(联合典型)的候选 \(X^n\) 只有约 \(2^{nH(X\mid Y)}\) 个。
- 只要 \(R\) 略大于 \(H(X\mid Y)\),箱子就比候选多得多,Alice 报的那个箱里几乎肯定只有一个候选与 \(Y^n\) 对得上,Bob 把它挑出来即可。
分箱规则不依赖 \(Y^n\),所以 Alice 用不着看到 \(Y^n\),她只需知道 \(p(x,y)\) 来定 \(R\)。
这个省法可以省到几乎全部。设 \(X\) 是 \(n\) 比特均匀串,\(Y\) 是 \(X\) 过一条翻转概率 0.1 的二元对称信道。每比特 \(H(X\mid Y)=h(0.1)=0.469\)。计算用链式法则:\(H(X\mid Y)=H(X)+H(Y\mid X)-H(Y)=1+h(0.1)-1\)。\(X\) 均匀时 \(Y\) 也均匀,给定 \(X\) 后 \(Y\) 只剩"翻不翻"这一枚概率 0.1 的硬币。
于是省下 \(1-0.469=0.531\) 比特,也就是 53% 的话费。\(n=1024\) 时省 544 比特。对比定理 5.1,共享随机性在同样的 \(n\) 上最多省 \(O(\log n)=O(10)\) 比特量级。
5.3.2 两种共享的省钱上限#
命题 5.2(两种共享的省钱上限)【已解决(经典)·本站并列】
在各自的口径下:
- 共享相关知识(双方共知 \(p(x,y)\),接收方持 \(Y^n\)):无损描述 \(X^n\) 的最少速率从 \(H(X)\) 降到 \(H(X\mid Y)\),每符号省 \(I(X;Y)\),可以是 \(H(X)\) 的任意大比例(Slepian–Wolf)。
- 共享独立随机性(双方共知一串与输入独立的随机比特):计算任何函数 \(f\) 的最坏话费最多省 \(O(\log n+\log\frac1\delta)\) 比特(定理 5.1)。
本站判断【探索·本站提法】:多智能体 LLM 的"共享世界模型"值钱的部分是相关知识,共享随机性几乎不值钱。两个智能体共用一个随机种子几乎不省话。共用一个"世界怎么运转"的条件分布,省的是每一句话里模型能预测的那一部分。
证明。 两条各自是经典定理。本站做的只是把它们放在一起并指出口径:第 1 条是 \(n\to\infty\) 的每符号速率,第 2 条是最坏情形总比特。\(\blacksquare\)
物理意义
为什么一条能省几乎全部,另一条只省对数?因为"随机性"与"知识"在信息论里是两种完全不同的资源。
- 公共随机串与输入独立,不含任何关于 \(x,y\) 的信息。它只能让协议"对称地随机化"。Newman 的第二步说,这种随机化只需要多项式多个样本就能代表,所以值一个下标。
- 边信息 \(Y\) 与 \(X\) 相关,它本身就是关于 \(x\) 的信息。每一比特互信息,都是 Bob 不用再听的一比特。
行为分析
- (i) 极限:\(Y\) 与 \(X\) 独立时 \(I(X;Y)=0\),共享模型退化为共享随机,省钱归零,两级重合。
- (ii) \(Y=X\) 时省 \(H(X)\),全部话费归零。这是"老搭档"极限:模型一致到对方已经知道答案,一个字都不用说。
- (iii) 第二部第 3 章的 Gács–Körner 备注在这里有一个回响。可以零通信各自算出的公共部分(GK 公共信息 [8])一般远小于 \(I(X;Y)\)。Slepian–Wolf 省下的 \(I(X;Y)\) 里,只有 GK 那一小块是"不用说就都知道"的,其余仍要靠编码把相关性用起来。Wyner 公共信息 [9] 是第三种量,三者排序 \(K_{\mathrm{GK}}\le I(X;Y)\le C_{\mathrm{Wyner}}\)。
陷阱:Newman 说的是「算函数」;「合成样本」时共享随机性反而必需
定理 5.1 的对象是函数计算。若任务不是算一个函数,而是让双方的动作服从一个给定的联合分布(第 4 章的协调问题),情形反过来。
Cuff–Permuter–Cover 证明了下面的结论 [7]:
- 经验协调(只要求动作对的经验频率逼近目标,第 4 章定义 4.2;强协调见定义 4.3)不需要公共随机性。
- 强协调(整条序列的分布在总变差意义下逼近目标)要把通信压到 \(I(X;Y)\),就得买够公共随机性。不买的话,所需通信速率升到 Wyner 公共信息 \(C(X;Y)\)(原文定理 10)。完全不通信时则非买不可(原文定理 9)。
5.8 节的阶梯话费表里会看到同一件事:两端要共同持有同一个来自 \(p\) 的样本时,公共随机性把 \(H(p)\) 比特的话费打到零。所以"共享随机不值钱"要加限定词:对算函数不值钱,对合成样本是必需品。
多智能体 LLM 的协商既有算函数的成分(决定选哪个方案),也有合成样本的成分(两边生成一致的文本)。两种账要分开算。
到此为止我们得到了什么:
- 本章第一个判断:共享模型值钱在相关知识(每符号可省 \(I(X;Y)\),可达 53% 乃至全部),共享随机性最多省 \(O(\log n)\)。
- 这个判断的限定词:它说的是算函数,合成样本时公共随机性是必需资源。
5.4 模型不一致的话费 = KL:误配编码定理#
现在把两人的模型拧歪一点。Alice 的世界模型说某事件的概率是 \(p\),Bob 的说是 \(q\)。Alice 想让 Bob 听懂,所以用 Bob 认得的码,按 Bob 的模型说话。每个符号要多付多少?
答案是信息论里最常被引用又最少被证明的定理之一。
5.4.1 误配信源编码的 KL 罚项#
定理 5.3(误配信源编码的 KL 罚项)【已解决(经典)·本站搬运】
设符号 \(X\sim p\),而编码器使用为分布 \(q\) 设计的码。
-
理想码长版。 若对 \(x\) 使用理想码长 \(\ell_q(x)=\log_2\frac1{q(x)}\)(算术编码在长块极限下可达),则期望码长恰为
\[ \mathbb{E}_p\big[\ell_q(X)\big]=H(p)+D(p\|q). \] -
整数码长版。 若使用 \(q\) 的 Shannon 码 \(\ell_q(x)=\big\lceil\log_2\frac1{q(x)}\big\rceil\),则
\[ H(p)+D(p\|q)\;\le\;\mathbb{E}_p\big[\ell_q(X)\big]\;<\;H(p)+D(p\|q)+1. \] -
下界。 任何前缀码在 \(p\) 下的期望码长 \(\ge H(p)\)。所以 \(D(p\|q)\) 就是"用错模型"相对于"用对模型"的每符号多付,且 \(D(p\|q)\ge0\),等号当且仅当 \(p=q\)。
证明
第一步:把期望码长拆成两项。
这一步做了什么:在对数里乘除同一个 \(p(x)\)。为什么可以:\(p(x)>0\) 处恒等式成立,\(p(x)=0\) 的项贡献为零。这就证明了第 1 条。
第二步:整数码长夹在中间。 \(\lceil u\rceil\in[u,u+1)\) 对每个 \(x\) 成立,两边乘 \(p(x)\) 求和即得第 2 条的两个不等号。
Shannon 码的码长满足 Kraft 不等式 \(\sum_x2^{-\ell_q(x)}\le\sum_xq(x)=1\)。逐项看:\(\ell_q(x)\ge\log_2\frac1{q(x)}\),即 \(2^{-\ell_q(x)}\le q(x)\)。
Kraft 不等式是前缀码存在的充要条件:一组整数码长 \(\ell(x)\) 能做成前缀码,当且仅当 \(\sum_x2^{-\ell(x)}\le1\)。前缀码指没有哪个码字是另一个码字的开头,因而收到即可逐个译出。所以确实存在这样的前缀码。
第三步:\(D\ge0\) 与任何码的下界。 对任意满足 Kraft 不等式的码长 \(\ell\),令 \(r(x)=2^{-\ell(x)}/\sum_{x'}2^{-\ell(x')}\),则 \(\ell(x)=\log_2\frac1{r(x)}-\log_2Z\),其中 \(Z=\sum_{x'}2^{-\ell(x')}\le1\)(Kraft)。所以 \(-\log_2Z\ge0\),\(\mathbb{E}_p\ell\ge\sum_xp(x)\log_2\frac1{r(x)}\)。
再套第一步的拆分(把 \(q\) 换成 \(r\)),右端 \(=H(p)+D(p\|r)\ge H(p)\)。最后一步用 KL 非负(Gibbs 不等式,预备篇 4.4)。等号条件 \(p=q\) 同样来自 Gibbs 不等式。\(\blacksquare\)
物理意义
\(D(p\|q)\) 是"用 Bob 的世界观说 Alice 看到的世界"的每符号罚款。它在第二部已经出现过一次:第二部引理 4.2 证明,用错译码度量的速率损失 \(I-\mathrm{GMI}\) 是"真实后验与接收机以为的后验之间的平均 KL 散度"。信道侧与信源侧的误配代价是同一种货币:你以为的世界与真实世界之间的信念差距。
行为分析
- (i) 不对称:\(D(p\|q)\ne D(q\|p)\)。谁的模型是"真的"、谁在迁就谁,罚款不同(算例 5.1 给数字)。
- (ii) 发散:\(q(x)\to0\) 而 \(p(x)>0\) 时 \(D\to\infty\)。对方认为不可能的事,你要说清楚需要无穷多话。这是"以为对方懂了"最恶性的形态:根本说不通。
- (iii) 小差异时是二阶的:对光滑参数族,\(D(p\|q)\approx\frac{(p-q)^2}{2q(1-q)\ln2}\)(Bernoulli 情形)。罚项随差异平方增长:模型差一点,几乎不罚,差很多,罚得凶。这一条在 5.8 节与总变差的一阶行为对照时会成为猜想的关键。
二阶近似的推导(Bernoulli 情形)
把 \(D\) 看成 \(p\) 的函数,在 \(p=q\) 处做 Taylor 展开:
- 函数值为 0。
- 一阶导 \(\frac1{\ln2}\big(\ln\frac pq-\ln\frac{1-p}{1-q}\big)\) 在 \(p=q\) 处也为 0。
- 二阶导 \(\frac1{\ln2}\cdot\frac1{p(1-p)}\),在 \(p=q\) 处取值再乘 \(\frac12(p-q)^2\) 即得。
5.4.2 算例:两个智能体的概率估计不同#
算例 5.1(两个智能体对同一事件的概率估计不同:KL 罚项)【本站演算】
两个智能体的世界模型对"下一时隙这条链路会中断"这一事件的概率分别为 \(p=0.1\)(Alice,权威版本)与 \(q=0.2\)(Bob)。Alice 用 Bob 的码描述中断序列,每符号多付
反过来 Bob 用 Alice 的码:
两个方向不对称:\(D(p\|q)/D(q\|p)=0.0529/0.0641\approx0.83\)。两个方向的真实分布与所用的码正好对调:前者世界按 \(p=0.1\) 走,码按更悲观的 \(q=0.2\)(高估中断)设计。后者世界按 \(q\) 走,码按更乐观的 \(p\) 设计。
在这组数字上,迁就"更悲观"的模型比迁就"更乐观"的模型便宜约 17%。相对于 \(H(p)=h(0.1)=0.4690\) 比特的基本话费,罚项占 11.3%。
校验(三条独立途径)
- 交叉熵恒等式。 直接算 \(-\sum_xp(x)\log_2q(x)=-0.1\log_20.2-0.9\log_20.8=0.2322+0.2897=0.5219\)。而 \(H(p)+D(p\|q)=0.4690+0.0529=0.5219\)。两条途径一致,也就是定理 5.3 第 1 条。
- 退化情形。 \(q=p=0.1\) 时两项 \(0.1\log_21+0.9\log_21=0\),罚项为零。\(D\ge0\) 在两个方向上都成立。
- 发散行为。 固定 \(p=0.1\),让 \(q\to0\):\(q=0.05\) 时 \(D=0.030\),\(q=0.01\) 时 \(0.208\),\(q=10^{-3}\) 时 \(0.529\),\(q=10^{-6}\) 时 \(1.524\)。它按 \(0.1\log_2(0.1/q)\) 无界增长,与定理 5.3 行为分析 (ii) 一致。二阶近似 \(\frac{(0.1)^2}{2\cdot0.2\cdot0.8\ln2}=0.045\) 与精确值 \(0.0529\) 同量级。差异 \(0.1\) 已不算小,近似偏低 15%。
到此为止我们得到了什么:
- 模型不一致的第一块硬砖:用错模型编码,每符号多付 \(D(p\|q)\) 比特(完整证明)。
- 这个罚项不对称,在对方认为不可能处发散,在小差异处是二阶的。
- 它与第二部 GMI 的速率损失是同一种货币。
5.5 推测解码:接受率 \(=1-\mathrm{TV}(p,q)\)#
第二块硬砖来自一个完全不同的方向,即加速大模型推理的工程技巧,但它说的是同一件事。
5.5.1 协议:提议与核验#
一个小模型(草稿模型,分布 \(q\))与一个大模型(目标模型,分布 \(p\))要联合生成文本,要求输出严格服从 \(p\)。Leviathan–Kalman–Matias 2023 [2](Chen 等 2023 同期独立提出 [10])的做法是:
- 小模型按 \(q\) 提议一个 token \(x\);
- 大模型以概率 \(\min\{1,\,p(x)/q(x)\}\) 接受;
- 若拒绝,大模型从残差分布 \(p'(x)=\dfrac{\max\{0,\,p(x)-q(x)\}}{\sum_{x'}\max\{0,\,p(x')-q(x')\}}\) 重采一个 token。
一轮里小模型可以连提 \(\gamma\) 个草稿,大模型并行核验,第一个被拒的位置之后全部作废。
用本章的眼光看,这是一个两智能体协议:一方"提议",另一方"核验",双方共享一个近似的模型。它的效率(每轮能接受几个 token)就是"共享模型不一致时协商能有多快"。
5.5.2 接受率与正确性#
定义 5.2(Leviathan 等的散度 \(D_{LK}\) [2, 定义 3.2])
\(D_{LK}(p,q):=\sum_x\big|p(x)-M(x)\big|\),其中 \(M=\tfrac12(p+q)\) 是中点混合。
一句点破
\(|p(x)-M(x)|=\big|p(x)-\tfrac{p(x)+q(x)}2\big|=\tfrac12|p(x)-q(x)|\),所以
\(D_{LK}\) 就是总变差,不是新的散度。它取值 \([0,1]\),对称,\(=0\iff p=q\),\(=1\iff\) 支撑不交([2] 推论 3.4)。原文用中点混合写它,初读容易误以为是另一个量。
定理 5.4(Leviathan–Kalman–Matias:推测解码的正确性与接受率 [2, 引理 3.3、定理 3.5])【已解决】
上述协议的输出严格服从 \(p\);单个 token 被接受的概率为
当 \(p,q\) 随上文(已生成的前缀)变化时,\(\beta\) 也随之变化。对上文取平均记 \(\alpha=\mathbb{E}[\beta]=\mathbb{E}\big[\sum_x\min\{p,q\}\big]\)([2] 推论 3.6)。
证明
接受率(两行)。 接受事件的概率是"提议 \(x\)"乘"接受 \(x\)"对 \(x\) 求和:
再用恒等式 \(\min\{a,b\}=\tfrac{a+b}2-\tfrac{|a-b|}2\),得
正确性(三行)。 输出为 \(x\) 有两条路:被提议且被接受,或被拒后从残差抽到。
- 第一条路概率 \(q(x)\min\{1,p/q\}=\min\{p(x),q(x)\}\)。
- 第二条路概率 \((1-\beta)\cdot p'(x)\)。残差的归一化常数 \(\sum_{x'}\max\{0,p-q\}=\sum_{x'}\big(p(x')-\min\{p,q\}(x')\big)=1-\beta\),所以第二条路概率恰为 \(\max\{0,p(x)-q(x)\}\)。
两路相加:\(\min\{p,q\}+\max\{0,p-q\}=p(x)\)。\(\blacksquare\)
物理意义
接受率就是"两个模型重叠的那部分质量"。重叠越多,提议越少被驳回。模型散度直接换算成协商的通过率。
这与定理 5.3 是同一现象的另一种度量:那里用 KL 数比特,这里用 TV 数被驳回的提议。两种度量由 Pinsker 不等式相连:
其中 \(D\) 以比特计。算例 5.1 的数字:\(\mathrm{TV}(p,q)=|0.1-0.2|=0.1\),右端 \(\sqrt{0.5\ln2\times0.0529}=0.135\ge0.1\),成立。
行为分析
- (i) \(p=q\):\(\beta=1\),草稿全收。这是"老搭档"极限。
- (ii) 支撑不交:\(\beta=0\),每个提议都被驳回,协议退化为大模型自己生成。这是"陌生人"极限。
- (iii) 随机化的位置:接受/拒绝的硬币与残差重采都在核验方手里,提议方不需要知道 \(p\)。这个不对称正是 5.8 节阶梯表的一个台阶。
5.5.3 每轮期望产出#
推论 5.5(每轮期望产出 token 数 [2])【已解决】
每轮提 \(\gamma\) 个草稿,各位置接受事件 i.i.d.、概率 \(\beta\),则一轮期望产出(含被拒位置或末位由大模型补出的那一个)
证明。 接受的草稿数 \(K\in\{0,\dots,\gamma\}\),\(\Pr[K\ge k]=\beta^k\)(前 \(k\) 个都接受,\(k\le\gamma\))。于是
第一个等号是非负整数变量的尾和公式:\(K=\sum_{k=1}^{\gamma}\mathbf{1}\{K\ge k\}\),\(K\) 等于几就有几个指示量为 1,两边取期望即得。
再加上大模型每轮必出的一个 token(拒绝时的残差样本,或全收时的第 \(\gamma+1\) 个),总数 \(1+\sum_{k=1}^\gamma\beta^k=\sum_{k=0}^\gamma\beta^k\)。几何级数求和:\((1-\beta)\sum_{k=0}^\gamma\beta^k=1-\beta^{\gamma+1}\)。\(\blacksquare\)
算例 5.2(草稿长度 \(\gamma=4\)、三种接受率的期望产出与加速上限)【本站演算】
\(\gamma=4\),接受率 \(\beta\in\{0.7,0.8,0.9\}\):
| \(\beta\) | \(\sum_{k=0}^4\beta^k\) 逐项 | 期望产出 | 大模型每次运行的加速上限(草稿免费) |
|---|---|---|---|
| 0.7 | \(1+0.7+0.49+0.343+0.2401\) | 2.773 | 2.77× |
| 0.8 | \(1+0.8+0.64+0.512+0.4096\) | 3.362 | 3.36× |
| 0.9 | \(1+0.9+0.81+0.729+0.6561\) | 4.095 | 4.10× |
"加速上限"是指草稿模型运行成本忽略不计时(\(c=0\),见 5.6 节),大模型每运行一次产出的 token 数,它就是期望产出本身。
校验
- (i) 闭式与逐项相加一致:\(\beta=0.7\),\((1-0.7^5)/(1-0.7)=(1-0.16807)/0.3=2.7731\),与逐项和 \(2.7731\) 相同。另两行同理(\(3.3616\)、\(4.0951\))。
- (ii) 极限:\(\beta\to1\) 时逐项和 \(\to\gamma+1=5\),闭式 \(\lim_{\beta\to1}(1-\beta^5)/(1-\beta)=5\)(洛必达),即全部草稿加一个补位 token。\(\beta\to0\) 时 \(\to1\),只剩大模型自己那一个。
- (iii) 与 Leviathan 实测对照:表 2 报告 T5-XXL、EnDe 任务、\(\gamma=7\)、T5-small 草稿 \(\alpha=0.75\) 时实测加速 \(3.4\times\)。把 \(\alpha=0.75,\gamma=7,c\approx0\) 代入 \((1-0.75^8)/0.25=3.60\),与实测差约 6%。原文附录 A.3 把偏差归因于 i.i.d. 接受假设与实现细节。
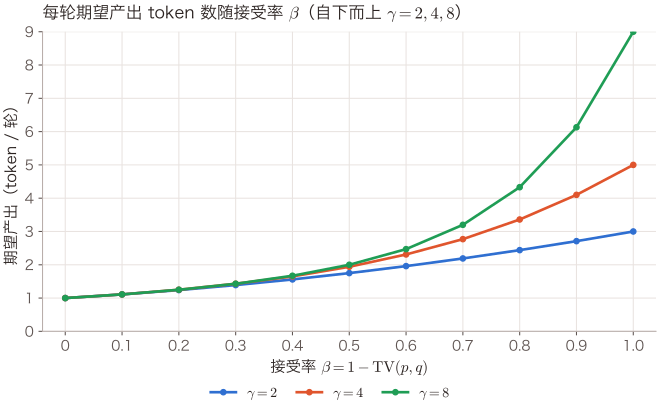
怎么读这张图:数据由推论 5.5 的闭式 \((1-\beta^{\gamma+1})/(1-\beta)\) 代入 \(\beta\in\{0,0.1,\dots,1\}\) 得到,三条线自下而上是 \(\gamma=2,4,8\)。横轴从右往左读就是"模型差多少":\(\beta=1\)(模型一致)时产出 \(\gamma+1\),\(\beta=0\)(支撑不交)时产出 1。
三条线在 \(\beta\lesssim0.4\) 处几乎重合:模型差得多时,草稿提多长都没用。\(\beta\gtrsim0.8\) 之后才分开:只有模型很像时,多提几个才有回报。算例 5.2 的三个点落在中间那条线上。
到此为止我们得到了什么:
- 第二块硬砖:推测解码这个两智能体"提议–核验"协议输出严格服从 \(p\),单 token 接受率 \(=1-\mathrm{TV}(p,q)\)(两行证明),每轮期望产出 \((1-\beta^{\gamma+1})/(1-\beta)\)。
- 它与 KL 罚项由 Pinsker 不等式相连,说的是同一件事:模型散度锁死协作的效率。
5.6 加速不是接受率的单调函数:协商话费的内生最优点#
推论 5.5 的"期望产出"是免费草稿下的上限。草稿不免费,于是出现本章最好的一个教学点。
定理 5.6(Leviathan–Kalman–Matias:期望墙钟加速 [2, 定理 3.8、推论 3.9])【已解决】
记 \(c\) 为草稿模型单次运行时间与目标模型单次运行时间之比,\(\gamma\) 为每轮草稿数,\(\alpha\) 为期望接受率。则相对于目标模型逐 token 自回归生成,推测解码的期望墙钟(wall-clock,即实际经过的时间)加速为
且只要 \(\alpha>c\),就存在 \(\gamma\) 使 \(S>1\)。
推导(三步)
- 一轮的时间。 \(\gamma\) 次草稿运行加 1 次目标运行(并行核验 \(\gamma\) 个草稿算一次)。以目标模型单次运行为单位,是 \(\gamma c+1\)。
- 一轮的产出。 由推论 5.5,是 \((1-\alpha^{\gamma+1})/(1-\alpha)\) 个 token。这里把 \(\beta\) 换成期望值 \(\alpha\),是 [2] 的 i.i.d. 简化。
- 相除。 基线每单位时间产出 1 个 token,相除即得 \(S\)。
再证定理的第二句。取 \(\gamma=1\):分子 \(1-\alpha^2=(1-\alpha)(1+\alpha)\),与分母里的 \(1-\alpha\) 约掉,得
\(\blacksquare\)
物理意义
分子是"共享模型带来的省话":模型越像,一次核验通过越多。分母是"维护这个共享模型的成本":草稿越像目标,草稿本身越贵。协商的效率 = 省下的话 ÷ 为了能省话而付的代价。
行为分析
- (i) \(c\to0\):退化为推论 5.5 的上限。
- (ii) \(c>0\) 固定、\(\gamma\to\infty\):分子有界、分母线性增长,\(S\to0\)。草稿提得太长反而拖慢。
- (iii) 固定 \(c\),最优 \(\gamma^\star\) 有限【本站演算】:
- \(\alpha=0.75,c=0.05\) 时 \(\gamma^\star=7\)(\(S=2.67\));
- \(\alpha=0.9,c=0.05\) 时 \(\gamma^\star=13\)(\(S=4.67\));
- \(\alpha=0.75,c=0.2\) 时 \(\gamma^\star=3\)(\(S=1.71\))。
- (iv) 最重要的一条:\(S\) 对 \(\alpha\) 不单调。固定 \(c\) 时 \(S\) 随 \(\alpha\) 单调增(算例 5.3 后那张图的任一条线)。但在真实系统里 \(\alpha\) 与 \(c\) 不独立:更像目标的草稿模型通常也更大、更贵,换草稿模型时 \(\alpha\) 与 \(c\) 一起涨,\(S\) 可以反而下降(算例 5.3)。
算例 5.3(Leviathan 表 2 的三行:接受率更高却更慢)【本站演算·实测数据引自 [2]】
T5-XXL(11B)作目标模型,EnDe 翻译、贪心(\(T=0\))、\(\gamma=7\),三种草稿模型的实测接受率与实测加速 [2, 表 2]:
| 草稿模型 | 实测 \(\alpha\) | 实测加速 | 若 \(c=0\) 的理论上限 \(\frac{1-\alpha^8}{1-\alpha}\) | 由实测反推的 \(c\) |
|---|---|---|---|---|
| T5-small | 0.75 | 3.4× | 3.60 | 0.008 |
| T5-base | 0.80 | 2.8× | 4.16 | 0.069 |
| T5-large | 0.82 | 1.7× | 4.42 | 0.229 |
接受率 \(0.75\to0.82\) 单调上升,加速 \(3.4\to1.7\) 单调下降。原因全在 \(c\):把实测加速代回定理 5.6 解出 \(7c+1=\frac{1-\alpha^8}{(1-\alpha)S}\),得 \(c\approx0.008,\ 0.069,\ 0.229\)。T5-large 每次运行要花目标模型 23% 的时间,把 4.4× 的理论上限吃掉了六成。
校验
- (i) 代回:\(S(0.82,7,0.2286)=\frac{1-0.82^8}{0.18\times(7\times0.2286+1)}=\frac{0.7955}{0.18\times2.600}=1.70\),与实测一致。反推本身是恒等变形,此处验证的是数值无误。
- (ii) 推论 3.9 的 \(\gamma=1\) 下界 \(\frac{1+\alpha}{1+c}\):三行分别 \(1.74,\ 1.68,\ 1.48\),都 \(>1\)(\(\alpha>c\) 成立),且都低于对应实测值。\(\gamma=7\) 确实比 \(\gamma=1\) 更好,与"\(\gamma^\star\) 有限但大于 1"一致。
- (iii) T5-small 的反推 \(c=0.008\) 与"草稿比目标小两个数量级时 \(c\approx0\)"([2] §4.2 的口径)一致。这说明 3.4× 与 3.60 的 6% 差距几乎全来自 i.i.d. 假设,而不是草稿成本。
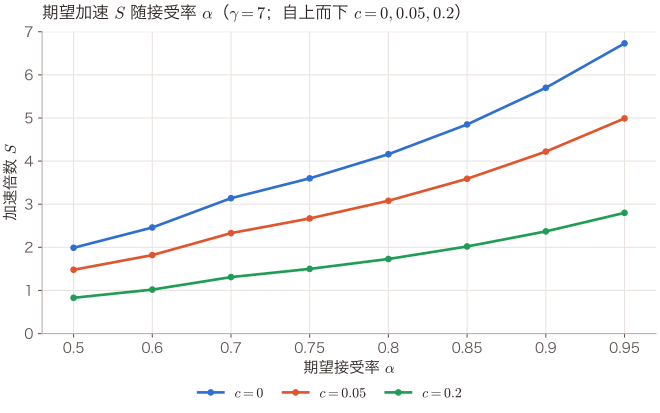
怎么读这张图:数据由定理 5.6 的 \(S(\alpha,7,c)\) 代入得到,自上而下 \(c=0,0.05,0.2\)。沿任一条线,加速随 \(\alpha\) 单调增:固定草稿成本时,模型越像越好。但真实系统不能沿一条线走,换更像的草稿模型意味着跳到更低的一条线上。
算例 5.3 的三个实测点 \((0.75,3.4)\)、\((0.80,2.8)\)、\((0.82,1.7)\) 分别落在 \(c\approx0.008\)、\(0.069\)、\(0.229\) 三条不同的线上,连起来是一条下降的折线。这就是"协商话费的内生最优点"。在本站的读法里【探索·本站提法】,让两个智能体的模型更一致本身有成本(更大的模型、更多的同步、更多的算力),最优的一致程度在中间,不在 \(\alpha=1\)。
5.6.1 同一个 TV,两级不同的接受率:无通信耦合#
推测解码的接受率 \(1-\mathrm{TV}\) 是有通信(核验方把接受/拒绝告诉提议方)时的最优耦合概率:两个边缘为 \(p,q\) 的随机变量最多以概率 \(1-\mathrm{TV}(p,q)\) 相等,这是耦合理论的经典事实。
耦合(coupling)指把两个随机变量 \(A,B\) 放进同一个随机实验里一起产生,只要求 \(A\) 单看服从 \(p\)、\(B\) 单看服从 \(q\),两者之间怎么相关由我们设计。
上界的理由:\(\Pr[A=B=x]\) 既不超过 \(\Pr[A=x]=p(x)\),也不超过 \(q(x)\),对 \(x\) 求和得
定理 5.4 的协议里"输出等于草稿"的概率恰为这个值,所以上界取得到。
Daliri–Musco–Suresh 等 2024 [3] 问了下一层的问题:若两端只共享随机性、零通信,各自从 \(p\) 与 \(q\) 采样,能以多大概率采到同一个值?
命题 5.7(Daliri 等:无通信耦合的可达一致概率 [3])【已解决】
两端共享随机串、零通信,Alice 从 \(p\)、Bob 从 \(q\) 各采一个样本 \(a,b\)。用 Weighted MinHash 或 Gumbel 采样等协议可达
而有通信的最优耦合给 \(\Pr[a=b]=1-\mathrm{TV}(p,q)\)。
零通信怎么可能对上:以 Gumbel 采样为例
公共随机串给每个候选值 \(x\) 配一个双方共用的随机数 \(G_x\)。不同 \(x\) 的 \(G_x\) 相互独立,都服从标准 Gumbel 分布。
- Alice 输出使 \(\ln p(x)+G_x\) 最大的 \(x\)。
- Bob 输出使 \(\ln q(x)+G_x\) 最大的 \(x\)。
经典的 Gumbel-max 技巧保证 Alice 的输出恰好服从 \(p\)、Bob 的恰好服从 \(q\)。而两人加的是同一组噪声,\(p\) 与 \(q\) 越接近,两个最大值落在同一个 \(x\) 上的机会越大。
物理意义
同一个模型差异 \(\mathrm{TV}\),落在阶梯的不同级上,给出不同的一致率:
- 一级(只共享随机):\(\frac{1-\mathrm{TV}}{1+\mathrm{TV}}\)。
- 一级加一轮核验通信:\(1-\mathrm{TV}\)。
具体数字:
- \(\mathrm{TV}=0.1\) 时 \(0.818\) 对 \(0.900\);
- \(\mathrm{TV}=0.3\) 时 \(0.538\) 对 \(0.700\);
- \(\mathrm{TV}=0.5\) 时 \(0.333\) 对 \(0.500\)。
通信买的是分母里那个 \(1+\mathrm{TV}\)。
Kobus–Gündüz 2025 [4] 进一步把推测解码与信道合成(channel simulation)并列,自述这一联系"允许对加速做信息论分析"。所以本站在此明确改口:推测解码效率由模型散度决定这一点,文献已有,并且已被显式做出。本站的贡献只是把它接进 5.2 节的阶梯与 5.8 节的话费表。
行为分析
\(\mathrm{TV}\to0\) 时两级重合于 1。模型一致时零通信也能同步采样,这是"老搭档"的极限形式。
这也是 5.3 节陷阱框那句"合成样本时公共随机性是必需品"的正面例子:两端都知道 \(p\)、又共享随机性,一个字不说就能生成同一段文本。\(\mathrm{TV}\to1\) 时两级都归零。
到此为止我们得到了什么:
- 加速公式 \(S=\frac{1-\alpha^{\gamma+1}}{(1-\alpha)(\gamma c+1)}\) 与它的非单调性:Leviathan 表 2 里接受率 0.82 只得 1.7×,而 0.75 得 3.4×,因为更像的草稿更贵。本站读法:协商话费有内生最优点。
- 同一个 TV 在阶梯两级上的两个一致率 \(\frac{1-\mathrm{TV}}{1+\mathrm{TV}}\) 与 \(1-\mathrm{TV}\)。这个联系文献已有(Daliri 等、Kobus–Gündüz),本站只做接线。
5.7 自学的协议逼近下界,不能移动下界:emergent communication 与通信复杂度#
多智能体深度学习有一支叫 emergent communication:不给智能体预设协议,让它们在任务奖励下自己学出一套"语言"(Lazaridou–Baroni 2020 综述 [11])。这支文献度量的是学到的协议的性质:组合性、拓扑相似度、消息熵。据本站的文献检索,没有一篇把学到的协议长度与该任务的通信复杂度下界做定量对照。
本节要立的判断很朴素,朴素到几乎不用证明,但它必须落到一个可算的任务上才可证伪。
5.7.1 学到的协议受通信复杂度下界约束#
命题 5.8(学到的协议受通信复杂度下界约束)【探索·本站提法;证明平凡,价值在可证伪的实例化】
设一组智能体通过任何学习过程得到一个通信策略,在任务 \(T\) 的所有输入上以错误概率 \(\le\varepsilon\) 完成 \(T\)。则该策略在最坏输入上的总通信量(以比特计)\(\ge R^{\mathrm{pub}}_\varepsilon(T)\)。若策略是确定性的,\(\ge D(T)\)。
学习可以逼近下界,不能移动下界。
证明。 学到的策略本身就是一个协议:每个智能体的网络是它的编码函数,采样时的随机数是私有硬币,共享的随机种子是公共硬币,消息是 transcript。通信复杂度下界对任何协议成立,所以对它成立。\(\blacksquare\)
物理意义
这条命题的用处是给 emergent communication 一个坐标系,而不是贬低它。把一个学到的协议放到 \((\text{任务},\ \text{比特数})\) 平面上,下界告诉你它离最优还有多远。没有这个坐标系,"学到了高效的协议"这句话没有参照物。
5.7.2 可证伪的实例:\(m\times m\) 博弈#
现成的模板是 Conitzer–Sandholm 2004 [12]:两个智能体各持自己在一个 \(m\times m\) 双人博弈里的支付矩阵,合作地找一个纯 Nash 均衡。\(m\) 是动作数。原文用 \(n\) 记动作数,本部改写为 \(m\),以免与玩家数 \(N\) 混淆。
原文定理 2、3(即第 4 章定理 4.8)给出:确定性上界 \(O(m^2)\),非确定性下界 \(\Omega(m^2)\),即使支付只取 0/1。也就是 \(\Theta(m^2)\) 比特,基本等于把整张矩阵说一遍。
"非确定性"复杂度是指:允许一位全知的提示者先给双方一段证据,双方再用通信验证它,证据长度与验证所发的比特一并计费。确定性协议是不用提示的特例(证据长度为零),所以非确定性下界自动也是确定性下界。
再把比特翻译成轮数(第 4 章推论 4.9)。在"每轮各出一个动作、对方只看到动作"的学习设定下,每人每轮最多传 \(\log_2m\) 比特,两人合计 \(2\log_2m\)。所以任何这样的学习算法在最坏情形至少需要
轮才能保证到达纯 Nash。这个结论对学习算法的具体形式不作假设,原文自称这是"唯一真正普适的下界"。
关于随机化协议的一点说明
严格说,从非确定性下界出发的这条换算直接覆盖确定性的学习过程。原文对随机化只在第 3 节括注一句:愚弄集方法给出的下界对非确定性通信复杂度成立,因而对随机化通信复杂度也成立。
这对不许出错的随机化协议是对的。若允许以小概率出错,非确定性下界一般不能直接搬用:对 \(n\) 比特输入的相等函数,愚弄集给出 \(n\) 比特下界,允许出错的随机化协议却只需 \(O(\log n)\) 比特。这时要另证随机化下界。
同一件事在 \(N\) 人二元动作博弈上是 Hart–Mansour 的 \(\Omega(2^N)\) 比特 [6](第 4 章)。
算例 5.4(两个 LLM 智能体在 \(m\times m\) 博弈上学出协议:轮数下界的数字)【本站演算】
设两个智能体各自把自己的支付矩阵编进提示词,靠多轮对话找纯 Nash。每轮每方只报出一个动作(\(\le\log_2m\) 比特)。
| 动作数 \(m\) | 最坏比特下界 \(\sim m^2\) | 每轮合计比特 \(2\log_2m\) | 轮数下界 \(m^2/(2\log_2m)\) |
|---|---|---|---|
| 4 | 16 | 4 | 4 |
| 8 | 64 | 6 | 10.7 |
| 16 | 256 | 8 | 32 |
| 64 | 4096 | 12 | 341 |
常数因子按 \(\Theta(m^2)\) 取 1,是量级示意。\(\Omega\) 隐含常数以 [12] 原文为准。
校验
- (i) \(m=4\) 一行用另一条途径:每人的 0/1 支付矩阵有 16 格、恰 16 比特,两人各说一遍是 32 比特上界,[12] 的下界是 \(\Omega(16)\)。每轮 4 比特,32 比特要 8 轮、16 比特要 4 轮。表中 4 轮是下界一侧,上界一侧是 8 轮,两者夹住真值,量级一致。
- (ii) 单调性:\(m^2/(2\log_2m)\) 从 \(m=4\) 到 \(64\) 增长 \(341/4\approx85\) 倍,而 \(m^2\) 增长 256 倍、\(\log_2m\) 增长 3 倍,\(256/3\approx85\),相符。
- (iii) 退化:\(m=2\) 时 \(4/2=2\) 轮。两人各报一次动作显然不够一般地定位 \(2\times2\) 博弈的纯 Nash(要先知道对方的偏好),下界 \(\ge2\) 轮不与常识冲突。
这条命题回答不了什么
- (i) 它给的是最坏情形下界。LLM 智能体面对的博弈往往有结构(稀疏、对称、先验集中),典型情形的话费可能远低于 \(m^2\)。那要用 5.2 节一级半的信息复杂度 \(\mathrm{IC}(T,\mu)\) 去算。
- (ii) 它把"一轮"等同于"一个动作",而 LLM 一轮可以说一段话(几百 token、几千比特)。那时轮数下界要除以每轮的比特预算,退化成"比特下界 ÷ 每轮预算"。
- (iii) 它假定协议对所有输入正确。学到的协议通常只在训练分布上正确,出了分布下界不再适用。这就是 5.8 节"模型不一致"要处理的。
到此为止我们得到了什么:
- 一条平凡但有用的命题:学到的协议也是协议,逃不出通信复杂度下界。
- 一个可证伪的实例:\(m\times m\) 博弈找纯 Nash 至少 \(\Theta(m^2)\) 比特、\(\Omega(m^2/\log m)\) 轮,\(m=64\) 时 341 轮。
- 这条命题的三个边界。
5.8 猜想:模型不一致的协商话费下界随散度增长#
现在把 5.4–5.6 节的两块砖砌到 5.2 节的阶梯上,并诚实地画出未知的部分。
5.8.1 先算一个能算的:阶梯话费表#
取一个最小的协商任务:两端要共同持有同一个来自 \(p\) 的样本("两人生成同一段文本、按权威模型 \(p\) 的分布")。它是两个 LLM 智能体协作生成的单 token 版本。结束时有两个要求:
- 两边手里必须是同一个 token,否则各写各的,文本对不上。
- 这个 token 必须按权威模型 \(p\) 的概率出现,否则输出被草稿版本拉偏。
话费问的就是:为了同时做到这两点,每个 token 要传几比特。
Alice 知道 \(p\),Bob 的版本是 \(q\)。让 Alice 同时知道 \(q\):推测解码里目标模型看得到草稿,等价于知道草稿的模型。在"版本"语境下,知道对方跑的是哪个版本只需 \(\log_2(\#\text{版本})\) 比特。
引理 5.9(核验–纠正协议的每符号话费上界)【本站演算】
两端共享随机性,Alice 知道 \(p,q\),Bob 只知道 \(q\)。协议:Bob 用公共随机串从 \(q\) 抽草稿 \(x\)(Alice 可本地复现);Alice 以 \(\min\{1,p(x)/q(x)\}\) 决定接受,发一个接受/拒绝标志;拒绝时从残差 \(p'\) 抽一个纠正符号发给 Bob。则输出严格服从 \(p\),且每符号期望通信量
其中 \((p-q)^+=\max\{0,p-q\}\)。Bernoulli 情形残差是单点分布,第二项为零,\(\bar{\ell}\le h(\mathrm{TV})\)。
证明。 正确性即定理 5.4(Bob 收到标志后照办,得到与 Alice 相同的输出)。标志是 Bernoulli\((\mathrm{TV})\) 序列(定理 5.4:拒绝概率 \(=\mathrm{TV}\)),长块熵编码每符号 \(h(\mathrm{TV})\) 比特。拒绝发生的比例为 \(\mathrm{TV}\),每次纠正符号至多 \(\lceil\log_2|\operatorname{supp}(p-q)^+|\rceil\) 比特。\(\blacksquare\)
把它与 5.4 节的误配编码放到同一张表上(任务相同:Bob 最终持有与 Alice 相同的、服从 \(p\) 的样本)【本站演算】:
| 阶梯位置 | 共享随机 | 模型 | 协议 | 每符号期望比特 | Bernoulli \(p=0.1,q=0.2\) 的数字 |
|---|---|---|---|---|---|
| 二级·一致 + 一级 | 有 | \(M_1=M_2=p\) | 两端各自用公共随机串采样 | 0 | 0 |
| 二级·一致,无一级 | 无 | \(M_1=M_2=p\) | Alice 采样后用 \(p\) 的码发 | \(H(p)\) | 0.469 |
| 二级·不一致,无一级 | 无 | Bob 只知 \(q\) | Alice 用 \(q\) 的码发(定理 5.3) | \(H(p)+D(p\|q)\) | 0.522 |
| 二级·不一致 + 一级 | 有 | Alice 知 \(p,q\) | 核验–纠正(引理 5.9) | \(\le h(\mathrm{TV})+\mathrm{TV}\lceil\log_2\lvert\operatorname{supp}^+\rvert\rceil\) | 0.469 |
| 二级·不一致 + 一级,零通信 | 有 | 各用自己的 | 无通信耦合(命题 5.7) | 0,但只能以概率 \(\ge\frac{1-\mathrm{TV}}{1+\mathrm{TV}}\) 一致 | 0 比特,一致率 \(\ge0.818\) |
第一行为什么是 0 比特
两端都知道 \(p\)、又看得见同一串公共随机数,就可以事先约定一个确定的采样规则,例如"把公共随机串的下一段读成 \([0,1)\) 上的均匀数 \(U\),输出累积概率 \(\sum_{x'\le x}p(x')\) 首次超过 \(U\) 的那个 \(x\)"(逆累积分布法)。
这样得到的 \(x\) 服从 \(p\)。两人代入的是同一个 \(U\)、同一个 \(p\),各自算出的 \(x\) 必然相同,一个比特都不用发。第二行去掉公共随机数,只能由 Alice 采样再把结果告诉 Bob,话费回到 \(H(p)\)。
第四行的 0.469 与第二行相等,是 \(h(0.1)=H(\mathrm{Bern}(0.1))\) 的巧合,因为这里恰好 \(\mathrm{TV}=p\)。换 \(q=0.3\) 就不再相等,见下。
这张表教了什么
- (i) 第一行对第二行:对合成样本任务,公共随机性值 \(H(p)\) 比特。这与 5.3 节陷阱框一致,也与 Cuff 的强协调需要公共随机性 [7] 一致。
- (ii) 第三行对第二行:模型不一致、没有公共随机性时,罚项是 \(D(p\|q)\),小差异下二阶(\(q=0.12\) 时仅 \(+0.003\) 比特)。
- (iii) 第四行对第一行:模型不一致、有公共随机性时,罚项是 \(h(\mathrm{TV})\approx\mathrm{TV}\log_2\frac1{\mathrm{TV}}\),小差异下几乎一阶(\(q=0.12\),\(\mathrm{TV}=0.02\),\(h=0.141\) 比特,比第三行的罚项大 50 倍)。
- (iv) 所以哪种协议更省,取决于 \(\varepsilon\) 与有没有公共随机性。\(q=0.2\) 时第四行 0.469 略优于第三行 0.522。\(q=0.3\)(\(\mathrm{TV}=0.2\))时第四行 \(h(0.2)=0.722\) 反而劣于第三行 \(0.469+0.168=0.637\)。
两种协议都只是上界。真正的下界在哪,不知道。
5.8.2 猜想#
猜想 5.10(共享模型协商的话费下界随散度增长)【探索·本站提法·开放】
设任务 \(T\) 定义在共享模型 \(M\) 之上(输入或世界状态由 \(M\) 生成,联合决策 \(a\)、损失 \(L\)),两个智能体各持版本 \(M_1,M_2\),\(\max\{\mathrm{TV}(M_1,M),\mathrm{TV}(M_2,M)\}\le\varepsilon\)(或以 KL 度量)。记 \(\mathrm{CC}_\varepsilon(T)\) 为在真实模型 \(M\) 下以给定精度完成 \(T\) 的最坏情形最少比特数(允许公共随机性)。猜想存在依赖于 \(T\) 的非减函数 \(\Phi_T\),\(\Phi_T(0)=0\),使
且在小 \(\varepsilon\) 处 \(\Phi_T\) 的形态由 KL 与 TV 夹住:存在 \(c_1,c_2>0\) 与"模型相关符号数" \(n_T\),使 \(c_1n_T\varepsilon^2\le\Phi_T(\varepsilon)\le c_2n_T\,\varepsilon\log_2\tfrac1\varepsilon\)。
已知的边界
- \(\varepsilon=0\):退化为经典通信复杂度(零级 / 一级),或有共享先验时的信息复杂度 \(\mathrm{IC}(T,\mu{=}M)\) [5]。两者都已解决。
- 单符号层面,无公共随机性时:罚项恰为 \(D(p\|q)\)(定理 5.3,\(\Theta(\varepsilon^2)\))。
- 单符号层面,有公共随机性时:核验–纠正给上界 \(h(\mathrm{TV})+\mathrm{TV}\log|\operatorname{supp}^+|\)(引理 5.9,\(\Theta(\varepsilon\log\frac1\varepsilon)\))。
- 零通信时:一致率 \(\ge\frac{1-\mathrm{TV}}{1+\mathrm{TV}}\)(命题 5.7)。
上界的两种形态就是猜想里夹住 \(\Phi_T\) 的两端的来源。但两端的地位不同:
- TV 型的 \(\varepsilon\log\frac1\varepsilon\) 来自引理 5.9 的协议,是一个真能做到的上界。
- KL 型的 \(\varepsilon^2\) 来自没有公共随机性时的精确罚项,猜想却把它放在有公共随机性时的下界一侧。这一端目前没有证明,只是"公共随机性也省不掉二阶罚项"这一猜测的形式化。
未知的边界
- (i) 任务级罚项的形态:\(\Phi_T\) 是 \(\Theta(\varepsilon^2)\) 还是 \(\Theta(\varepsilon\log\frac1\varepsilon)\),或介于其间。这取决于最优协议能否像误配编码那样"平滑地吸收"差异,还是必须像核验协议那样逐符号"硬判"。
- (ii) 可加性:罚项是否随模型相关符号数 \(n_T\) 线性相加,还是可以靠联合编码摊薄(Braverman–Rao 的摊销机制 [5] 提示后者可能)。
- (iii) "是谁的模型":\(\mathrm{TV}(M_1,M)\) 与 \(\mathrm{TV}(M_2,M)\) 是否对称地进入 \(\Phi_T\)。定理 5.3 的不对称性提示不是。
- (iv) 多方:\(N\) 个智能体在 message-passing 模型下的集合不交问题 DISJ 是 \(\Theta(nk)\) [13],提示 \(\Phi_T\) 随 \(N\) 至少线性增长,但这只是类比。DISJ 指各方持 \(\{1,\dots,n\}\) 的一个子集,判定交集是否为空,见第 4 章定理 4.11。\(k\) 是参与方数,即本章的 \(N\)。
- (v) 从比特到轮数:LLM 协商的自然单位是对话轮数,每轮预算 \(B\) 比特,\(\lceil\mathrm{CC}_\varepsilon(T)/B\rceil\) 轮只是平凡换算。轮数本身的下界(Hart–Mansour 的 \(\Omega(2^N/N)\) 型)在有模型不一致时未知。
第一步可证的引理
在 Bernoulli 单符号任务上,对"Alice 知 \(p,q\)、Bob 知 \(q\)、有公共随机性"的所有协议求每符号期望比特的精确最小值 \(\ell^\star(\varepsilon)\),并判断它在 \(\varepsilon\to0\) 时是 \(\Theta(\varepsilon^2)\) 还是 \(\Theta(\varepsilon\log\frac1\varepsilon)\)。这将直接判定猜想里夹住 \(\Phi_T\) 的两端哪一端是紧的。工具箱是现成的:单符号、二元,可以写成有限维线性规划。
为什么值得做
它是全站四条缺失 converse 在多智能体 LLM 上的落点。
第三部 \(C(\varepsilon)\) 问"两小区解到 \(\varepsilon\) 精度要多少比特"(\(\lesssim56\)),那里的 \(\varepsilon\) 是解的精度。猜想 5.10 的 \(\varepsilon\) 是模型的差异。
第 2 章猜想 2.6 的嵌套亏损 \(\nu_{\mathrm{b}}\) 与第 3 章定义 3.4 的嵌套亏欠 \(\nu\) 问"补齐信息结构要多少比特 / 几条链路"。猜想 5.10 问的是,即使结构补齐,话费也随"两人脑子里的世界不一样"而涨多少。
三者合起来才是多智能体协商的完整话费表:结构(第 3 章)× 精度(第三部)× 模型一致性(本章)。
5.8.3 从共享随机到共享模型:话费理论的路标#
| 年份 | 路标 |
|---|---|
| 1973 | Slepian–Wolf 边信息每符号可省 \(I(X;Y)\);Gács–Körner 公共信息远小于互信息 |
| 1975 | Wyner 第二种公共信息 |
| 1979 | Yao 双方通信复杂度模型 |
| 1991 | Newman 公共随机最多省对数级 |
| 2004 | Conitzer–Sandholm 通信复杂度作为博弈学习轮数下界 |
| 2010 | Cuff–Permuter–Cover 协调容量、强协调与公共随机率;Hart–Mansour 解概念决定话费量级 |
| 2011 | Braverman–Rao 信息复杂度、相对共享先验的话费 |
| 2016 | 深度学习时代 emergent communication 起步(Lazaridou–Baroni 2020 综述) |
| 2023 | Leviathan 等 推测解码、接受率 \(1-\mathrm{TV}\) |
| 2024–2025 | Daliri 等 无通信耦合、Kobus–Gündüz 推测解码与信道合成并列(预印本) |
| 2026 | 本站 三级共享阶梯、核验–纠正话费表、猜想 5.10 |
怎么读这张表:上半段(1973–1991)是零级与一级的经典理论,其中 1973 与 1991 两行并排就是 5.3 节的判断。中段(2004–2011)把"话费"接到博弈与共享先验上。2016 以后的三行是 LLM 时代的输入:自学协议、推测解码、无通信耦合。
本站在最后一行,做的是排阶梯与提猜想,不是新定理。年份与出处见文末参考文献。
到此为止我们得到了什么:
- 一张五行的阶梯话费表(合成样本任务,Bernoulli 数字 0 / 0.469 / 0.522 / 0.469 / 零通信一致率 0.818),它暴露出罚项的两种小 \(\varepsilon\) 形态:KL 的二阶与 TV 的近一阶。
- 一个把它们夹起来的猜想 5.10,写清已知(\(\varepsilon=0\) 退化、单符号两种上界)与未知(任务级形态、可加性、不对称性、多方、轮数)。
- 一条可以用有限维线性规划做出来的第一步引理。
5.9 场景与方法盘点#
5.9.1 五个场景#
多智能体 LLM 协作:对话轮数 = 通信轮数
两个(或 \(N\) 个)智能体协商一个联合决策:分工、路由、排班、联合写一份方案。每轮对话是一条 transcript,每轮的比特预算是 token 数乘 \(\log_2|\mathcal{V}|\)(\(\mathcal{V}\) 是词表;词表有 \(10^5\) 个 token 时每个 token 至多约 17 比特)。
本章给它的坐标系是:
- 任务的 \(\mathrm{CC}_0(T)\) 是下界(命题 5.8,\(m\times m\) 博弈上 \(\Theta(m^2)\))。
- 共享模型能省的是相关知识那一部分(命题 5.2)。
- 模型版本差 \(\varepsilon\) 要多付 \(\Phi_T(\varepsilon)\)(猜想 5.10,未知)。
工程上常见的"让所有智能体用同一个基座"就是把 \(\varepsilon\) 压到零。但算例 5.3 提醒:更一致的模型更贵,最优一致度在中间。
Agent 化的网络运维:数字孪生就是共享世界模型
多个运维智能体各自对着同一张网络的数字孪生做决策:一个管切换参数,一个管节能,一个管切片。孪生就是它们共享的 \(M\)。各智能体本地缓存的孪生副本是 \(M_i\),副本刷新周期决定 \(\varepsilon\)。
定理 5.3 说:副本过期到某处的概率被低估到接近零时,协商在那一处说不通(KL 发散)。这是"孪生漂移"的信息论价签,也是第 3 章算例 3.6 那条信息过期曲线在模型层面的对应物。
V2X 协同感知的语义层:共享地图 = 共享模型
两辆车不传原始点云,只交换"相对于共享高精地图的差异",这是条件描述长度的字面实现(5.1 节的老搭档)。地图版本不同,就是 \(M_1\ne M_2\):一辆车的地图里有一条新划的车道,另一辆没有,"前方左侧车道有障碍"这句话在两辆车里展开成两个不同的位置。
这与第一部第 7 章的地图学同构:地图是分布泛函,地图差异是模型差异。CKM 建库时"两个基站的地图有多少公共部分可以零率同步"(第二部第 3 章 Q3.6),在这里变成"两辆车的地图差 \(\varepsilon\) 要多付多少话"。
边缘–云推测解码:分割推理的第二种切法
第三部第 7 章的大模型分割推理是把一个模型按层切到端与云。推测解码是另一种切法:端上跑小模型草稿,云上跑大模型核验,上行只传接受/拒绝与纠正(引理 5.9 的话费)。
此时定理 5.6 里的 \(c\) 不再只是算力之比,还包含往返时延。一轮 \(\gamma\) 个草稿要等一次云端核验回来,所以有效的 \(c\) 是
量级。其中 \(\tau_{\text{target}}\) 是目标模型单次运行时间。一轮耗时从 \((\gamma c+1)\tau_{\text{target}}\) 变成 \((\gamma c+1)\tau_{\text{target}}+\text{RTT}\),除以 \(\tau_{\text{target}}\) 后写成 \(\gamma c_{\text{eff}}+1\) 的形式即得。这会把 5.6 节的折衷曲线整条往下压。
PoL 在这里的读法【探索·本站提法】:把"提议"与"核验"分到两层的代价,就是那条 \(c\) 曲线与 \(c=0\) 曲线之间的面积。
AI 空口的两侧模型:同一个模型的两个版本
3GPP 的 CSI 压缩两侧模型(UE 侧编码器、gNB 侧解码器)若由不同厂商分别训练,就是 \(M_1\ne M_2\) 的字面实例。第 2 章把它归为破坏部分嵌套的机制 M3,第三部第 6 章把互操作读成"建立公共知识的通信复杂度问题"(\(C(\varepsilon)\lesssim56\) 比特是解精度那一侧的账)。
本章补上模型一致性那一侧:两侧对码字分布的信念差 \(D(p_{\text{UE}}\|q_{\text{gNB}})\) 是每个 CSI 报告的额外罚项。互操作测试量的是这个 KL 有多大,而不只是"能不能通"。
5.9.2 方法盘点#
| 方法谱系 | 解决了什么 | 回答不了什么 | 缺的定理落在哪 |
|---|---|---|---|
| 通信复杂度下界(Yao;Newman [1];Hart–Mansour [6];Conitzer–Sandholm [12]) | 对任何协议有效的最坏情形比特下界;解概念决定量级;共享随机只值对数 | 只对函数计算;输入分布是最坏情形,不含"共享模型";不含模型不一致 | 猜想 5.10 的 \(\Phi_T\) |
| 信息复杂度(Braverman–Rao [5]) | 相对共享先验 \(\mu\) 的话费,摊销意义下精确等于通信 | 先验必须双方一致且正确;先验是输入分布,不是可采样的生成模型 | 猜想 5.10 的(ii)可加性、(iii)不对称性 |
| 协调容量(Cuff–Permuter–Cover [7],第 4 章) | 合成给定联合分布的最少速率;强协调要么买公共随机,要么多付通信 | 目标分布是给定且双方共知的;不含模型不一致;广播拓扑只有内外界 | 猜想 5.10 的 \(\varepsilon>0\) 部分 |
| 误配信源编码(定理 5.3) | 单符号、无公共随机下模型不一致的精确罚项 \(D(p\|q)\) | 只是编码任务,不是决策任务;不含公共随机;不含交互 | 从"编码一个符号"到"完成一个任务"的桥 |
| 推测解码 / 耦合(Leviathan [2];Daliri [3];Kobus–Gündüz [4]) | 有定理的两智能体核验协议:接受率 \(1-\mathrm{TV}\)、零通信一致率 \(\ge\frac{1-\mathrm{TV}}{1+\mathrm{TV}}\)、加速折衷 | 单向核验(一方权威);只管采样一致,不管决策质量;接受率是上界不是下界 | 引理 5.9 只是上界,下界未知 |
| emergent communication(Lazaridou–Baroni [11]) | 能在复杂任务上学出协议;度量协议的组合性、熵 | 无保证:不知道离下界多远;出训练分布即失效 | 命题 5.8 的坐标系有了,测量还没做 |
| 多智能体 LLM 工程(2024–2026 大量预印本) | 报告 token 削减比例;个别附录给粗略的信息论 token 下界 | 下界与具体任务、具体模型差异的关系未形式化;【预印本·未评审,本站不引用其百分比】 | 全部落在猜想 5.10 |
七行的"回答不了什么"指向同一个空位:没有一条定理以"共享的生成模型及其版本差异"为资源与变量,给出协商话费的下界。本部第 9 章缺失定理二(协商的最小话费)在 LLM 时代要补的,就是这一块。
到此为止我们得到了什么:五个场景各自对上本章的一块:
- LLM 协商对应命题 5.8 与猜想 5.10。
- 数字孪生对应定理 5.3 的发散。
- V2X 共享地图对应条件描述长度。
- 边缘–云推测解码对应定理 5.6 加时延。
- 两侧模型对应 KL 罚项。
七类方法的盲区落在同一处:以共享生成模型为资源的话费下界。
开放问题#
-
【开放·本站提法】猜想 5.10 的小 \(\varepsilon\) 形态。 任务级罚项 \(\Phi_T(\varepsilon)\) 是 KL 型的 \(\Theta(\varepsilon^2)\) 还是 TV 型的 \(\Theta(\varepsilon\log\frac1\varepsilon)\)。第一步:Bernoulli 单符号、有公共随机性、Alice 知 \(p,q\) 时所有协议的精确最小每符号比特 \(\ell^\star(\varepsilon)\),有限维线性规划可解。
-
【开放·本站提法】罚项的可加性。 \(n_T\) 个模型相关符号的总罚项是否等于单符号罚项之和,还是能靠联合编码摊薄。Braverman–Rao 的"信息 = 摊销通信" [5] 是摊薄机制的先例,但那里先验双方一致。
-
【开放】"共享生成模型"作为通信复杂度资源的形式定义。 5.2 节定义 5.1 的二级只是口头定义。要成为定理的对象,需要说清:模型是对输入的分布、对消息的分布还是对世界状态的分布;"版本差异"是逐条件分布的 TV 还是某种平均;以及谁知道谁的版本(引理 5.9 假定权威方知道对方版本)。
-
【探索·本站提法·待测量】emergent communication 的下界坐标系。 命题 5.8 给了坐标系,但没有任何一个已发表的 emergent communication 实验被放进去量过。最容易做的实验:\(m\times m\) 博弈找纯 Nash 的自学协议,测其最坏输入的比特数与 \(\Theta(m^2)\)、轮数与 \(\Omega(m^2/\log m)\) 的比值。
-
【已解决】核验协议的接受率是上界还是下界。 定理 5.4 的 \(1-\mathrm{TV}\) 是有通信耦合的最优一致率(耦合理论经典),命题 5.7 的 \(\frac{1-\mathrm{TV}}{1+\mathrm{TV}}\) 是零通信下的可达率。在最坏情形意义下它也是零通信的最优率:Bavarian 等 [14] 证明任何零通信协议都有 \((p,q)\) 使一致率不超过它,[3] 定理 2 给了更短的证明。但对某一对具体的 \((p,q)\),Gumbel 采样可以严格更好([3] 定理 3)。
-
【预印本·未评审】散度选错了,话费就算错了。 若干 2025 年工作指出:最小化 KL 与最大化接受率 \(\alpha\) 的全局最优点相同(都是 \(q=p\)),但在草稿模型容量受限时二者的最优解不同。这些工作是本站检索到的 2025 年预印本,未列入本章参考文献。这对猜想 5.10 的含义是:\(\Phi_T\) 用哪个散度写,不只是常数因子的差别,可能改变最优协议的形状。
-
【开放】从比特到轮数、从函数到决策。 LLM 协商的自然单位是轮,且任务是带损失的决策而非 0/1 函数。第三部第 5 章的 \(V(I)\)(\(I\) 比特值多少决策价值)与本章的 \(\mathrm{CC}_\varepsilon(T)\) 是同一条曲线的两个轴。把它们接起来,就是"两个模型相差 \(\varepsilon\) 的智能体,说 \(B\) 比特能拿到多少决策价值"。这条曲线目前一个点都没有。
参考文献#
- I. Newman, 《Private vs. common random bits in communication complexity》, Information Processing Letters, 39(2):67–71, 1991. https://doi.org/10.1016/0020-0190(91)90157-D
- Y. Leviathan, M. Kalman, Y. Matias, 《Fast Inference from Transformers via Speculative Decoding》, Proc. ICML 2023, PMLR 202, 2023. https://arxiv.org/abs/2211.17192
- M. Daliri, C. Musco, A. T. Suresh 等, 《Coupling without Communication and Drafter-Invariant Speculative Decoding》, Proc. IEEE ISIT 2025(arXiv:2408.07978). https://doi.org/10.1109/ISIT63088.2025.11195663
- S. Kobus, D. Gündüz, 《Speculative Decoding via Exponential Races》, arXiv:2504.15475, 2025.【预印本·未评审】 https://arxiv.org/pdf/2504.15475
- M. Braverman, A. Rao, 《Information equals amortized communication》, Proc. FOCS 2011;IEEE Transactions on Information Theory, 60(10):6058–6069, 2014. https://arxiv.org/pdf/1106.3595
- S. Hart, Y. Mansour, 《How long to equilibrium? The communication complexity of uncoupled equilibrium procedures》, Games and Economic Behavior, 69(1):107–126, 2010. https://math.huji.ac.il/hart/papers/comcom.pdf
- P. Cuff, H. Permuter, T. M. Cover, 《Coordination Capacity》, IEEE Transactions on Information Theory, 56(9):4181–4206, 2010. https://www.ee.bgu.ac.il/~haimp/Coordination_capacity_journal_thomas_cover_paul_cuff_permuter.pdf
- P. Gács, J. Körner, 《Common information is far less than mutual information》, Problems of Control and Information Theory, 2(2):149–162, 1973.
- A. D. Wyner, 《The common information of two dependent random variables》, IEEE Transactions on Information Theory, 21(2):163–179, 1975.
- C. Chen 等, 《Accelerating Large Language Model Decoding with Speculative Sampling》, arXiv:2302.01318, 2023. https://arxiv.org/abs/2302.01318
- A. Lazaridou, M. Baroni, 《Emergent Multi-Agent Communication in the Deep Learning Era》, arXiv:2006.02419, 2020. https://arxiv.org/abs/2006.02419
- V. Conitzer, T. Sandholm, 《Communication complexity as a lower bound for learning in games》, Proc. ICML 2004. https://www.cs.cmu.edu/~sandholm/communication.icml04.pdf
- M. Braverman, F. Ellen, R. Oshman, T. Pitassi, V. Vaikuntanathan, 《A tight bound for set disjointness in the message-passing model》, Proc. FOCS 2013.
- M. Bavarian, B. Ghazi, E. Haramaty, P. Kamath, R. L. Rivest, M. Sudan, 《Optimality of correlated sampling strategies》, Theory of Computing, 16(12):1–18, 2020. https://doi.org/10.4086/toc.2020.v016a012