6 · 学习动力学:一起学习会收敛,还是会混沌#
第 2 章到第 5 章问的都是静态的问题。给定"谁知道什么",最优方案是什么(第 2、3 章)?要把默契建立起来,要花多少比特(第 4、5 章)?这四章里的决策者都只出手一次。
本章按下播放键。同一个干扰博弈、同一批基站,反复玩下去,每个人都从自己看到的回报里学习。工程上这是最常见的形态:功控环、调度器、MARL 训练出来的策略、多运营商共享频谱的自适应算法,全都在"边做边学"。理论上,这里是本部第三条轴的入口:
当每个决策者都在学习时,别人就不是环境,是另一个也在变的学习者。目标在动。
本章的答案分成好消息和坏消息两半,两半都是定理。
好消息有两条:
- 第一条:只要每个人各自跑一个无后悔(no-regret)算法,大家动作的经验联合分布就自动落进粗相关均衡(CCE)集。不需要商量,也不需要知道别人在干什么(定理 6.3,完整证明在 6.3 节)。
- 第二条:如果博弈有势函数(干扰博弈常常有),任何"更优响应"路径有限步就停在一个纯 Nash 上(定理 6.5,Monderer–Shapley 1996 [1])。
坏消息只有一条,但分量不轻:这两条好消息都没有回答"你手里那台设备下一个时隙会怎么发"。第一条说的是时间平均,第二条说的是更优响应,都不是你实际在跑的算法。
把"时间平均"换成"末迭代"(last iterate),把"更优响应"换成"常步长的指数权重更新",收敛就可能变成极限环,甚至变成正 Lyapunov 指数的真混沌。文献里有两个例子:Sato–Akiyama–Farmer 2002 [4] 在零和博弈里,Palaiopanos–Panageas–Piliouras 2017 [5] 在势博弈里。
本章要立四样东西:
- 一条完整证明的 no-regret \(\Longrightarrow\) CCE(定理 6.3)。
- 一个能算到底的两小区功控势博弈(算例 6.1,势函数有闭式)。
- 一个无线版的分岔阈值(命题 6.11 与算例 6.2):\(\eta^\star=7.4536\),换成原始速率单位是 \(0.0932\)。文献没有这个数,标【本站演算】。
- 一条把"时间平均收敛"与"末迭代混沌"同时写成不等式的可算分离(命题 6.12):时间平均以 \(O(1/T)\) 收敛到混合 Nash,同一条轨道的 Lyapunov 指数却是 \(+0.32\)。
本章预备知识
需要:有限博弈与混合策略的基本记号(本章 6.2 节现给);一维映射的不动点与稳定性(\(|f'|<1\) 收敛);期望与方差的初等性质。不需要动力系统或博弈论的先修课。Li–Yorke 混沌、Lyapunov 指数、倍周期分岔都会在用到的地方给定义。
用到的站内内容:
- 在线凸优化与 regret 的定义:第三部第 4 章"写法 C · 知道对手最坏 → OCO 与竞争分析"。本章把那里的"对手最坏"换成"对手是另一个学习者"。这是同一个 regret,不同的对手模型。
- 强化学习的记号与 Q 学习:预备篇第 8 章(该章已预先链到本章)。
- 干扰、SINR、小区间协调:预备篇第 6 章。
- 协调需要多少比特、相关均衡的通信复杂度:第 4 章定理 4.6、4.7(到 Nash 指数、到相关均衡多项式),以及协调价签 \(1-h(\epsilon)\)(\(\epsilon=0.1\) 时 0.531 比特/时隙)。本章 6.2 节会说明,相关均衡需要的那个公共信号,价钱就是第 4 章算的那笔。
- 分散化代价与人各最优:第 2 章算例 2.2(3.02% / 8.00%)与定义 2.2。
- 相边界 \(d\le p\):第 3 章命题 3.8。
本部统一符号:\(N\) = 玩家 / 决策者数,\(m\) = 每人的动作数。文献里 Palaiopanos 等用 \(\varepsilon\) 记 MWU 的步长,本章保留 \(\varepsilon\),同时引入 \(\eta:=-\ln(1-\varepsilon)\) 作为"有效步长"(它就是指数权重法的标准学习率),两者一一对应。
6.1 两个学下棋的人:目标在动#
先讲一个不带公式的图像。
两个人对弈,谁也没有教科书,只能靠复盘。甲发现乙爱走某个开局,就练出一套针对它的应手。乙被打疼了,换开局。甲的应手失效,再练新的。每个人都在对一个正在变化的对手做优化。
单人学习不是这样。一个人在固定的环境里学习,环境的统计不随你的策略改变,这是一门成熟的理论:随机逼近收敛,\(Q\) 学习在有限 MDP 上以概率 1 收敛(预备篇第 8 章),甚至有样本复杂度。这些结论的证明都依赖同一件事:你面对的转移核和回报分布是平稳的。
多个学习者同时在场,这件事立刻失效。对甲来说,环境包含乙的策略,乙的策略随时间变,于是甲面对一个非平稳(non-stationary)的环境。工程上这叫 MARL 的"移动目标问题",理论上它叫"两个耦合的动力系统"。
无线里这个图像有一个极干净的实例。两个共信道的小基站,各自跑一个功率自适应环:谁看到自己的 SINR 掉了就加功率。甲加功率,乙的 SINR 掉,乙加功率,甲的 SINR 掉,甲再加。
这条"功率竞赛"每个做过干扰协调的人都见过,也都知道它会停在一个大家都用满功率、谁也不划算的地方。本章要问的是更细的三个问题:
- 它一定会停下来吗?
- 停下来的那个点是什么?是"最优"吗?
- 如果不停,它是在转圈(周期),还是在乱走(混沌)?这两者对工程的含义完全不同。
直觉:转圈和乱走的差别是"可不可预测"
转圈(周期轨道)是可预测的:你观察一个周期,就知道未来所有时刻的状态,可以据此做资源预留。乱走(混沌)不行:初值差 \(10^{-9}\),几十步之后差 \(O(1)\)。两者的时间平均可能一模一样,但一个能做前瞻调度,另一个不能。
本章的算例 6.2 会给出具体的数。在两带抢频带的例子里,有效步长取 \(\eta=13\):
- 一维映射上,初值差 \(10^{-9}\) 的两条轨道约 57 步后就相差 0.1 以上(Lyapunov 指数 \(0.32\),\(\ln(10^{8})/0.32\approx57\))。
- 二维系统里,两个小区各自的初值差 \(10^{-9}\),18 步后就各奔一条频带(命题 6.10)。
几十个时隙在 NR 里只是几十毫秒。
这里的 Lyapunov 指数(Lyapunov exponent)度量"两条挨得很近的轨道平均每一步分开多少倍"。一维映射 \(x_{t+1}=f(x_t)\) 上,相距 \(d_0\) 的两个初值走一步后相距约 \(|f'(x_0)|\,d_0\),走 \(n\) 步后约 \(d_0\prod_{t<n}|f'(x_t)|\)。取对数再按步平均,
\(\lambda<0\) 时距离逐步收缩,轨道被吸到不动点或周期轨道上。\(\lambda>0\) 时距离大致按 \(e^{\lambda n}\) 放大。上面的 57 步就是这样估出来的:从 \(10^{-9}\) 长到 \(0.1\) 要放大 \(10^{8}\) 倍,需要 \(n\approx\ln(10^{8})/\lambda=18.42/0.32\approx57\) 步。规则完全确定、却做不了长期预测,这就是本章说"混沌"时的操作性含义。
本章的三级台阶是这样搭的:
- 第一级(6.2–6.5 节,好消息):均衡的阶梯(Nash \(\subset\) CE \(\subset\) CCE);no-regret 自动落进 CCE;势博弈里更优响应必然收敛。读到这里,读者会以为"多智能体学习的问题解决了"。
- 第二级(6.6–6.8 节,坏消息):时间平均不等于末迭代。零和里轨道奔向边界;势博弈里指数权重更新也能混沌。但必须精确到"哪一个变体、哪一个步长、哪一类初值",否则就是错的。
- 第三级(6.9–6.10 节,收口):把博弈类、步长、观测噪声画成一张相图,指出哪一块是空白。
到此为止我们得到了什么
多智能体学习的困难有一个精确的名字,叫非平稳性。它在无线里的最小实例是两个基站的功率竞赛。本章要分别回答"停不停""停在哪""不停的话是转圈还是乱走"三个问题。
6.2 均衡的阶梯:Nash ⊂ CE ⊂ CCE#
6.2.1 一个贯穿本章的两小区例子#
两个共信道小基站,各自要为下一个时隙的业务选一条频带。可选的有两条:
- 频带 A:20 MHz,载频 3.5 GHz。独占时该小区的信噪比是 15(约 11.8 dB),频谱效率 \(\log_2(1+15)=4\) bit/s/Hz,速率 \(20\times4=80\) Mb/s。
- 频带 B:10 MHz,载频 700 MHz,链路预算好,独占时信噪比 31(约 14.9 dB),频谱效率 \(\log_2 32=5\) bit/s/Hz,速率 \(10\times5=50\) Mb/s。
如果两个小区选了同一条频带,它们互相干扰。取最坏情形(小区边缘、跨小区增益与自身增益相等),此时 SINR \(=\gamma/(1+\gamma)\):
我们把"代价"定义成相对最好情形的速率损失,并归一化到 \([0,1]\),即 \(c=(80-R)/80\)。除以 80 Mb/s,是因为这是任何一个小区能拿到的最大速率。例如 B 被两家占用时 \(c_B(2)=(80-9.7728)/80=0.877840\)。
表中最后一列的拥挤罚 \(D_e:=c_e(2)-c_e(1)\) 表示"这条带从独占变成共享,代价涨了多少":
| 独占(\(\ell=1\)) | 共享(\(\ell=2\)) | 拥挤罚 \(D_e\) | |
|---|---|---|---|
| 频带 A | \(c_A(1)=0\) | \(c_A(2)=0.761451\) | \(D_A=0.761451\) |
| 频带 B | \(c_B(1)=0.375000\) | \(c_B(2)=0.877840\) | \(D_B=0.502840\) |
这就是一个两人两动作的拥塞博弈(congestion game):每个小区选一条频带,代价只依赖于自己选的那条带上有几个人。后面所有的动力学都跑在这张 \(2\times2\) 表上,所以把它记住:A 好但拥挤时掉得更狠,B 差但抗挤,即 \(D_A>D_B\)。
6.2.2 三级均衡#
定义 6.1(混合策略与 Nash 均衡)
有限博弈 \(G=(N,\{A_i\},\{u_i\})\):\(N\) 个玩家,玩家 \(i\) 的动作集 \(A_i\)(\(|A_i|=m\)),效用 \(u_i:A\to\mathbb{R}\),\(A=\prod_iA_i\)。玩家 \(i\) 的混合策略 \(x_i\) 是 \(A_i\) 上的概率分布。策略组 \((x_1,\dots,x_N)\) 是Nash 均衡,若对每个 \(i\) 与每个 \(a_i'\in A_i\),
这个定义在说什么
每个人独立掷自己的骰子,并且在别人不动的前提下,没有人愿意单方面换一个动作。联合分布必须是乘积形式 \(x_1\otimes\cdots\otimes x_N\),这是 Nash 概念最强的一条限制。
定义 6.2(相关均衡 CE,Aumann)
\(A\) 上的一个联合分布 \(\sigma\) 是相关均衡,若对每个玩家 \(i\)、每对动作 \(a_i,a_i'\in A_i\),
这个定义在说什么
想象一个中介先从 \(\sigma\) 抽一个联合动作 \(a\),然后只把 \(a_i\) 私下告诉玩家 \(i\)。上式说的是:玩家 \(i\) 在知道自己被推荐了 \(a_i\) 之后,照做仍然不亏。这条信息让他对别人的动作有了后验。
联合分布不必是乘积,玩家的动作可以相关,相关性由那个公共信号带来。
定义 6.3(粗相关均衡 CCE)
\(\sigma\) 是粗相关均衡,若对每个 \(i\) 与每个 \(a_i'\in A_i\),
若上式右边减左边 \(\le\varepsilon\)(对所有 \(i,a_i'\)),称 \(\sigma\) 是 \(\varepsilon\)-CCE。
这个定义在说什么
同样有中介,但玩家必须在看到推荐之前就决定要不要参与:要么全程照做,要么整场换成一个固定动作 \(a_i'\)。这是"事前"(ex ante)承诺,比 CE 的"事后"(interim)条件弱,因为玩家用不上"我被推荐了什么"这条信息。
命题 6.1(三级包含)【已解决(经典)】
对任何有限博弈,
其中 Nash 按其乘积联合分布看待。
证明(三步)
第 1 步:Nash \(\subseteq\) CE。 Nash 的 \(\sigma\) 是乘积,\(\sigma(a_i,a_{-i})=x_i(a_i)x_{-i}(a_{-i})\),代入定义 6.2 左边得
Nash 条件保证 \(a_i\) 在 \(x_i\) 支撑上时括号 \(\ge0\),理由如下。\(x_i\) 的期望收益是各动作条件收益 \(\mathbb{E}_{x_{-i}}u_i(a_i,\cdot)\) 按权重 \(x_i(a_i)\) 的加权平均。定义 6.1 又要求它不低于任何单个动作的条件收益,包括最大的那个。加权平均不低于最大值,只能是支撑上每个动作的条件收益都等于最大值。不在支撑上时 \(x_i(a_i)=0\),整体为 \(0\)。
第 2 步:CE ⊆ CCE。 把定义 6.2 对固定的 \(a_i'\) 关于 \(a_i\) 求和,\(\sum_{a_i}\sum_{a_{-i}}\sigma(a)\,[u_i(a)-u_i(a_i',a_{-i})]\ge0\),正是定义 6.3。
第 3 步:包含可以是严格的。 见下面的引理 6.2 与它后面的注。\(\blacksquare\)
物理意义
三级的差别全在:允许多少相关性,以及玩家能不能用上信号里的信息。
- Nash:不许相关。
- CE:许相关,玩家看得到自己那一份推荐。
- CCE:许相关,玩家看不到,只能事前承诺。
约束越弱,集合越大。
行为分析
放宽的理由是可达性,不是数学趣味。第 4 章定理 4.6 说过:非耦合的动力学要到达纯 / 混合 Nash,最坏情形需要指数比特;定理 4.7 说到相关均衡只要多项式。
本章 6.3 节会给出更强的版本:CCE 是任何一组无后悔学习者自动落进去的地方,不需要任何通信。"解概念决定话费的量级"(第 4 章 4.5 节)在这里换了一种说法:解概念决定学不学得到。
6.2.3 两个动作时,CE 和 CCE 是同一个集合#
引理 6.2(两动作博弈中 CE \(=\) CCE)【本站演算·初等】
若每个玩家只有两个动作(\(m=2\)),则 CE 集与 CCE 集重合。
证明(两步)
第 1 步:写出 CCE 中"偏离到固定动作 \(1\)"的约束。 记玩家 \(i\) 的两个动作为 \(1,2\),则
第一个等号只是按 \(a_i\in\{1,2\}\) 拆和。第二个等号把 \(u_i(1,a_{-i})\) 提出来后,\(\sigma(1,\cdot)\) 那一项对消。
第 2 步:与 CE 约束对上。 最后一行恰好就是定义 6.2 中 \(a_i=2\)、\(a_i'=1\) 的那条 CE 约束。同理,"偏离到 \(2\)"的 CCE 约束等于 \(a_i=1,a_i'=2\) 的 CE 约束。两组约束逐条相同,故两个多面体相同。\(\blacksquare\)
行为分析
这条引理说明:要看到 CE \(\subsetneq\) CCE,至少要三个动作。三个动作时分离立刻出现。
以石头剪刀布为例。取均匀分布在 6 个"非平局"格子上的 \(\sigma\),它满足 CCE:任何固定偏离的期望收益都是 \(0\),与照做相同。但它不是 CE:
- 被推荐"石头"时,对手的后验是"布"与"剪刀"各半。
- 照做出石头,对布输(\(-1\))、对剪刀赢(\(+1\)),条件期望 \(0\)。
- 改出剪刀,对布赢(\(+1\))、对剪刀平(\(0\)),条件期望 \(+0.5\),偏离净赚 \(0.5\)。
CCE 只检查"整场换成固定动作",看不到"被推荐后再换"的这笔收益。
本站复核
六个格子各 \(1/6\),三个固定偏离的增益均为 \(0.0000\);条件偏离增益为 \(\pm0.5\),故是 CCE 非 CE。
6.2.4 三个集合在两小区例子上有多大#
两小区抢频带博弈的三级均衡(【本站演算】,用引理 6.2 与直接求解)
效用取代价的相反数:\(u_i=-c\)。四个动作组合的效用(行 = 小区 1 的选择):
| 小区 2 选 A | 小区 2 选 B | |
|---|---|---|
| 小区 1 选 A | \((-0.761451,\,-0.761451)\) | \((0,\,-0.375000)\) |
| 小区 1 选 B | \((-0.375000,\,0)\) | \((-0.877840,\,-0.877840)\) |
纯 Nash 有两个:\((A,B)\) 与 \((B,A)\)(错开)。检查 \((A,B)\):
- 小区 1 换到 B,两家挤 B,代价 \(0.877840>0\),不划算。
- 小区 2 换到 A,两家挤 A,代价 \(0.761451>0.375\),不划算 ✓。
\((A,A)\) 不是 Nash(换到 B 独占,代价 \(0.375<0.761451\));\((B,B)\) 也不是。
混合 Nash 有一个(对称):设对方以概率 \(y\) 选 A,令小区 1 两个动作代价相等
每人的期望代价 \(0.528701\)。
CE \(=\) CCE(引理 6.2)是一个三维多面体:联合分布 \((\sigma_{AA},\sigma_{AB},\sigma_{BA},\sigma_{BB})\) 有四个非负分量、和为 1,活在三维的 3-单纯形里。约束按定义 6.2 逐条写出。以小区 1 为例:
- 被推荐 A 时不愿改 B:\(\sigma_{AA}u_1(A,A)+\sigma_{AB}u_1(A,B)\ge\sigma_{AA}u_1(B,A)+\sigma_{AB}u_1(B,B)\)。代入上表是 \(-0.761451\,\sigma_{AA}\ge-0.375\,\sigma_{AA}-0.877840\,\sigma_{AB}\),即 \(0.386451\,\sigma_{AA}\le0.877840\,\sigma_{AB}\)。
- 被推荐 B 时不愿改 A:同理得 \(0.877840\,\sigma_{BB}\le0.386451\,\sigma_{BA}\)。
这里 \(0.386451=c_A(2)-c_B(1)\),\(0.877840=c_B(2)-c_A(1)\)。小区 2 的两条只是把 \(\sigma_{AB}\) 与 \(\sigma_{BA}\) 对调。四条合起来是(记 \(r=\frac{0.386451}{0.877840}=0.440229\)):
在 3-单纯形上做 \(n=400\) 的均匀网格计数,这个多面体占单纯形体积的 13.73%,而 Nash 集只有 3 个点(测度零)。
一个有工程意义的 CE:\(\sigma=\tfrac12\delta_{(A,B)}+\tfrac12\delta_{(B,A)}\)("抛一枚公共硬币决定谁用好频带")。每人期望代价 \(\tfrac12(0)+\tfrac12(0.375)=0.1875\),等于社会最优。混合 Nash 的 \(0.528701\) 是它的 \(2.8197\) 倍。
校验
- (i) 把混合 Nash 的乘积分布 \((y^{\star2},\,y^\star(1-y^\star),\,(1-y^\star)y^\star,\,(1-y^\star)^2)=(0.48210,0.21223,0.21223,0.09343)\) 代进 CE 的四条约束,全部以等式或严格不等式成立 ✓(它必须在 CE 里,由命题 6.1)。
- (ii) 用另一条路径复算混合 Nash 的期望代价:\(y^\star\cdot\hat c_A(y^\star)+(1-y^\star)\hat c_B(y^\star)\) 中两个条件代价在均衡处相等,都等于 \(0.761451\times0.694334=0.528701\) ✓,与上面用 B 那一支算的 \(0.375+0.502840\times0.305666=0.528701\) 一致。
- (iii) 社会最优的独立复算:唯一让两家都独占的动作组合代价和为 \(0+0.375=0.375\),人均 \(0.1875\);任何撞车的组合人均 \(\ge0.761451\) ✓。
这三个数值得停一停。社会最优 \(0.1875\);相关均衡能达到它;混合 Nash 是它的 \(2.82\) 倍;纯 Nash 恰好等于它,所以按纯 Nash 算的 PoA \(=1\)。
"抛一枚公共硬币"这件事在信息论上不是免费的,它就是第 4 章算的那笔账:让两个基站的动作服从一个给定的相关联合分布,最少要 \(1-h(\epsilon)\) 比特每时隙(算例 4.1,\(\epsilon=0.1\) 时 0.531)。相关均衡的"相关"两个字,价钱在第 4 章。
到此为止我们得到了什么
- 三级均衡的精确定义与包含关系。
- 一条初等引理:两动作时 CE 与 CCE 重合,要分离得三个动作以上。
- 两小区抢频带博弈上三个集合的大小:Nash 三个点,CE/CCE 占单纯形 13.73%。
- "公共硬币型相关均衡达到社会最优、混合 Nash 差 2.82 倍"的数字。
6.3 无后悔学习自动落进 CCE:一条完整证明的定理#
6.3.1 直觉:先不管别人在干什么#
假设你是小区 1 的调度器。你不知道小区 2 在跑什么算法,也不打算问。你只做一件事:每个时隙结束后回头看,问自己"如果我这 \(T\) 个时隙从头到尾都固定用频带 A,会不会比我实际做的更好?"
如果对每一个固定动作,这个"事后懊悔"都随 \(T\) 增长得比 \(T\) 慢,你就是无后悔的。
这是第三部第 4 章"写法 C"里那个 regret,一字不改。那里的对手是"最坏情形的自然",这里的对手是"另一个学习者"。定义不变,因为 regret 的定义本来就不对对手做任何假设,所以它在多智能体场景里能直接用。
定义 6.4(外部后悔与 swap 后悔)
玩家 \(i\) 在第 \(t\) 轮出 \(a_i^t\),联合动作 \(a^t=(a_i^t,a_{-i}^t)\)。外部后悔(external regret)
swap 后悔把"整场换成一个固定动作"换成"每次出 \(a_i\) 时都改出 \(\phi(a_i)\)",对所有映射 \(\phi:A_i\to A_i\) 取最大:
外部后悔是 \(\phi\) 取常值映射的特例,故 \(R_i(T)\le R_i^{\mathrm{sw}}(T)\)。
只允许 \(\phi\) 改动一个动作(把 \(a\) 换成 \(b\)、其余不动)时,得到内部后悔(internal regret)。swap 后悔等于"每个动作各自挑最好的替换"之和,所以它介于内部后悔与 \(m\) 倍内部后悔之间,两者要么同为 \(o(T)\),要么都不是。
称一个算法无后悔,若对任意对手序列 \(R_i(T)=o(T)\)。
6.3.2 定理 6.3 与它的证明#
定理 6.3(无后悔 ⟹ 经验分布是 CCE)【已解决(经典);见 [2]】
设每个玩家跑一个算法,\(T\) 轮后的经验联合分布为
若每个玩家的外部后悔满足 \(R_i(T)\le\varepsilon T\),则 \(\bar\sigma_T\) 是 \(\varepsilon\)-CCE。特别地,若所有玩家都无后悔,则 \(\bar\sigma_T\) 到 CCE 集的距离趋于 \(0\),其任何极限点都是 CCE。
证明(四步)
第 1 步:把经验分布下的期望换成时间平均。 \(\bar\sigma_T\) 是 \(T\) 个点质量的平均,而 \(u_i\) 是有限动作集上的函数,故对任何函数 \(g:A\to\mathbb{R}\),
这一步只是交换有限求和的次序,没有用任何假设。
第 2 步:取 \(g=u_i\),得
第 3 步:取 \(g(a)=u_i(a_i',a_{-i})\),得
这里把第 \(i\) 个坐标钉死在 \(a_i'\),它仍然是 \(A\) 上的函数。
这一步是全证明的关键。把"偏离"写成经验分布上的期望时,\(a_{-i}\) 的经验边缘自动被用上,而不需要假设各玩家的动作独立。经验分布里带的相关性正好被保留,这也是为什么落点是 CCE(允许相关)而不是 Nash(要求独立)。
第 4 步:作差,认出 regret。 用第 3 步减第 2 步,并对 \(a_i'\) 取最大:
左边正是定义 6.3 里 \(\varepsilon\)-CCE 的违反量。对每个 \(i\) 都成立,故 \(\bar\sigma_T\) 是 \(\varepsilon\)-CCE。
最后一句:\(\varepsilon\)-CCE 集合随 \(\varepsilon\downarrow0\) 单调收缩到 CCE 集,且 \(A\) 上的分布构成紧集,故极限点是 CCE。\(\blacksquare\)
物理意义
这条定理是多智能体学习里唯一一条不需要任何假设的正面结论:
- 不需要博弈是零和的、势的,或者有任何结构。
- 不需要玩家之间通信。
- 不需要玩家知道自己在玩博弈。
- 甚至不需要玩家用同一个算法。
只要各自"事后不后悔",集体行为的统计就落进 CCE。这就是 CCE 在近十年成为多智能体学习标准解概念的原因。
6.3.3 适用范围:时间平均、落点是集合、Hedge 的步长#
行为分析(三条,每一条都限制了这条定理能承诺什么)
第 1 点:它说的是时间平均,不是当前策略。 \(\bar\sigma_T\) 是一个直方图。工程上基站每个时隙用的是当前的混合策略 \(x^t\),不是直方图。6.7、6.8 节会给出一条轨道:它的时间平均严格地以 \(O(1/T)\) 收敛到混合 Nash,而 \(x^t\) 本身是混沌的。
第 2 点:落点是 CCE,不是 Nash,而 CCE 可以很差。 CCE 集在上一节的例子里占单纯形的 13.73%,里面既有代价 \(0.1875\) 的好点,也有差得多的点。学习保证你落在集合里,不保证落在哪。
第 3 点:常步长的指数权重法不是无后悔算法。 Hedge 就是 6.6 节的指数权重更新:每轮把每个动作的权重乘以 \(e^{-\eta\times\text{该动作本轮的代价}}\),再归一化。以学习率 \(\eta\) 跑、代价在 \([0,1]\) 时,标准界是([2] 定理 2.2【二手已核:据 Chernov 2010 对该书的引述,原书未取得】)
两项各有来历:
- 第一项 \(\ln m/\eta\) 是初始无知的代价。 开局对 \(m\) 个动作一视同仁(各给 \(1/m\)),要把权重集中到事后最好的那个动作上,得靠代价差一轮一轮攒出 \(\ln m\) 量级的对数权重差。\(\eta\) 越小攒得越慢,这段时间里亏得越多。
- 第二项 \(\eta T/8\) 是步长过大的代价。 每轮权重都按本轮代价跳一下,跳得越猛越容易被一时的代价带偏,每轮至多多亏约 \(\eta/8\)(证明里来自 Hoeffding 引理),\(T\) 轮累积成 \(\eta T/8\)。
一项随 \(\eta\) 减、一项随 \(\eta\) 增。令两项相等 \(\ln m/\eta=\eta T/8\),取 \(\eta=\sqrt{8\ln m/T}\) 得 \(R_i(T)\le\sqrt{(T/2)\ln m}=o(T)\) ✓。
但若 \(\eta\) 固定不随 \(T\) 缩,右边第二项是 \(\eta T/8\),与 \(T\) 同阶,界作废,定理 6.3 的前提就落空了。本章后面所有的混沌都发生在这个前提落空的地方。这不是巧合,6.8 节会把两者定量地对上。
定理 6.4(swap 后悔 ⟹ 相关均衡)【已解决(经典);Hart–Mas-Colell 2000 [3] 第 3 节命题与第 2 节主定理】
若每个玩家的 swap 后悔(等价地,内部后悔)是 \(o(T)\),则经验联合分布 \(\bar\sigma_T\) 的任何极限点是相关均衡 CE。Hart–Mas-Colell 给出了一个显式的自适应程序("后悔匹配")达到这一点,且该程序是非耦合的(每个玩家只用自己的收益历史)。
行为分析
从外部后悔升级到 swap 后悔,落点从 CCE 升级到 CE。代价是算法更复杂,要为每个动作维护一个子算法。
这条阶梯与第 4 章的通信复杂度阶梯方向一致:解概念越强,代价越高。但两条阶梯量的是不同的东西,一个是算法复杂度,一个是比特数,不可以放在同一栏里相加(第 4 章 4.8 节的量纲警告在这里同样适用)。
到此为止我们得到了什么
- 一条四步完整证明的定理:任何一组各自无后悔的学习者,其经验联合分布是 \(\varepsilon\)-CCE,\(\varepsilon=\max_iR_i(T)/T\)。
- 三条限制:它说的是时间平均;落点是集合不是点;常步长的 Hedge 根本不满足前提(\(R\le\ln m/\eta+\eta T/8\) 的第二项与 \(T\) 同阶)。
6.4 势博弈:为什么干扰博弈是"善良"的#
6.4.1 直觉:给整个系统装一个"高度表"#
上一节的结论是统计的。有没有一类博弈,能保证轨迹本身收敛?有,而且干扰博弈常常就属于这一类。
想象所有玩家的动作组合是地图上的一个点,地图上有一个海拔函数 \(\Phi\)。如果"某个玩家单方面改动作让自己变好"永远等价于"这个点的海拔升高",那么任何一串各自为己的改动,都是在往山上爬。
地图有限、海拔取值有限,爬不了几步就到顶。到顶的地方没人能再改进,那就是纯 Nash。
定义 6.5(序数势与精确势)
有限博弈 \(G\) 有序数势函数(ordinal potential)\(\Phi:A\to\mathbb{R}\),若对每个 \(i\)、每个 \(a_{-i}\)、每对 \(a_i,a_i'\),
若把 \(\iff\) 加强为差相等
则 \(\Phi\) 是精确势函数(exact potential),\(G\) 是精确势博弈。
记号解释
\(\Phi\) 是一个标量函数,定义在联合动作上;每个玩家的私人收益变化都被同一个 \(\Phi\) 记账。
注意 \(\Phi\) 一般不是社会福利 \(\sum_iu_i\)。算例 6.1 会给出一个两者取值不同、极大点也不同的例子。
6.4.2 Monderer–Shapley 定理与它的证明#
定理 6.5(Monderer–Shapley:有限改进性质与更优响应收敛)【已解决(经典)】[1]
设有限博弈 \(G\) 有序数势函数 \(\Phi\)。则
- \(G\) 具有有限改进性质(FIP):任何更优响应路径(每一步恰有一个玩家换一个让自己严格变好的动作)在有限步内终止;
- 终止点是纯策略 Nash 均衡;
- \(\Phi\) 的任一全局极大点是纯 Nash,特别地纯 Nash 存在。
在精确势博弈(更一般地,加权势博弈)中还有:虚拟对策(fictitious play)收敛到均衡集,即 [1] 定理 2.4(证明在作者同年的另一篇论文里)。
另外,[1] 引理 2.5(第 129 页)给出"有限博弈具有 FIP 当且仅当它有广义序数势"。
证明(四步)
第 1 步:沿路径 \(\Phi\) 严格增。 路径的一步是 \((a_i,a_{-i})\to(a_i',a_{-i})\) 且 \(u_i(a_i',a_{-i})>u_i(a_i,a_{-i})\)。由定义 6.5 的 \(\Rightarrow\) 方向,\(\Phi(a_i',a_{-i})>\Phi(a_i,a_{-i})\)。
第 2 步:严格增 \(\Longrightarrow\) 不重复。 若路径上出现 \(a^{(s)}=a^{(t)}\)(\(s<t\)),则 \(\Phi(a^{(s)})<\Phi(a^{(t)})=\Phi(a^{(s)})\),矛盾。所以路径上的动作组合两两不同。
第 3 步:有限性 \(\Longrightarrow\) 终止。 \(|A|=\prod_i|A_i|<\infty\),路径长度 \(\le|A|\),必在有限步停下。
第 4 步:终止点是 Nash。 路径停下意味着没有玩家能通过单方面换动作严格改善,这就是纯 Nash 的定义。
至于第 3 条:设 \(a^\star\in\arg\max_A\Phi\)。若某个 \(i\) 有 \(u_i(a_i',a^\star_{-i})>u_i(a^\star)\),由定义 6.5 得 \(\Phi(a_i',a^\star_{-i})>\Phi(a^\star)\),与极大性矛盾。\(\blacksquare\)
物理意义
这条定理把一个分布式、异步、无通信的过程(每人各自改进)的收敛性,归结为一个集中式对象(\(\Phi\))的存在性。
工程上的读法是:只要你能为一个自适应环写出势函数,你就不必再担心它会不会停,只需要担心它停在哪。
行为分析(四条)
- 步数上界是 \(|A|\),可以很大。 \(N\) 个小区、每个 \(m\) 档功率,\(|A|=m^N\)。定理只说"有限",不说"快"。\(N=10,m=8\) 时 \(|A|\approx10^9\)。
- "更优响应"不是你在跑的算法。 FIP 说的是"每次恰有一个玩家改进"。若所有基站在同一个 TTI 一起更新(同步),路径不是更优响应路径,定理不适用。势博弈中轮询 / 异步更新收敛而同步更新不保证收敛,是一个已被指出的现象。出处是 arXiv:1212.0724 命题 4,原文措辞为"同步时序下不收敛",并引自其更早的文献;详见第 8 章参考文献 [10],第 8 章展开。这是"所有基站同一时隙一起调功率"的现实陷阱。
- 序数势就够了。 只需要改进方向一致,不需要幅度相等。这让"效用 = 速率 − 功率价钱"这类非线性收益也有机会落进来。
- \(\Phi\) 的极大点是 Nash,但 Nash 不一定是 \(\Phi\) 的极大点(\(\Phi\) 的局部极大点也都是 Nash)。而且,下一个算例的重点是:\(\Phi\) 的极大点与社会福利的极大点可以完全不同。
6.4.3 算例:两小区两功率档#
算例 6.1(两小区两功率档干扰博弈:势函数、纯 Nash 与社会最优)【本站演算】
场景
两个共信道小区,噪声功率归一化为 \(\sigma^2=1\),自身链路增益与跨小区干扰增益都归一化为 \(1\)(小区边缘、最坏情形)。每个小区从两档发射功率里选一档:低档 \(P_L=1\)(0 dB),高档 \(P_H=4\)(+6 dB)。收益 = 自身谱效率 − 功率价钱:
\(c\) 的量纲是"bit/s/Hz 每单位归一化功率",取 \(0.15\) 表示把功率从 1 加到 4 要值 \(0.45\) bit/s/Hz 才划算。
第 1 步:四个格子的收益。
| 小区 2 低 | 小区 2 高 | |
|---|---|---|
| 小区 1 低 | \((0.434963,\,0.434963)\) | \((0.113034,\,0.984963)\) |
| 小区 1 高 | \((0.984963,\,0.113034)\) | \((0.247997,\,0.247997)\) |
例如 \(u_1(H,L)=\log_2(1+4/2)-0.6=\log_23-0.6=1.584963-0.6=0.984963\)。
第 2 步:猜一个势函数并验证。 可以把收益重写成两个对数之差:
右边第二项与 \(p_i\) 无关。所以当小区 \(i\) 单方面改功率时,只有第一、三项在动。于是取
就有 \(u_i(p_i',p_j)-u_i(p_i,p_j)=\Phi(p_i',p_j)-\Phi(p_i,p_j)\),即精确势函数。
第 3 步:逐项检验四个差分等式。 \(\Phi\) 的四个取值:
- \(\Phi(1,1)=\log_23-0.3=1.284963\)
- \(\Phi(4,1)=\Phi(1,4)=\log_26-0.75=1.834963\)
- \(\Phi(4,4)=\log_29-1.2=1.969925\)
把 \(\Phi(1,1)\) 归零:\(0/0.55/0.55/0.684963\)。
| 单方面改动 | 效用差 | 势差 |
|---|---|---|
| 小区 1:\((L,L)\to(H,L)\) | \(0.984963-0.434963=0.550000\) | \(0.550000\) ✓ |
| 小区 1:\((L,H)\to(H,H)\) | \(0.247997-0.113034=0.134963\) | \(0.684963-0.550000=0.134963\) ✓ |
| 小区 2:\((L,L)\to(L,H)\) | \(0.984963-0.434963=0.550000\) | \(0.550000\) ✓ |
| 小区 2:\((H,L)\to(H,H)\) | \(0.247997-0.113034=0.134963\) | \(0.134963\) ✓ |
闭式核对:第一行 \(=\log_23-\log_2 1.5-0.45=\log_22-0.45=1-0.45=0.55\),第二行 \(=\log_2\frac{1.8}{1.2}-0.45=\log_21.5-0.45=0.134963\)。
第 4 步:纯 Nash 与更优响应路径。 高档对两个小区都是严格占优(\(0.984963>0.434963\) 且 \(0.247997>0.113034\)),故 \((H,H)\) 是唯一纯 Nash。
从 \((L,L)\) 出发的更优响应路径:小区 1 换高(\(\Phi:0\to0.55\)),小区 2 换高(\(\Phi:0.55\to0.684963\)),然后停。两步,\(\Phi\) 严格增,终点是 \(\Phi\) 的极大点 ✓(定理 6.5)。
第 5 步:社会福利完全是另一回事。 \(W=u_1+u_2\):
- \((L,L)\) 得 \(0.869925\)。
- \((H,L)\) 与 \((L,H)\) 得 \(1.097997\)。
- \((H,H)\) 得 \(0.495994\)。
社会最优是一高一低(\(1.097997\)),Nash 是 \(0.495994\),比值 \(\mathbf{2.2137}\)。连"两家都用低档"的 \(0.869925\) 都比 Nash 好 \(1.7539\) 倍。这是一个标准的囚徒困境结构。
校验
- (i) 独立途径复算势函数的极大点
- \(\Phi\) 只依赖总功率 \(P=p_1+p_2\):\(\Phi=\log_2(1+P)-cP\)。对 \(P\) 求导得 \(\frac{1}{(1+P)\ln2}-c=0\),即连续意义下的极大点 \(P^\star=\frac{1}{c\ln2}-1=\frac{1}{0.15\times0.693147}-1=9.617967-1=8.617967\)。
- 网格上可取的总功率是 \(\{2,5,8\}\),全部 \(\le P^\star\),而 \(\Phi\) 在 \(P<P^\star\) 上严格增,所以 \(\Phi\) 在 \(P=8\) 即 \((H,H)\) 处最大 ✓。这与第 3 步逐格比较的结论一致,两条路径独立。
- (ii) 社会福利的闭式复算
- \(W=\log_2\frac{(1+p_1+p_2)^2}{(1+p_1)(1+p_2)}-c(p_1+p_2)\)。
- 代 \((4,1)\):\(2\log_26-\log_25-\log_22-0.75=5.169925-2.321928-1-0.75=1.097997\) ✓。
- (iii) 极限退化
- 令 \(c\to0\),\(\Phi=\log_2(1+P)\) 单调增,Nash 变成"都用最大功率"。
- 此时 \(W=\log_2\frac{(1+2P_H)^2}{(1+P_H)^2}\) 在 \(P_H\to\infty\) 时趋于 \(2\log_2 2=2\),有界(每个小区的 SINR 趋于 1、谱效趋于 1 bit/s/Hz)。
- 这与"无功率价钱时干扰博弈退化为全功率发射、谱效率被干扰卡死"这一常识一致 ✓。
关键结论:势函数不是社会福利
算例 6.1 里 \(\Phi\) 在 \((H,H)\) 最大,\(W\) 在 \((H,L)\) 最大。势博弈保证系统"停得下来",不保证"停在好地方"。
前者是本章的题目(动力学),后者是第 8 章的题目(PoA / PoS)。把两者混为一谈,是"我的算法收敛了所以我的方案是对的"这类错误的根源。
推广到 \(N\) 个小区【本站演算】
上面的构造不依赖于 \(N=2\)。设 \(N\) 个共信道小区、每个接收机看到的总功率相同(等增益全互干扰),
第二项与 \(p_i\) 无关,于是
对任意 \(N\) 与任意(离散或连续)功率集都是精确势函数。
功控问题在无线文献里被建成势博弈,是一脉成熟工作。第 8 章会给出出处与更一般的势函数;本章只需要这个最简版本来跑动力学。
到此为止我们得到了什么
- 势博弈的定义与 Monderer–Shapley 定理的完整四步证明:\(\Phi\) 沿更优响应路径严格增,有限性给出终止,终止点即纯 Nash。
- 一个两小区功控的精确势函数 \(\Phi=\log_2(\sigma^2+\sum p_j)-c\sum p_j\),对任意 \(N\) 成立。
- 一个必须记住的反差:势函数的极大点(Nash,\(W=0.4960\))与社会福利的极大点(\(W=1.0980\))差 2.2137 倍。
6.5 零和:时间平均收敛,轨迹却奔向边界#
势博弈是"目标大致一致"的那一侧。另一侧是零和:一方的所得就是另一方的所失。无线里的例子是干扰对抗、抗干扰跳频,以及安全侧的博弈式建模。
零和博弈有一条经典的好消息(von Neumann 极小极大定理 + 定理 6.3):两个无后悔学习者的时间平均策略收敛到极小极大最优。很多教科书讲到这里就停了,让人以为零和问题的学习已经解决。其实没有。
6.5.1 常步长 MWU:轨迹发散到边界#
定理 6.6(Bailey–Piliouras:零和博弈中 MWU 的轨迹发散)【已解决】[6]
在两人零和博弈中,若存在内点(完全混合)Nash 均衡 \(x^\star\),则常步长的乘性权重更新(MWU)产生的轨迹 \(\{x^t\}\) 满足:KL 散度 \(D(x^\star\|x^t)\) 单调不减,且每步的增量有一个非负下界。于是轨迹被推离内点均衡,趋向单纯形的边界。
连续时间的对应物:Mertikopoulos–Papadimitriou–Piliouras [7] 证明,两人零和博弈只要存在内点 Nash 均衡,连续时间 FTRL 动力学就是 Poincaré 回复的:对(Lebesgue)几乎所有初值,轨迹无穷次回到初值的任意小邻域(其定理 4.2)。
回复不等于周期。轨道一次次回到起点附近,但不必闭合,总之不收敛。
结论对各人用不同正则项、对收益做正仿射变换都成立,也推广到零和多人网络博弈。没有内点均衡时,轨迹在包含全部均衡的最小面上游荡(定理 4.3)。
物理意义
定理拿 KL 散度 \(D(x^\star\|x^t)=\sum_a x^\star_a\ln\frac{x^\star_a}{x^t_a}\)(预备篇 4.4)当作"\(x^t\) 离均衡多远"的尺子。内点均衡的每个分量 \(x^\star_a>0\),而 \(D(x^\star\|x^t)\le\ln\frac{1}{\min_a x^t_a}\),所以 KL 越大,\(x^t\) 就必须有某个分量越接近 \(0\),也就是越贴近单纯形的边界。
"时间平均收敛"与"轨迹收敛"在零和博弈里被明确地分开了:直方图收敛到均衡,但你手里当前那个混合策略在绕圈,甚至越绕越靠近边界(越来越接近纯策略)。
工程上这意味着:一个跑在零和场景里的自适应算法,如果你按"当前策略"部署,看到的会是持续的来回切换,而不是稳定下来。
行为分析
- "内点均衡"这个前提要紧。 若均衡在边界上(有纯策略均衡),结论不适用。
- 趋向边界意味着策略越来越"孤注一掷"。 在有观测噪声时这很危险,一个错误的观测会造成大幅摆动。
- 这条定理是"离散时间惹的祸"的一个实例。 见 6.6 节末尾 Biggar 等 [11] 的观察。
6.5.2 乐观方法:末迭代收敛,但只在零和#
定理 6.7(Daskalakis–Panageas:OMWU 的末迭代收敛)【已解决(渐近,非速率)】[8]
在两人零和博弈中,乐观乘性权重更新(optimistic MWU,OMWU)的末迭代在适当条件(如唯一 Nash、步长足够小)下渐近收敛到 Nash 均衡。OMWU 的做法是:每步在梯度里多减一次上一轮的收益向量。
物理意义
"乐观"这一项的作用可以这样看。普通 MWU 用上一轮的收益当作这一轮的预测,总是慢半拍,于是在旋转的向量场里持续过冲。OMWU 用"上一轮的收益 + 上一轮的变化"外推一步,抵消掉那半拍延迟。
写成公式,记 \(u^t_a\) 为动作 \(a\) 在最近一轮观测到的收益:
- MWU:\(x^{t+1}_a\propto x^t_a\,e^{\eta u^t_a}\)
- OMWU:\(x^{t+1}_a\propto x^t_a\,e^{\eta(2u^t_a-u^{t-1}_a)}=x^t_a\,e^{\eta[u^t_a+(u^t_a-u^{t-1}_a)]}\)
定理 6.7 里"多减一次上一轮的收益向量"指的就是指数里的 \(2u^t-u^{t-1}\)。这是把外梯度 / 预测引进学习动力学,与优化里的 extra-gradient 是同一门手艺。
行为分析
- 它给的是渐近收敛,不给速率。 工程上"最终会收敛"和"在 100 个时隙内收敛"是两回事。
- 它只在零和(更一般地,某些单调场)上有保证。 一般博弈里 OMWU 不保证末迭代收敛。
- 这就在相图上凿出了一个洞。 右下角(零和 + 小步长)有 OMWU 兜底,右上角(一般博弈 + 大步长)什么都没有。
陷阱:把"时间平均"当成"工程上收敛了"
这是本章最想让读者带走的一句话。工程上关心的几乎总是末迭代:基站每个时隙真的在用当前策略发射;用户体验到的是当前时隙的 SINR,不是 \(T\) 个时隙的直方图。一个"时间平均收敛"的算法完全可能让每个时隙的实际性能剧烈摆动。
6.8 节会把这句话变成一个可算的数:同一条轨道,时间平均以 \(O(1/T)\) 精确收敛到混合 Nash,同一条轨道的实际时间平均代价却比 Nash 高 19.3%。
到此为止我们得到了什么
零和这一侧有三条结论:
- 时间平均收敛(定理 6.3 的推论)。
- 末迭代被证明发散到边界(定理 6.6)。
- 乐观方法在零和恢复末迭代收敛,但只在零和(定理 6.7)。
还有一条贯穿本章后半的警告:时间平均 \(\ne\) 工程收敛。
6.6 一步之差:MWU 的两个变体#
现在进入本章最容易讲错的地方。"势博弈里常步长 MWU 会混沌"这句话,不加限定就是错的。必须先把两个变体并排写清楚。
6.6.1 两个变体的定义#
定义 6.6(乘性权重更新的两个变体)
玩家 \(i\) 在第 \(t\) 轮的混合策略是 \(p_i(t)\),动作 \(\gamma\) 的期望代价记 \(\hat c_{i\gamma}(t)\)(在别人的当前混合策略下算出),步长 \(\varepsilon\in(0,1)\)。
线性变体(\(\mathrm{MWU}_\ell\)):
指数变体(\(\mathrm{MWU}_e\),即 Hedge / 指数权重):
两式在 \(\varepsilon\to0\) 时都退化为同一个连续时间复制者动力学(replicator dynamics),差别是二阶的。\(\mathrm{MWU}_\ell\) 要求 \(\varepsilon<1/c_{\max}\),只是为了让括号为正。
这个定义在说什么
\(1-\varepsilon c\) 与 \((1-\varepsilon)^c\) 在 \(\varepsilon\) 小时几乎一样(\((1-\varepsilon)^c\approx1-\varepsilon c\))。但当 \(\varepsilon\) 接近 \(1\) 时,前者线性地把权重压到接近 \(0\),后者指数地压。一个代价高 \(2\) 倍的动作,权重被压的倍数是 \((1-\varepsilon)^{2}\) 对 \((1-2\varepsilon)\),量级完全不同。
\(\eta=-\ln(1-\varepsilon)\) 就是这个"指数压缩"的强度,它也是指数权重法通常写的那个学习率。
定义里提到的复制者动力学来自演化博弈论,白话是"比平均好多少,份额就按这个差距成比例地增长":
代价低于平均的动作份额增长,高于平均的萎缩。它确实是两个变体的共同极限:
- 线性变体归一化后是 \(p_{i\gamma}(t+1)=p_{i\gamma}(t)\frac{1-\varepsilon\hat c_{i\gamma}}{1-\varepsilon\bar c_i}\)(分母是 \(\sum_{\gamma'}p_{i\gamma'}(1-\varepsilon\hat c_{i\gamma'})\)),对小 \(\varepsilon\) 展开得 \(p_{i\gamma}(t+1)-p_{i\gamma}(t)=\varepsilon\,p_{i\gamma}(\bar c_i-\hat c_{i\gamma})+O(\varepsilon^2)\)。
- 指数变体把 \(e^{-\eta\hat c}\approx1-\eta\hat c\) 与 \(\eta=\varepsilon+O(\varepsilon^2)\) 代入,一阶项完全相同。
- 把一步看成时长 \(\varepsilon\)、令 \(\varepsilon\to0\),就得到上面的微分方程。两个变体只在 \(O(\varepsilon^2)\) 项上不同,这就是"差别是二阶的"。
两个动作时,记 \(x\) 为选 A 的概率,\(\bar c-\hat c_A=(1-x)(\hat c_B-\hat c_A)\),复制者方程化成 \(\dot x=x(1-x)\Delta(x)\),其中 \(\Delta:=\hat c_B-\hat c_A\) 就是 6.7 节的代价差。
6.6.2 两条方向相反的定理#
定理 6.8(Palaiopanos–Panageas–Piliouras:\(\mathrm{MWU}_\ell\) 在拥塞博弈中收敛)【已解决】[5]
在任意拥塞(因而是精确势)博弈中,若步长满足可行条件 \(\varepsilon_i<1/c_{\max}\),则
- 期望势函数 \(\Psi(p)=\mathbb{E}_{s\sim p}[\Phi(s)]\) 沿非均衡轨道严格下降(原文定理 3.1);
- 动力学收敛到不动点集(原文定理 3.7);
- 若不动点孤立且初值在单纯形内部,则收敛到精确的 Nash 均衡(原文定理 3.8)。
证明手法:\(\mathrm{MWU}_\ell\) 与 Baum–Welch 同属 Baum–Eagon 迭代,期望势是它的 Lyapunov 函数。
记号提醒
- 定理 6.8 里的 Lyapunov 函数是"沿轨道单调变化的标量",找到它就能证明收敛,作用和定理 6.5 里的 \(\Phi\) 一样。它与 6.1、6.7 节度量轨道分离速度的 Lyapunov 指数是两回事,只是同名。
- 拥塞博弈按代价记账,势函数沿改进方向下降;定义 6.5 按效用记账,势函数沿改进方向上升。两者只差一个负号。
- Baum–Eagon 迭代是一类"按偏导数成比例做乘性更新、保证多项式值单调增加"的迭代,隐马尔可夫模型训练用的 Baum–Welch 算法是它的特例。
定理 6.9(同上:\(\mathrm{MWU}_e\) 的极限环与 Li–Yorke 混沌)【已解决】[5]
在同一类拥塞博弈中,指数变体 \(\mathrm{MWU}_e\):
- 两球两箱负载均衡、两边代价函数同为 \(c(\ell)=\ell/2\)、双方步长 \(\varepsilon=1-e^{-10}\)、对称初值:除测度零集外的所有初值收敛到一个周期 2 极限环(原文定理 4.1)。同一步长下 \(\mathrm{MWU}_\ell\) 仍收敛到精确 Nash。
- 两边代价函数不同时,存在周期 3 轨道,由 Li–Yorke 定理推出混沌与任意周期轨道的存在(原文定理 4.2)。
- 任给 \(0<\varepsilon<1\) 与任意 \(n\),都可以构造 \(n\) 人拥塞博弈使 \(\mathrm{MWU}_e\) 呈 Li–Yorke 混沌(原文推论 4.3)。
必须一起写下的三条限定
- (a) 混沌属于指数变体,线性变体在同一参数下收敛。
- (b) 例子依赖对称初值。原文的 Future Work 明说通有初值下能否构造尚不知道,所以不能写成"典型情况下会混沌"。
- (c) "随步长增大依次经过收敛区 → 周期区 → 混沌区"的倍周期路线,在原文只是数值观察(Conclusion 自述),不是定理。Feigenbaum 常数之类的断言更没有证明。
两个术语
- 两球两箱是最小的拥塞博弈:两个玩家各把一个"球"放进两个"箱"之一,每个箱的代价随箱里的球数 \(\ell\) 增加。这也就是 6.2 节那种两人两频带博弈换了代价函数。
- Li–Yorke 混沌来自 Li 与 Yorke 1975 年的定理,常被概括为"周期 3 蕴含混沌"。区间上的连续映射只要有一条周期 3 轨道,就对每个正整数 \(n\) 都有周期 \(n\) 的轨道,并且存在一个不可数的乱集(scrambled set)。乱集中任意两个初值的轨道既会无穷多次靠得任意近,又会无穷多次重新分开(距离的上极限大于零)。
- Sharkovskii 定理(1964,早于 Li–Yorke)对周期给出更完整的回答:它把正整数排成一个顺序,有周期 \(p\) 就必有排在 \(p\) 后面的全部周期,而 3 排在最前。
注意这种混沌是存在性的:乱集可以只占测度零,典型初值的轨道未必乱。典型轨道乱不乱,要看 6.7 节的 Lyapunov 指数是否为正。
6.6.3 对照的含义:离散化才是祸根#
【本站提法】这条对照的教学价值
同一个 no-regret 框架、同一个连续时间极限(复制者)、同一个势博弈,两种离散化,一个必然收敛,一个能 Li–Yorke 混沌。所以正确的一句话是:
势博弈保证的是"存在收敛的动力学",不保证"你选的那个学习算法收敛"。
这句话对工程的含义很直接:你为功控问题证明了势函数存在,只证明了"有办法让它停下来"。你实际部署的那个更新规则是不是那个办法,要单独验证。
行为分析(离散化才是祸根)
Biggar 等 [11](IJGT 2025)把这件事讲得更彻底:模仿型、生物选择型、指数权重型三种离散模型有同一个连续时间极限(复制者动力学),二阶效应却导致截然不同的行为,包括收敛、失稳、混沌。相图的"步长"轴,实际上就是"离散化尺度"轴。
Bielawski 等 [10](Chaos 2024)给出了另一条轴:记忆 / 折扣可以抑制混沌。
到此为止我们得到了什么
- \(\mathrm{MWU}_\ell\) 与 \(\mathrm{MWU}_e\) 的并排定义,以及 \(\eta=-\ln(1-\varepsilon)\) 的换算。
- 两条方向相反的定理:线性变体在拥塞博弈里必然收敛到精确 Nash;指数变体能出极限环与 Li–Yorke 混沌。
- 三条必须同时写出的限定:变体、对称初值、倍周期只是数值观察。
6.7 无线版的分岔点:一维映射与它的阈值#
文献给了机制,没给数。这一节把 6.2 节那个两小区抢频带博弈接上 \(\mathrm{MWU}_e\),把分岔阈值算出来。
6.7.1 一维约化:什么时候它是合法的#
设两个小区都跑 \(\mathrm{MWU}_e\),都用同一个学习率 \(\eta\),都用同一个初值。记 \(x_t\) 为"选频带 A 的概率"。对方以概率 \(x\) 选 A 时,两个动作的期望代价是
代价差 \(\Delta(x):=\hat c_B(x)-\hat c_A(x)\)。把 \(\mathrm{MWU}_e\) 的两个权重相除、约掉公共因子:
推导(三步)
第 1 步: \(p_A(t+1)\propto x_te^{-\eta\hat c_A}\),\(p_B(t+1)\propto(1-x_t)e^{-\eta\hat c_B}\)。
第 2 步:归一化。 \(x_{t+1}=\frac{x_te^{-\eta\hat c_A}}{x_te^{-\eta\hat c_A}+(1-x_t)e^{-\eta\hat c_B}}\)。
第 3 步: 分子分母同除 \(e^{-\eta\hat c_A}\),指数变成 \(-\eta(\hat c_B-\hat c_A)=-\eta\Delta\)。
代入 6.2 节的四个代价,\(\Delta\) 是 \(x\) 的仿射函数。先把两项各自整理(用了拥挤罚 \(D_e=c_e(2)-c_e(1)\)):
- \(\hat c_A(x)=c_A(1)+x\,[c_A(2)-c_A(1)]=c_A(1)+D_Ax\)
- \(\hat c_B(x)=c_B(2)-x\,[c_B(2)-c_B(1)]=c_B(1)+D_B-D_Bx\)
相减得
命题 6.10(一维约化的两种合法读法)【本站演算】
映射 \(x_{t+1}=f_\eta(x_t)\) 精确描述以下两种情形:
- 两个同构学习者的对称流形:\(N=2\),双方同算法同学习率同初值。此时 \(\{x_1=x_2\}\) 是二维动力学的不变流形,\(f_\eta\) 是它上面的限制。
- 同构学习者的连续体人口:一大群同构小区,\(x\) 是"选 A 的人口比例",每条频带的代价随负载仿射变化(\(C_A(x)=c_A(1)+D_Ax\),\(C_B(1-x)=c_B(1)+D_B(1-x)\))。此时 \(\Delta(x)=C_B(1-x)-C_A(x)\) 与上式逐项相同,而 \(x\) 是全部状态,不是一个不变流形上的切片。
两种读法的地位不同
- 读法 1:对称流形是二维状态空间中的测度零集。本站数值验证(\(\eta=13\))显示它是排斥的:初值偏离 \(10^{-3}\) 时 4 步、偏离 \(10^{-9}\) 时 18 步、偏离 \(10^{-12}\) 时 25 步就离开流形,之后收敛到一个纯 Nash(错开)。所以 \(N=2\) 时混沌是非通有的瞬态。
- 读法 2:没有这个问题。\(x\) 就是状态本身,混沌是系统的真实长期行为。Chotibut 等 [9] 的路由博弈混沌正是读法 2 的情形(连续体智能体、以需求为分岔参数)。
证明要点
- 读法 1:\(f_\eta\) 只依赖 \(\Delta\),而 \(\Delta\) 由对方的混合策略决定。两侧相同则两侧的更新相同,流形不变 ✓。
- 读法 2:把 \(\Delta\) 的两种写法展开逐项比较即可(上文已给)。
- 排斥性:由数值给出,此处不作解析主张。第 9 章命题 9.5 补上了解析解释。
下面给出排斥性的线性化计算。用 6.8 节的 logit 坐标 \(\ell=\ln\frac{x}{1-x}\),两人的更新是 \(\ell_1'=\ell_1+\eta\Delta(x_2)\)、\(\ell_2'=\ell_2+\eta\Delta(x_1)\):每个人的代价差由对方决定。
在 \(x^\star\) 处线性化,\(\mathrm{d}\Delta(x_j)/\mathrm{d}\ell_j=\Delta'\cdot x^\star(1-x^\star)=-(D_A+D_B)x^\star(1-x^\star)\)。记 \(s=\eta x^\star(1-x^\star)(D_A+D_B)\),雅可比矩阵是
它有两个特征方向:
- 两人同向偏离的对称模 \((1,1)\),乘子是 \(1-s\),正是命题 6.11 的 \(f'(x^\star)\)。
- 两人反向偏离、即离开流形方向的反对称模 \((1,-1)\),乘子是 \(1+s>1\),对一切 \(\eta>0\) 不稳定。\(\blacksquare\)
行为分析
这条命题决定了本章的混沌该往哪里挂:\(N=2\) 时挂在"瞬态 + 强初值依赖"上;\(N\) 大时挂在"人口比例的真实动力学"上,而这正好接上第 7 章的平均场。"人多到可以当连续体"这个极限,把一个测度零的不变流形升级成了整个状态空间。
读法 2 就是第 7 章定义 7.1 所说的平均场型耦合:每个小区只通过"选 A 的比例 \(x\)"这一个聚合量感受别人,不在乎具体是谁选了 A。人数趋于无穷时这个比例按确定性的规则演化,有限 \(N\) 时与之相差一个 \(O(1/\sqrt N)\) 量级的涨落(第 7 章 7.5 节讲这个尺度从哪里来)。
据本站检索,把这条"\(N\) 变大使混沌从非通有变通有"的读法明确写出来未见先例【本站提法】。
6.7.2 分岔阈值#
命题 6.11(\(\mathrm{MWU}_e\) 在两带反协调博弈上的翻转分岔阈值)【本站演算】
设 \(\Delta(x)\) 仿射且在 \(x^\star\in(0,1)\) 处过零(即存在内点混合 Nash),\(\Delta'=-(D_A+D_B)<0\)。则
-
\(x^\star\) 是 \(f_\eta\) 的不动点,且
\[ f_\eta'(x^\star)=1+\eta\,x^\star(1-x^\star)\,\Delta'(x^\star)=1-\eta\,x^\star(1-x^\star)(D_A+D_B); \] -
\(x^\star\) 局部渐近稳定 \(\iff\) \(\eta<\eta^\star\),其中翻转(倍周期)分岔阈值
\[ \eta^\star=\frac{2}{x^\star(1-x^\star)\,(D_A+D_B)},\qquad \varepsilon^\star=1-e^{-\eta^\star}; \] -
阈值只依赖于学习率与代价落差的乘积:把所有代价同乘 \(\kappa\),则 \(\eta^\star\) 除以 \(\kappa\),乘积 \(\eta^\star\cdot(D_A+D_B)\) 不变。
证明(四步)
先记 \(h(x)=-\eta\Delta(x)\),\(h(x^\star)=0\),\(h'=-\eta\Delta'\);\(f=x/D\),\(D(x)=x+(1-x)e^{h(x)}\)。
第 1 步:不动点。 \(\Delta(x^\star)=0\Rightarrow D(x^\star)=x^\star+(1-x^\star)=1\Rightarrow f(x^\star)=x^\star\) ✓。
第 2 步:求 \(D'\)。 \(D'(x)=1-e^{h}+(1-x)e^{h}h'\),在 \(x^\star\) 处 \(e^h=1\),故 \(D'(x^\star)=(1-x^\star)h'(x^\star)\)。
第 3 步:求 \(f'\)。 商法则 \(f'=(D-xD')/D^2\),在 \(x^\star\) 处 \(D=1\),得 \(f'(x^\star)=1-x^\star(1-x^\star)h'(x^\star)=1+\eta x^\star(1-x^\star)\Delta'\)。
第 4 步:定阈值。 因 \(\Delta'<0\),\(f'(x^\star)\) 随 \(\eta\) 单调下降,从 \(\eta=0\) 处的 \(1\) 一直降。\(|f'|<1\) 即 \(-1<f'<1\),右边对 \(\eta>0\) 自动成立,左边给出 \(\eta\,x^\star(1-x^\star)(D_A+D_B)<2\) ✓。
\(f'(x^\star)=-1\) 是翻转分岔的标准条件(特征值穿过 \(-1\),生成周期 2 轨道)。
第 3 条:\(\Delta\) 与 \(D_A+D_B\) 都按 \(\kappa\) 缩放,\(x^\star\) 不变(它是 \(\Delta\) 的零点),故 \(\eta^\star\propto1/\kappa\)。\(\blacksquare\)
翻转分岔的直觉
在不动点附近把映射线性化:\(x_{t+1}-x^\star\approx f'(x^\star)\,(x_t-x^\star)\),偏差每步乘一次 \(f'(x^\star)\)。分三种情形:
- \(0<f'<1\):偏差同号地缩小,轨道从一侧爬向 \(x^\star\)。
- \(-1<f'<0\):偏差每步变号且缩小,轨道在 \(x^\star\) 两侧来回跳、振幅衰减。
- \(f'<-1\):仍然每步变号,振幅却被放大。
振幅不能无限长大:\(x\) 关在 \((0,1)\) 里,离 \(x^\star\) 远了,非线性项会把它掰回来。轨道最后在两侧各停一个点、交替访问,这就是周期 2 轨道,也就是 \(f\circ f\) 的一对新不动点。
例:\(\eta=9\) 时 \(f'(x^\star)=1-9\times0.268326=-1.415\),从 \(x^\star+0.01\) 出发,偏差依次约为 \(+0.010,-0.014,+0.020,-0.028,+0.039,\dots\),最后停在周期 2 轨道 \(\{0.4687,0.9200\}\) 上,一低一高夹住 \(x^\star=0.6943\)。
"倍周期"说的是这件事会重复。周期 2 轨道作为 \(f\circ f\) 的不动点,稳定性由 \((f\circ f)'=f'(x_{\text{低}})\,f'(x_{\text{高}})\) 决定(\(\eta=9\) 时约为 \(-0.30\),稳定)。\(\eta\) 再增大到这个乘积穿过 \(-1\),同样的机制再来一次,周期 2 变成周期 4,接着 4→8→16,这就是算例 6.2 表中那一串分岔点。
物理意义
分岔阈值取决于你喂给学习器的数字的单位,而不只是博弈本身。同一个博弈,代价用归一化的 \([0,1]\) 写还是用 Mb/s 写,\(\eta^\star\) 差一个 80 倍。
这在工程上是一个真实的坑:把原始速率直接送进指数权重更新,等于把学习率放大了 80 倍。
行为分析
- 越对称的博弈越容易失稳。 \(x^\star(1-x^\star)\) 在 \(x^\star=1/2\) 时最大(\(=1/4\)),所以 \(\eta^\star\) 最小是 \(8/(D_A+D_B)\)。
- 干扰越强的网络,学习率必须越小。 \(D_A+D_B\) 是"拥挤罚之和",干扰越强、拥挤惩罚越大,\(\eta^\star\) 越小。
- \(\eta\to0\) 时退化为连续时间复制者动力学。 此时 \(f'\to1\),必然收敛。这是下面算例的一条校验。
6.7.3 算例#
算例 6.2(无线版分岔点:两小区抢频带的 Hedge 一维映射)【本站演算】
用 6.2 节的数:\(x^\star=0.694334\),\(D_A=0.761451\),\(D_B=0.502840\),\(D_A+D_B=1.264291\)。
第 1 步:阈值。
换成未归一化的原始速率(Mb/s)作代价:\(D_A^{\text{raw}}=80-19.0839=60.9161\),\(D_B^{\text{raw}}=50-9.7728=40.2272\),和为 \(101.1433\),于是
两个数字的反差就是本算例的重点。归一化之后要 \(\eta>7.45\) 才失稳,远大于理论推荐的 \(\eta=\sqrt{8\ln2/T}\)(\(T=100\) 时只有 \(0.235\))。不归一化则 \(\eta>0.093\) 就失稳,这是一个再普通不过的学习率。
第 2 步:倍周期级联。 数值,\(x_0=0.30\),每点先跑 \(2\times10^5\) 步弃掉瞬态。
| 事件 | \(\eta\) | 说明 |
|---|---|---|
| 不动点失稳(周期 1 → 2) | \(\eta_1=7.453621\) | 解析值,命题 6.11 |
| 周期 2 → 4 | \(\eta_2=10.144761\) | 二分法定位 |
| 周期 4 → 8 | \(\eta_3=10.977451\) | 二分法定位 |
| 周期 8 → 16 | \(\eta_4=11.155072\) | 二分法定位 |
| Lyapunov 指数变正(混沌起点) | \(\eta_\infty\approx11.204\) | 二分法定位 |
| 周期 3 窗口(\(\Rightarrow\) Li–Yorke) | \(\eta=15\) | 轨道 \(\{0.999849,\,0.952700,\,0.130453\}\) |
第 3 步:轨道类型的三个样本。
- \(\eta=4\):\(2\) 步收敛到 \(0.6943\)。
- \(\eta=9\):周期 2,\(\{0.4687,\,0.9200\}\),Lyapunov 指数 \(-0.606\)。
- \(\eta=13\):Lyapunov 指数 \(+0.320\),轨道范围 \([0.2160,\,0.9986]\)。初值差 \(10^{-9}\) 的两条轨道约 15 步后相差 \(10^{-6}\)、约 57 步后相差 \(0.1\)(与 Lyapunov 指数一致:\(\ln(10^{8})/0.32\approx57\))。
第 4 步:同参数下线性变体在干什么。 取 \(\varepsilon=1-e^{-13}=0.99999774\)(对应 \(\eta=13\))。可行条件 \(\varepsilon<1/c_{\max}=1/0.877840=1.13916\) ✓ 满足。
数值结果:\(\mathrm{MWU}_\ell\) 从 \(x_0=0.30\) 出发收敛到 \(x=0.694334\)(即精确的混合 Nash),\(\eta=9,15\) 亦然。同一个博弈、同一个步长,线性变体收敛、指数变体混沌。定理 6.8 与 6.9 的对照在本站的无线例子上原样重现。
校验
- 1. 导数两条独立路径。 解析式 \(f'(x^\star)=1-\eta x^\star(1-x^\star)(D_A+D_B)\) 在 \(\eta=\eta^\star\) 处给 \(-1.000000\);中心差分数值微分(步长 \(10^{-7}\))给 \(-1.000000\) ✓。
- 2. \(\eta\to0\) 退化为复制者动力学。
- 理论上 \(\frac{f_\eta(x)-x}{\eta}\to x(1-x)\Delta(x)\)。在 \(x=0.4\) 处:\(x(1-x)\Delta(x)=0.4\times0.6\times0.372124=0.0893097\)。
- 数值 \(\frac{f_\eta(0.4)-0.4}{\eta}\) 在 \(\eta=10^{-3},10^{-4},10^{-5}\) 分别为 \(0.0893130,\,0.0893100,\,0.0893097\) ✓ 单调收敛到解析值。
- 连续时间复制者方程 \(\dot x=x(1-x)\Delta(x)\) 在 \(\Delta\) 单调降过零时全局收敛到 \(x^\star\),与表中 \(\eta<\eta^\star\) 收敛一致 ✓。
- 3. Feigenbaum 常数。
- 倍周期级联里,相邻两次分岔的间距越来越短,而且按一个固定比例缩短:\(\frac{\eta_{k}-\eta_{k-1}}{\eta_{k+1}-\eta_{k}}\to\delta=4.6692\ldots\)(\(k\to\infty\))。
- Feigenbaum(1978)发现,对一大类一维映射(logistic 映射 \(x\mapsto rx(1-x)\) 是最有名的例子),这个比值都趋于同一个 \(\delta\),与映射的具体公式无关,所以叫普适常数。
- 本例的级联比 \(\frac{\eta_3-\eta_2}{\eta_4-\eta_3}=\frac{0.832690}{0.177621}=4.6880\),与 \(\delta\) 相差 \(0.4\%\) ✓。只用了前几次分岔,比值还没完全收敛,差零点几个百分点正常。
- 这是一个完全独立于本模型的普适常数,能对上说明级联定位没有算错。
- 它还能反过来预言混沌起点:间距按公比 \(1/\delta\) 缩短,累加得 \(\eta_\infty\approx\eta_4+\frac{\eta_4-\eta_3}{\delta-1}=11.155072+\frac{0.177621}{3.6692}=11.2035\),与表中由 Lyapunov 指数变号定位的 \(11.204\) 一致 ✓。
- 4. 单位不变性。 \(\eta^\star_{\text{raw}}\times80\ \mathrm{Mb/s}=0.093170\times80=7.453621=\eta^\star\) ✓(命题 6.11 第 3 条)。
- 5. 周期 3 蕴含混沌。 \(\eta=15\) 处存在周期 3 轨道,由 Sharkovskii / Li–Yorke 定理,存在任意周期的轨道与不可数的混沌集 ✓(与定理 6.9(2) 的机制相同)。
算例 6.3(复算文献的两个映射,并给出文献没有给的阈值)【本站演算】
Palaiopanos 等 [5] 给了两个显式的一维映射,但没有给分岔阈值。用命题 6.11 补上。
(a) 对称例(原文定理 4.1)
两球两箱,\(c_{e_1}(\ell)=c_{e_2}(\ell)=\ell/2\),\(\varepsilon=1-e^{-10}\)(即 \(\eta=10\)),映射
此时 \(x^\star=1/2\),\(D_1=D_2=1/2\),命题 6.11 给
原文用的 \(\eta=10>8\),\(f'(1/2)=-1.5\),不动点失稳 ✓,与原文"收敛到周期 2 极限环"一致。
本站补充的观察【本站演算】:对这个对称例做 \(\eta\in[1,12]\) 的扫描,只有一次倍周期分岔。\(\eta>8\) 之后吸引子始终是周期 2,Lyapunov 指数始终为负,从不进入混沌。这与 Chotibut 等 [9] 关于"对称 50–50 均衡流恰有一次倍周期分岔"的报告方向一致。所以对称情形不是混沌的来源,不对称才是。
(b) 不对称例(原文图 1 的参数)
\(c_{e_1}(\ell)=\ell/4\),\(c_{e_2}(\ell)=1.4\ell/4\),\(\varepsilon=1-e^{-40}\)(\(\eta=40\)),映射
此时 \(D_1=0.25\),\(D_2=0.35\),\(x^\star=\frac{0.10+0.35}{0.60}=0.75\),命题 6.11 给
在 \(\eta=40\) 处 \(f'(0.75)=1-40\times0.1875\times0.6=-3.5\)。本站数值级联:
- \(\eta_1=17.7778\)(解析),\(\eta_2=23.4232\),\(\eta_3=25.0166\),\(\eta_4=25.3601\)。
- 混沌起点 \(\eta_\infty\approx25.6\)。
- \(\eta=32\) 处有周期 3 窗口(轨道 \(\{0.999621,\,0.956256,\,0.294123\}\))。
- \(\eta=40\) 处 Lyapunov 指数 \(+0.3759\)。
校验
- (i) \(\eta=40\) 处解析导数 \(-3.5\) 与数值中心差分 \(-3.5000\) 一致 ✓。
- (ii) 级联比 \(\frac{\eta_3-\eta_2}{\eta_4-\eta_3}=\frac{1.593313}{0.343515}=4.6383\),与 Feigenbaum 常数 \(4.6692\) 差 \(0.66\%\) ✓。
- (iii) \(\eta=32\) 的周期 3 轨道与定理 6.9(2)"存在周期 3 轨道"相符,是对原文定理的独立数值确认 ✓。
- (iv) 对称例的 \(\eta^\star=8\) 与原文所用 \(\eta=10\) 的关系(\(10>8\) 故失稳、且 \(10\) 落在只有周期 2 的区间)与原文定理 4.1 的结论一致 ✓。
诚实标注
\(\eta^\star=17.78\)(不对称)、\(\eta^\star=8\)(对称)、\(\eta^\star=7.4536\)(本站无线例)这三个阈值文献未给,是本站按命题 6.11 算出来的。倍周期级联的四个数值点与 Lyapunov 指数是数值实验,不是定理(与定理 6.9 的限定条件(c)一致)。
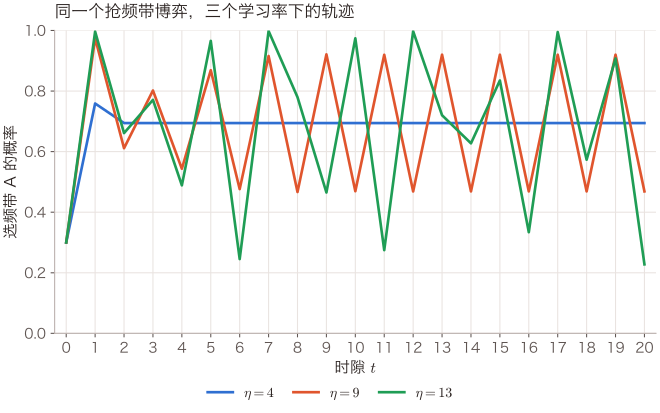
怎么读这张图
- 三条线是同一个映射 \(x_{t+1}=f_\eta(x_t)\) 在三个学习率下从同一个初值 \(x_0=0.30\) 出发的轨迹。
- 最平的一条是 \(\eta=4\)(\(<\eta^\star=7.4536\)),两步就锁在混合 Nash \(x^\star=0.6943\)。
- 中间一条是 \(\eta=9\),锁在周期 2 轨道 \(\{0.4687,0.9200\}\) 上来回。
- 最乱的一条是 \(\eta=13\),Lyapunov 指数 \(+0.320\),没有可辨认的周期。
数据由本站按算例 6.2 的模型迭代得到(代价取 6.2 节表中的归一化值)。
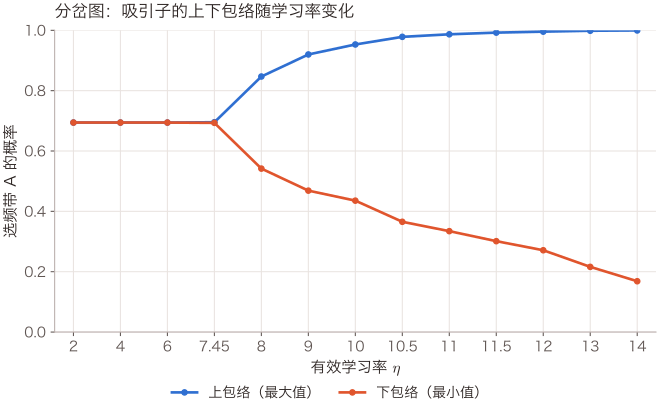
怎么读这张图
- 两条线是吸引子的最大值与最小值(丢掉 \(2\times10^4\) 步瞬态后取 \(4\times10^4\) 步的极值)。
- \(\eta<7.4536\) 时两条线重合在 \(x^\star=0.6943\),只有一个不动点。越过 \(\eta^\star\) 后张开成一个"叉",那是周期 2。
- \(\eta\approx10.14\)、\(10.98\)、\(11.16\) 处继续分叉(图上分辨率看不出来,见算例 6.2 的表)。
- \(\eta>11.20\) 后 Lyapunov 指数为正,包络继续张开直至几乎撑满 \([0,1]\)。
数据来自本站按算例 6.2 的模型做的数值扫描,横轴的 7.45 就是解析阈值 \(\eta^\star\)。
到此为止我们得到了什么
- 一维约化的显式映射与它的两种合法读法(\(N=2\) 的不变流形 / 连续体人口)。
- 一条闭式的翻转分岔阈值 \(\eta^\star=2/[x^\star(1-x^\star)(D_A+D_B)]\) 及其单位不变性。
- 无线例的三个数:\(\eta^\star=7.4536\)(归一化)、\(0.0932\)(原始 Mb/s)、混沌起点 \(11.20\)。
- 对文献两个映射的复算,补上了原文没给的阈值 \(8\) 与 \(17.78\),并用 Feigenbaum 常数(差 \(0.4\%\) 与 \(0.66\%\))做了独立校验。
6.8 时间平均收敛,末迭代混沌:一条能算的分离#
6.3 节说时间平均落进 CCE,6.7 节说末迭代可以混沌。这两句话怎么同时为真?这一节把它们摆在同一组数字上。
关键工具是换一个坐标:把概率 \(x\) 换成对数几率,指数权重的乘性更新就变成逐步累加。累加量被轨道的活动范围卡住,时间平均的误差也就被卡住了。
6.8.1 命题 6.12:时间平均与末迭代的可算分离#
命题 6.12(时间平均与末迭代的可算分离)【本站演算】
对 6.7 节的映射,设 \(\Delta\) 仿射、斜率 \(-(D_A+D_B)\)、零点 \(x^\star\),且轨道 \(\{x_t\}\) 停留在 \([\underline x,\overline x]\subset(0,1)\)。
记 logit(对数几率)\(\ell_t=\ln\frac{x_t}{1-x_t}\)。它把 \((0,1)\) 一一地拉到整条实轴:\(x=1/2\) 对应 \(\ell=0\),\(x\to0\) 时 \(\ell\to-\infty\),\(x\to1\) 时 \(\ell\to+\infty\),反过来 \(x=1/(1+e^{-\ell})\)。再记 \(\bar x_T=\frac1T\sum_{t<T}x_t\)。则
- 恒等式:\(\ell_{t+1}=\ell_t+\eta\,\Delta(x_t)\);
-
时间平均以 \(O(1/T)\) 收敛到混合 Nash:
\[ \big|\bar x_T-x^\star\big|\;\le\;\frac{\ell_{\max}-\ell_{\min}}{\eta\,T\,(D_A+D_B)}, \qquad \ell_{\max}=\ln\tfrac{\overline x}{1-\overline x},\ \ \ell_{\min}=\ln\tfrac{\underline x}{1-\underline x}; \] -
代价的时间平均却不等于 Nash 的代价:设每人的期望代价 \(C(x)=x\hat c_A(x)+(1-x)\hat c_B(x)\)(\(x\) 的二次函数,二阶导 \(C''\) 为常数),则
\[ \overline{C}_T\;=\;C(\bar x_T)+\tfrac12\,C''\cdot\operatorname{Var}_T(x)\;\xrightarrow[T\to\infty]{}\;C(x^\star)+\tfrac12 C''\operatorname{Var}_\infty(x); \] -
两者的差恰是每轮平均外部后悔:\(\overline{C}_T-\min_{a}\overline{\hat c_a}\) 等于经验联合分布违反 CCE 的量(定理 6.3)。
6.8.2 证明与解读#
证明(四步)
第 1 步:logit 恒等式。 沿用命题 6.11 证明里的分母 \(D=x_t+(1-x_t)e^{-\eta\Delta(x_t)}\):映射是 \(x_{t+1}=x_t/D\),于是 \(1-x_{t+1}=(D-x_t)/D=(1-x_t)e^{-\eta\Delta(x_t)}/D\)。两式相除,\(D\) 约掉:
取对数即得。
第 2 步:时间平均的界。 对第 1 条从 \(0\) 到 \(T-1\) 求和,左边 \(\sum_t(\ell_{t+1}-\ell_t)\) 逐项相消(望远镜求和):\(\eta\sum_t\Delta(x_t)=\ell_T-\ell_0\)。
因 \(\Delta\) 仿射(\(\Delta(x)=\alpha+\beta x\) 型),平均可以移进函数里:\(\frac1T\sum_t\Delta(x_t)=\alpha+\beta\bar x_T=\Delta(\bar x_T)\)。而 \(\Delta(\bar x_T)-\Delta(x^\star)=-(D_A+D_B)(\bar x_T-x^\star)\) 且 \(\Delta(x^\star)=0\)。
合起来 \(|\bar x_T-x^\star|=\frac{|\ell_T-\ell_0|}{\eta T(D_A+D_B)}\le\frac{\ell_{\max}-\ell_{\min}}{\eta T(D_A+D_B)}\) ✓。
最后一个不等号:logit 单调增,\(x_0,x_T\in[\underline x,\overline x]\) 推出 \(\ell_0,\ell_T\in[\ell_{\min},\ell_{\max}]\),两者之差不超过区间长度。
第 3 步:代价的时间平均。 \(C\) 是二次函数,Taylor 展开在 \(\bar x_T\) 处精确(三阶及以上导数为零):\(C(x)=C(\bar x_T)+C'(\bar x_T)(x-\bar x_T)+\frac12C''(x-\bar x_T)^2\)。
对 \(t\) 平均,一次项的平均为零(\(\frac1T\sum_t(x_t-\bar x_T)=0\)),二次项的平均正是经验方差 \(\operatorname{Var}_T(x):=\frac1T\sum_{t<T}(x_t-\bar x_T)^2\),得第 3 条 ✓。
第 4 步:对上 regret。 由定理 6.3 第 4 步,CCE 违反量 \(=R_i(T)/T=\overline{C}_T-\min_{a}\frac1T\sum_t\hat c_a(x_t)\) ✓。\(\blacksquare\)
第 3 条的超额与第 4 条的后悔为什么是同一个数
- \(\hat c_A,\hat c_B\) 都是 \(x\) 的仿射函数,所以 \(\frac1T\sum_t\hat c_a(x_t)=\hat c_a(\bar x_T)\)。
- \(\bar x_T\to x^\star\),而在混合 Nash 处两个动作的代价相等,都等于 \(C(x^\star)\)(6.2 节:\(\hat c_A(x^\star)=\hat c_B(x^\star)=0.528701\))。
- 于是 \(\min_a\) 那一项趋于 \(C(x^\star)\):每轮平均后悔与第 3 条的超额 \(\overline C_T-C(x^\star)\) 之差趋于零,两者有同一个极限 \(\tfrac12C''\operatorname{Var}_\infty(x)\)。
算例 6.4 的校验 3 用数字验证了这一点。
物理意义
- 第 2 条说"直方图是对的"。 无论轨道多乱,只要它不贴边界,混合策略的时间平均以 \(1/T\) 的速度收敛到混合 Nash,而且常数是显式的(logit 跨度除以 \(\eta\) 与代价斜率)。
- 第 3 条说"账不是这么算的"。 实际代价是策略的二次函数,时间平均的代价里多出一项 \(\frac12C''\operatorname{Var}(x)\)。轨道的波动本身要付钱。
- 第 4 条把这笔钱认成 regret。 正因为常步长 Hedge 的 regret 不是 \(o(T)\),经验分布才不是 CCE。
行为分析
- 加大学习率是一个干净的两难。 \(\eta\) 越大,第 2 条的界越紧(分母有 \(\eta\)),但第 3 条的 \(\operatorname{Var}\) 越大。加大学习率让"直方图"更快对上,也让"实际代价"更差。
- 波动不一定亏。 若 \(C''<0\)(代价对策略是凹的),波动反而省钱;本例 \(C''>0\),波动纯亏。
- 这是"时间平均收敛"与"工程上收敛"的定量分离。 \(T\to\infty\) 时第 2 条给 \(0\),第 3 条给一个不消失的正的超额。
6.8.3 算例:学习率为 13 的混沌轨道#
算例 6.4(分离的数字:\(\eta=13\) 的混沌轨道)【本站演算】
参数同算例 6.2,\(\eta=13\),弃掉 \(5\times10^4\) 步瞬态后统计 \(T=2\times10^6\) 步。
| 量 | 数值 | 出处 |
|---|---|---|
| 混合 Nash \(x^\star\) | \(0.6943339\) | 6.2 节解析 |
| 轨道时间平均 \(\bar x_T\) | \(0.6943340\) | 数值 |
| 偏差 \(\lvert\bar x_T-x^\star\rvert\) | \(1.334\times10^{-7}\) | 数值 |
| 命题 6.12(2) 的界 | \(2.392\times10^{-7}\) | \(\ell\) 跨度 \(7.8625\),\(\eta T(D_A+D_B)=13\times2\times10^6\times1.264291\) |
| 轨道方差 \(\operatorname{Var}(x)\) | \(0.080849\) | 数值 |
| Lyapunov 指数 | \(+0.320\) | 数值 |
| 混合 Nash 的每人代价 \(C(x^\star)\) | \(0.528701\) | 6.2 节解析 |
| 轨道的时间平均代价 \(\overline{C}_T\) | \(0.630917\) | 数值 |
| 超额 \(\overline{C}_T-C(x^\star)\) | \(0.102216\) | \(=19.33\%\) |
| 社会最优(错开)每人代价 | \(0.187500\) | 6.2 节 |
三个比值
- 混沌轨道 / 社会最优 \(=3.3649\)。
- 混合 Nash / 社会最优 \(=2.8197\)。
- 纯 Nash / 社会最优 \(=1.0000\)(纯 Nash 恰是社会最优,所以按纯 Nash 算的无政府代价 PoA \(=1\))。
一句话送给第 8 章:这个博弈的 PoA(按纯 Nash)等于 \(1\),即"自私不花钱";而实际跑起来的学习动力学,时间平均代价是社会最优的 \(3.36\) 倍。PoA 完全没有覆盖这条轨道,因为轨道不在均衡集里。这就是 Chotibut 等 [9] 那句"PoA 何时过于乐观"的一个可算实例。
校验
- 1. 界的验证。 \(1.334\times10^{-7}\le2.392\times10^{-7}\) ✓,且比值 \(0.558\),同数量级,说明界不松也不错。
- 2. 方差恒等式(独立途径)。
- \(C(x)=x[x\,c_A(2)+(1-x)c_A(1)]+(1-x)[(1-x)c_B(2)+x\,c_B(1)]\),二阶导 \(C''=2[c_A(2)+c_B(2)-c_B(1)]=2\times1.264291=2.528582\)。
- 于是 \(\tfrac12C''\operatorname{Var}=\tfrac12\times2.528582\times0.080849=0.102216\),与直接统计的超额 \(0.102216\) 逐位相同 ✓。
- 这是一个恒等式而不是近似,所以它同时验证了 \(\bar x\)、\(\operatorname{Var}\)、\(\overline C\) 三个统计量。
- 3. regret 与 CCE 违反量对上。
- 该轨道的经验联合分布,取每步乘积分布 \(x_t\otimes x_t\) 的时间平均,即两个小区每步都按 \(x_t\) 抽样时直方图的期望。两人用同一个 \(x_t\),所以 \(\sigma_{AA}=\overline{x_t^2}\),比 \(\bar x^2\) 多出一个方差。
- 它是 \((\sigma_{AA},\sigma_{AB},\sigma_{BA},\sigma_{BB})=(0.56297,0.13137,0.13137,0.17430)\)。代入定义 6.3,任一玩家固定偏离的收益增量是 \(0.10222\),与超额代价 \(0.102216\) 相同 ✓(命题 6.12(4))。
- 所以它不是 CCE。这与"常步长 Hedge 不是无后悔算法"完全自洽(定理 6.3 的前提不满足)。
- 4. 对照组。 同样统计 \(\eta=4\)(收敛区):\(\overline{C}_T=0.528701=C(x^\star)\),\(\operatorname{Var}=0\),固定偏离增量 \(0.000000\),经验分布 \((0.48210,0.21223,0.21223,0.09343)\) 是 CCE(就是混合 Nash 的乘积分布)✓。两组一正一反,说明分离不是数值噪声。
- 5. 复现精度。
- 混沌轨道的时间平均只能复现到小数点后三位左右:换一个初值或一种浮点实现,第四位就会漂。本站用同样的设置另跑两次,超额分别为 \(0.10208\) 与 \(0.10215\),方差约 \(0.0807\)–\(0.0808\)。
- 表中经验联合分布与方差两栏也出自不同的运行,第五位对不上(按 \(\sigma_{AA}=\overline{x_t^2}=\operatorname{Var}+\bar x^2\) 应得 \(0.56295\),表中是 \(0.56297\))。
- 但每一次运行内部,超额与 \(\tfrac12C''\operatorname{Var}\) 都逐位相等,与 CCE 违反量也相等。恒等式不依赖具体数值。
陷阱:不要把"轨道时间平均 \(=\) Nash"读成"性能 \(=\) Nash 性能"
校验 2 是本章最该记住的一条恒等式。混合策略的时间平均精确等于混合 Nash(误差 \(10^{-7}\)),实际代价却高 \(19.3\%\)。
原因很简单:代价是策略的二次函数,而两个小区在同一条轨道上是完全相关的(都用同一个 \(x_t\)),\(\overline{x_t^2}>\bar x^2\)。一阶统计量对上了,二阶统计量没对上。任何用"平均行为收敛了"来论证系统性能的推理,都要先检查这一项。
到此为止我们得到了什么
- 一条把两个方向的结论同时写下的命题:logit 恒等式给出时间平均以 \(O(1/T)\) 收敛到混合 Nash(界 \(2.39\times10^{-7}\),实测 \(1.33\times10^{-7}\))。
- 代价的时间平均比 Nash 高一项 \(\frac12C''\operatorname{Var}=0.1022\)(\(19.3\%\)),且这一项精确等于每轮平均外部后悔,也精确等于经验分布违反 CCE 的量。
- 纯 Nash 的 PoA 是 \(1\),而混沌轨道的时间平均代价是社会最优的 \(3.36\) 倍。
6.9 学习动力学相图#
6.9.1 三条轴,两条有先例,一条没有#
把前面的结论按坐标摆开:
- 横轴:博弈类。 左端是有势函数的(拥塞、干扰、协调类),右端是零和 / 一般博弈。左端有定理 6.5、6.8 兜底,右端只有定理 6.3 的时间平均。
- 纵轴(本章合成):步长 \(\times\) 观测噪声。 下端是小步长 + 干净观测,上端是大步长 + 强噪声。步长轴有明确先例(Palaiopanos 等 [5] 的 Conclusion、Chotibut 等 [9] 以需求为分岔参数、Biggar 等 [11] 以离散化模型为轴、Bielawski 等 [10] 以记忆为轴)。观测噪声轴据本站检索未见先例【本站提法】。
- 第三条轴(本章只点到):谁在何时更新。 同步 / 轮询 / 异步。势博弈里同步更新可能不收敛而轮询收敛,是"所有基站同一 TTI 一起调"的现实陷阱(第 8 章展开)。
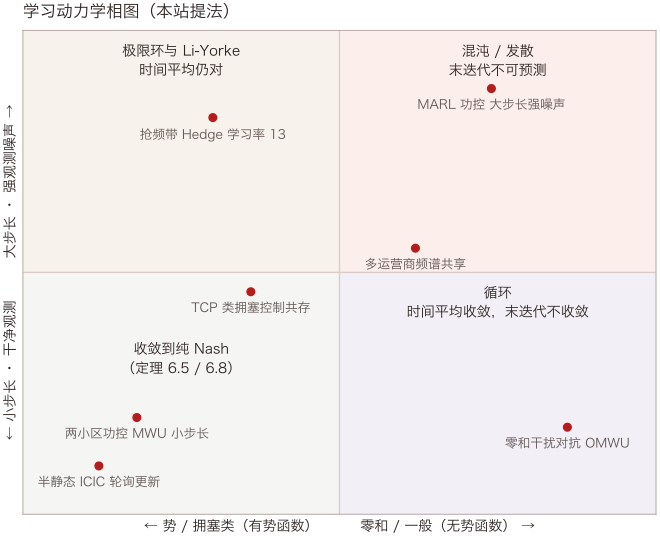
怎么读这张图
- 横轴越往右,博弈越"目标冲突",可用的收敛定理越少;纵轴越往上,离散化尺度与观测噪声越大。
- 左下(第三象限)是唯一有定理保证轨迹收敛的区域:势博弈 + 更优响应 / 小步长(定理 6.5、6.8)。
- 左上(第二象限)是本章算例 6.2 落的地方:势博弈但学习率越过 \(\eta^\star=7.4536\),出极限环与 Li–Yorke 混沌,此时时间平均仍以 \(O(1/T)\) 对上混合 Nash(命题 6.12)。
- 右下(第四象限)是零和的经典画面:时间平均收敛、末迭代循环甚至奔向边界(定理 6.6),OMWU 可以把它拉回收敛(定理 6.7)。
- 右上(第一象限)什么定理都没有,MARL 做功控 / 调度落在这里。
七个系统点的坐标是定性摆放,用于表达序关系;只有"抢频带 Hedge 学习率 13"这一点有定量依据(算例 6.2、6.3)。
6.9.2 猜想 6.13:把相图写成判据#
猜想 6.13(网络博弈 × 局部观测 × 通信约束的收敛/循环/混沌相图)【开放·本站提法】
考虑 \(N\) 个决策者按一张干扰图 \(\mathcal{G}\) 耦合、每人只观测自己邻域的聚合量(且观测带方差 \(\sigma_o^2\) 的噪声)、按学习率 \(\eta\) 跑指数权重更新。猜想存在一条只依赖于 \((\mathcal{G},\eta,\sigma_o^2)\) 的判据,把状态空间分成三块:
- 收敛区:\(\eta\cdot\rho(\mathcal{G})\cdot D<\theta_1\),末迭代收敛到纯 Nash;
- 循环区:\(\theta_1<\eta\rho D<\theta_2\),末迭代落到有限周期轨道;
- 混沌区:\(\eta\rho D>\theta_2\),正 Lyapunov 指数,
其中 \(D\) 是代价落差(命题 6.11 的 \(D_A+D_B\) 的推广),\(\rho(\mathcal{G})\) 是图的某个谱量(候选:邻接矩阵谱半径、或干扰图的谱隙),\(\theta_1,\theta_2\) 是普适常数。
已知的两个端点
- \(N=2\)、\(\mathcal{G}\) 是一条边、\(\sigma_o^2=0\) 时,命题 6.11 给出 \(\theta_1=2\) 与 \(\rho\cdot D=x^\star(1-x^\star)(D_A+D_B)\)。这就是第一个可证的引理。
- 另一端 \(N\to\infty\)、\(\mathcal{G}\) 全连通、只依赖平均场时,Chotibut 等 [9] 的路由博弈结果给出"承载阈值 → 倍周期 → Li–Yorke 混沌 + 正拓扑熵",与本猜想的三区结构同型。
未知的中段
\(\rho(\mathcal{G})\) 到底是哪个谱量、\(\theta_1,\theta_2\) 是否普适、以及观测噪声 \(\sigma_o^2\) 怎么进这个判据,全部是空白。噪声抑制混沌还是诱发混沌?Bielawski 等 [10] 证明"记忆"抑制混沌,噪声与记忆在这里是不是同一个机制?
为什么值得做
它是第 3 章信息结构相图(结构 → 可解性)在动力学上的对应物。那里的相边界是 \(d\le p\)(回传时延对耦合时标),这里的相边界是 \(\eta\rho D\) 对普适常数。两张相图合起来就是第 9 章的两条缺失定理。
诚实标注:本站没有发现混沌
混沌本身是文献结论([4][5][9])。本站做的三件事是:
- (i) 按命题 6.11 把阈值算成闭式,并给出文献未给的数(\(8\)、\(17.78\)、\(7.4536\))。
- (ii) 把这套机制搬到无线的干扰 / 频带博弈上。功控与 ICIC 被建成势博弈并用复制者动力学做分布式收敛的无线文献存在,但本站检索未见任何无线论文报告 MWU / 复制者在这类问题中出现极限环或混沌,所以这一搬运标【本站提法·未见先例】。
- (iii) 把"观测噪声"作为相图的一条轴提出来,同样未见先例【本站提法】。
不得读成"本站首次发现学习混沌"。
6.9.3 本章路标#
从虚拟对策到学习混沌:本章的路标
| 年份 | 路标 |
|---|---|
| 1951 | Brown 提出虚拟对策(各自对经验分布最优响应) |
| 1996 | Monderer-Shapley 势博弈与有限改进性质(定理 6.5) |
| 2000 | Hart-Mas-Colell 后悔匹配 → 相关均衡(定理 6.4) |
| 2002 | Sato-Akiyama-Farmer 石头剪刀布学习的哈密顿混沌 |
| 2006 | Cesa-Bianchi-Lugosi 教材把 no-regret \(\Rightarrow\) CCE 定型(定理 6.3) |
| 2017 | Palaiopanos 等 线性变体收敛 / 指数变体 Li-Yorke 混沌(定理 6.8、6.9) |
| 2018 | Bailey-Piliouras 零和 MWU 奔向边界(定理 6.6);Daskalakis-Panageas OMWU 末迭代收敛(定理 6.7) |
| 2020 | Chotibut 等 路由博弈的混沌之路 与 PoA 何时过于乐观 |
| 2024 | Bielawski 等 记忆可以抑制混沌(相图的第三条轴) |
| 2025 | Biggar 等 离散时间才是混沌的来源(步长轴 = 离散化轴) |
| 2026 | 本站 无线版分岔阈值与相图猜想 6.13 |
怎么读这张表
- 上半段(1951–2006)是"好消息"的积累:虚拟对策、势博弈、后悔匹配、no-regret \(\Longrightarrow\) CCE,每一条都是正面保证。
- 2002 年 Sato 等第一次在零和博弈里看到真混沌,2017 年 Palaiopanos 等把它推进势博弈(并同时证明线性变体收敛)。2018 年两条相反方向的结果同年出现,一条是发散,一条是修复。
- 2020 年之后的三条是把混沌参数化的努力:需求轴、记忆轴、离散化轴。
- 本站在最后一行做的,是把这套机制接到无线的干扰博弈上并补上阈值数字,没有提出新机制。
年份与题目来自本章参考文献。
到此为止我们得到了什么
- 一张三区相图(收敛 / 循环 / 混沌 + 时间平均收敛但末迭代不收敛),横轴博弈类,纵轴步长与观测噪声。
- 一条把它写成判据的猜想 6.13:两个端点已知,\(\rho(\mathcal{G})\) 与噪声怎么进判据未知。
- 一段明确的产权划分:混沌是文献的,阈值数字、无线搬运与噪声轴是本站的。
6.10 场景与方法盘点#
6.10.1 四个当代场景#
(1)MARL 做功控 / 调度:训练不稳定不是玄学
用 MARL 训练多个基站的功率 / 波束策略,工程上普遍报告"训练曲线来回摆、换个随机种子结果差很多"。本章给了它一个可检验的假说:这是相图右上角。
- 博弈类不明(一般博弈,未必有势函数)。
- 学习率大(为了在有限样本里收敛)。
- 观测有噪声(SINR 估计、上报时延)。
命题 6.11 给出一个可以直接套的诊断:把你的算法的有效学习率乘上回报的动态范围,看它有没有越过 \(O(1)\) 的量级。如果你把原始吞吐量(Mb/s)而不是归一化回报送进 softmax 策略,等效学习率被放大了几十倍(算例 6.2:\(7.4536\) 对 \(0.0932\))。
(2)多运营商频谱共享
两家运营商各自跑自适应的频谱选择,谁也不告诉对方参数。这是本章 6.2 节那个抢频带博弈的直接放大版。三个可算的结论:
- 纯 Nash(错开)恰是社会最优。
- 混合 Nash 差 \(2.82\) 倍。
- 学习率过大时时间平均代价差 \(3.36\) 倍。
而要落到那个好的相关均衡上,需要一个公共随机信号。它的价钱是第 4 章命题 4.4 的 \(1-h(\epsilon)\)(\(\epsilon=0.1\) 时 \(0.531\) 比特/时隙)。"协调只要半个比特,不协调要多付 3.36 倍代价",这是本站能给出的最干净的一次协调定价。
(3)TCP 类拥塞控制的共存
多条流共享瓶颈、各自按丢包 / 时延调速率,是标准的拥塞博弈 + 自适应动力学。已知的现象(同步化、锯齿、多流之间的周期性抢占)在本章的语言里就是相图左上区。Chotibut 等 [9] 的路由博弈混沌是这一类的理论版本。
(4)ISAC 与边缘推理的资源自适应
多个节点同时自适应地分配"通信 vs 感知"或"本地算 vs 上传"的比例,代价函数彼此耦合。这类问题往往能写出势函数(资源守恒 + 单调代价),因而落在相图左侧。
但它们的更新常常是同步的(每个大帧统一决策),定理 6.5 不覆盖的就是这一条。
6.10.2 方法盘点#
| 方法 | 解决了什么 | 回答不了什么 | 缺的定理落在哪 |
|---|---|---|---|
| no-regret / 在线学习(定理 6.3、6.4) | 无需模型、无需通信、无需博弈结构,给出时间平均落进 CCE(或 CE)的普适保证;有显式的 regret 界与最优步长 | 只管直方图不管末迭代;常步长时前提就不成立;落点是集合不是点,集合里可以很差(CCE 占单纯形 13.73%) | 命题 6.12 是一个可算样本;一般化的"末迭代 vs 时间平均"分离界是空白 |
| 势博弈 / 博弈学习理论(定理 6.5、6.8) | 在有势函数的问题上给出轨迹收敛与纯 Nash 存在;线性 MWU 在拥塞博弈里收敛到精确 Nash | 只在特殊类里成立;对"你实际在跑的那个更新规则"不作保证(定理 6.9 是反例);对同步更新不适用;收敛速度只有 \(\lvert A\rvert\) 这种指数上界 | 猜想 6.13;同步 / 异步的收敛判据(第 8 章) |
| 乐观 / 外梯度方法(定理 6.7) | 在零和(更一般地单调场)上恢复末迭代收敛 | 一般博弈无保证;只有渐近结论没有速率;对观测噪声的鲁棒性未刻画 | 相图右上角整个是空白 |
| MARL(CTDE、策略梯度族) | 工程上跑得动:非线性、大状态空间、不需要显式模型;仿真里确实有效 | 没有收敛保证,也没有"什么时候会不收敛"的判据;把信息结构当成环境细节而不是研究对象(第 2 章 2.8 节同一条批评);训练不稳定被当成调参问题而不是动力学问题 | 猜想 6.13 就是给它的诊断判据 |
| 动力系统 / 分岔分析([5][9][10][11]) | 把"会不会收敛"变成可算的谱条件(\(\lvert f'\rvert<1\))、把失稳路线参数化(步长、需求、记忆、离散化模型) | 目前只做到低维、低玩家数、特殊代价函数;图结构与观测噪声没有进入判据;没有任何无线实例 | 猜想 6.13 的 \(\rho(\mathcal{G})\) 与 \(\sigma_o^2\) 两项 |
五行读下来是同一句话。关于"一起学习",我们有:
- 一条不要求任何结构的统计保证(CCE)。
- 一条要求很强结构的轨迹保证(势 + 更优响应)。
- 一条只在零和成立的修复(乐观方法)。
中间那一大片,即有图结构、有局部观测、有通信约束、有噪声、大家同步更新的真实网络,什么都没有。本部第 9 章要立的第三条缺失定理就在这里。
到此为止我们得到了什么
- 四个场景的落点:MARL 训练不稳定对应相图右上角,且有一条可套的诊断;多运营商频谱共享是协调半个比特省 3.36 倍代价;TCP 共存在左上区;ISAC 资源自适应在左侧,但同步更新出界。
- 一张五行方法表,缺口集中在"图结构 + 局部观测 + 噪声 + 同步更新"这一片。
开放问题#
-
【开放·本站提法】网络博弈 × 局部观测 × 通信约束的相图(猜想 6.13)
- 三区判据 \(\eta\rho(\mathcal{G})D\) 对普适常数。
- 已知端点:\(N=2\) 无噪声时命题 6.11 给出 \(\theta_1=2\) 的闭式;\(N\to\infty\) 全连通时 Chotibut 等 [9] 给出同型的三区结构。
- 第一步可证引理:把命题 6.11 从两玩家推广到"\(N\) 个玩家、干扰图为 \(d\)-正则、每人观测邻域负载"的情形,看阈值里出现的是邻接矩阵的谱半径 \(d\) 还是别的量。
-
【开放】观测噪声是抑制混沌还是诱发混沌
- Bielawski 等 [10] 证明记忆 / 折扣抑制混沌。噪声在动力系统里通常起两种相反作用:平滑掉细结构,或把轨道踢出稳定盆。
- 本章的相图把噪声与步长放在同一条轴上,这是一个待检验的假设,不是结论。
- 最小的可证版本:在算例 6.2 的一维映射上加方差 \(\sigma_o^2\) 的观测噪声,问不变测度的 Lyapunov 指数随 \(\sigma_o^2\) 单调降还是单调升。
-
【开放】末迭代与时间平均的一般分离界
- 命题 6.12 只在"\(\Delta\) 仿射、代价二次、一维"的情形给出恒等式 \(\overline{C}-C(\bar x)=\frac12C''\operatorname{Var}\)。
- 一般博弈里,"经验分布到 CCE 的距离"与"末迭代到均衡集的距离"之间有没有一条不依赖模型的关系?这条一旦有了,"时间平均收敛"这句话在工程上就有了折扣率。
-
【开放】混沌轨道的代价与 PoA 的关系
- 算例 6.4 给出一个 PoA \(=1\)(纯 Nash)而混沌轨道时间平均代价是社会最优 \(3.36\) 倍的例子。Chotibut 等 [9] 提出"PoA 何时过于乐观",但据本站检索没有给出"动力学代价 / 最优"这个比值的一般上界。
- 候选提法:定义"学习的无政府代价" \(\mathrm{PoA}_{\mathrm{dyn}}(\eta):=\sup_{x_0}\overline{C}(\eta,x_0)/C^{\mathrm{opt}}\),问它随 \(\eta\) 的形状(本章的数字给出两个点:\(\eta=4\) 时 \(2.82\)、\(\eta=13\) 时 \(3.36\))。
- 这条与第 8 章的 PoA / PoS / 第三部 PoL 同族,属"价格家族"的第四个成员【探索·本站提法】。
-
【开放】同步更新的收敛判据
- 势博弈中同步更新可能不收敛而轮询收敛(arXiv:1212.0724 命题 4;出处见第 8 章参考文献 [10])。真实网络里所有基站在同一个 TTI 更新是常态。
- 第一步:在算例 6.1 的两小区势博弈上把同步更优响应写成一个二维映射,判断 \((H,H)\) 的稳定性。若同步下它仍稳定,说明陷阱要在更大的动作集上才出现。
-
【部分结果】通有初值下的混沌
- Palaiopanos 等 [5] 的构造依赖对称初值,原文 Future Work 明说通有初值的情形尚不知道。本站数值(命题 6.10)显示 \(N=2\) 时对称流形是排斥的,混沌只是瞬态(\(10^{-9}\) 偏差 18 步后离开)。
- 但读法 2(连续体人口)里这个问题不存在。
- 开放的是中间:\(N\) 有限但较大时,"人口比例"的动力学离一维映射有多远,混沌是真的还是瞬态的?这直接连到第 7 章的 \(O(1/\sqrt N)\) 修正。
-
【表述待核】文献的精确表述(大部已核)
- Monderer–Shapley [1] 引理 2.5(第 129 页)原话为"有限博弈具有 FIP 当且仅当它有广义序数势"。
- Hart–Mas-Colell [3] 的结论分见第 3 节命题与第 2 节主定理,两者均已核原刊。
- Cesa-Bianchi–Lugosi [2] 的 Hedge 界为定理 2.2(二手核对),no-regret \(\Longrightarrow\) CCE 的章节号仍未核,写入正式引用前须回读原书。
-
【预印本·未评审】2024–2026 的三条线索
- Bielawski 等 [10](记忆抑制混沌)已在 Chaos 发表但本站未核对原文细节。
- Biggar 等 [11](离散化起源)为 IJGT 2025 在线版。
- 检索中另见若干 2025–2026 预印本(风险敏感群体博弈的分岔、混沌博弈动力学的自然不变测度、OMWU 何时慢),本章均未采用为承重引用。
参考文献#
- D. Monderer, L. S. Shapley, 《Potential games》, Games and Economic Behavior, 14(1):124–143, 1996. https://doi.org/10.1006/game.1996.0044
- N. Cesa-Bianchi, G. Lugosi, 《Prediction, Learning, and Games》, Cambridge University Press, 2006.
- S. Hart, A. Mas-Colell, 《A simple adaptive procedure leading to correlated equilibrium》, Econometrica, 68(5):1127–1150, 2000.
- Y. Sato, E. Akiyama, J. D. Farmer, 《Chaos in learning a simple two-person game》, PNAS, 99(7):4748–4751, 2002. https://www.pnas.org/doi/10.1073/pnas.032086299
- G. Palaiopanos, I. Panageas, G. Piliouras, 《Multiplicative Weights Update with Constant Step-Size in Congestion Games: Convergence, Limit Cycles and Chaos》, Proc. NIPS, 2017. https://arxiv.org/abs/1703.01138
- J. P. Bailey, G. Piliouras, 《Multiplicative Weights Update in Zero-Sum Games》, Proc. ACM EC, 2018. https://dl.acm.org/doi/10.1145/3219166.3219235
- P. Mertikopoulos, C. Papadimitriou, G. Piliouras, 《Cycles in adversarial regularized learning》, Proc. ACM-SIAM SODA, 2018.
- C. Daskalakis, I. Panageas, 《Last-Iterate Convergence: Zero-Sum Games and Constrained Min-Max Optimization》, Proc. ITCS, 2019. https://arxiv.org/abs/1807.04252
- T. Chotibut, F. Falniowski, M. Misiurewicz, G. Piliouras, 《The route to chaos in routing games: When is Price of Anarchy too optimistic?》, Proc. NeurIPS, 2020. https://arxiv.org/abs/1906.02486
- J. Bielawski, T. Chotibut, F. Falniowski, M. Misiurewicz, G. Piliouras, 《Memory loss can prevent chaos in game dynamics》, Chaos, 34, 2024. https://arxiv.org/abs/2201.10992
- O. Biggar 等, 《On the discrete-time origins of the replicator dynamics: from convergence to instability and chaos》, International Journal of Game Theory, 2025. https://doi.org/10.1007/s00182-025-00929-3