4 · 环境泛化:AI 空口为什么能迁移、何时失效#
"换个城市还灵吗?"
这是 3GPP 讨论 AI/ML 空口时被问得最多的一句大白话。
标准给出的回答是一条逃生通道,而不是保证。Rel-19 的 LCM(life cycle management,生命周期管理)规定模型要被监测,性能掉了就回退到传统方案。按第一部第 10 章的口径,它是保险丝,不是定理。
学习理论里倒是有"泛化界",但它们用的是抽象的分布距离,看不见电磁。举个例子:把一个在 UMa(urban macro,3GPP 的城区宏站场景)上训练的 CSI 压缩模型拿到 InH(indoor hotspot,室内热点场景)去测,泛化界会告诉你"目标误差不超过源误差加一"。这句话永远正确,也永远无用。
本章是本部 misspecification(误配)一线的主章。第 1 章定义 1.2 把链上的退化分成两种:garbling 是信息丢了,misspecification 是"你以为的矩阵"错了。换城市、换厂商、仿真到实网,全属后者。
本章按三步走:
- 先看信息论早已给出的误配原型。失配译码指接收机按一个错的信道模型去译码,GMI 是这时仍能保证可靠传输的一个速率。这方面 1996 年就有定理。
- 再看学习论的界为什么在物理层注定空洞(Ben-David 界与 CSI 指纹)。
- 然后交出无线独有的东西:环境的差异经 Maxwell 方程传导为信道的差异,这个传导有物理度量。
核心结果是一个二分:
- 模型若靠相位看环境,泛化半径是 \(\lambda/4\)(3.5 GHz 约 2 厘米,28 GHz 不到 3 毫米)。
- 模型若靠结构(时延、角度、功率)看环境,泛化半径是散射体尺度 \(L\)(米级)。
两者差几十到几百倍(以 \(L=1\) m 计,3.5 GHz 约 \(47\) 倍,28 GHz 约 \(370\) 倍)。同一类模型"有时能迁移、有时不能",物理原因就在这里。
本章预备知识
只需概率论、线性代数与信号与系统的本科内容,以及本部前三章。用到的内容:
- 互信息 \(I(X;Y)\)、微分熵 \(h(\cdot)\)、高斯信道容量 \(\tfrac12\log(1+P/N)\):预备篇 4。熵功率不等式预备篇没有讲,算例 4.1 第三步就地给出陈述。
- 信道估计误差、导频、多径与两径模型:预备篇 2。
- 实验 = 行随机矩阵、总变差 \(\|P-Q\|_{\mathrm{TV}}=\tfrac12\sum|P-Q|\)、定理 2.2 风险界的证明第三步(零质量向量的振幅不等式):第 2 章。
- 两种退化(定义 1.2)、猜想 1.3 里那个待定义的"误配半径"\(\rho\):第 1 章。
- 两径模型上的充分划分(引理 3.3)与它末尾预告的"相位敏感区":第 3 章 §3.4。
- 第一部的三件接口:\(\lambda/L\) 决定环境哪些细节被信道看见(第一部第 2 章);误差价签(第一部第 5 章);猜想形态 \(R_{e'}(f)\le R_e(f)+C\cdot d(e,e')\)(第一部第 10 章)。
**不需要测度论。**本章唯一的新工具是 Wasserstein-1 距离 \(W_1\),它在有限情形下就是一个"搬沙子"的线性规划,§4.5 从零定义并给数字例子。
4.1 换个城市还灵吗:把一句大白话写成一个量#
先把大白话翻译成记号,再用真实数字说明这个问题为什么不平凡。
4.1.1 记号:环境类、源与目标、风险差#
直觉
你在北京训练了一个模型,拿到上海去用。北京和上海各是一个"环境",每个环境按自己的方式生成数据。模型是同一个,只是喂给它的数据换了分布。
"还灵吗"问的是:同一个模型,在新分布下的平均损失比在旧分布下多了多少。
记号(沿用第一部第 10 章与本部第 1 章)
- 环境类 \(\mathcal{E}\):全体可能环境的集合,元素 \(e\in\mathcal{E}\) 是一个具体环境(一间房、一座城市的一个小区)。它与第 1 章定义 1.1 里"\(\mathcal{E}\) = 环境"是同一个字母。本章里凡是实验都写成 \((P_e)_{e\in\mathcal{E}}\) 或加下标 \(\mathcal{E}_k\),不再单独用 \(\mathcal{E}\) 表示实验。
- 环境到数据的映射 \(e\mapsto P_e\):环境 \(e\) 下一个样本 \(z\) 的分布。样本 \(z\) 是任务用到的全部东西,例如 CSI 压缩里 \(z=\mathbf{h}\)(信道向量本身),波束预测里 \(z=(\mathbf{h},\text{最优波束索引})\)。注意,这就是定义 2.1 里的一个实验:参数是环境 \(e\),观测是样本 \(z\)。
- 模型与损失:训练好的模型 \(f\),损失 \(\ell\in[0,1]\);记 \(g:=\ell\circ f\),即 \(g(z)\) 是"模型在样本 \(z\) 上的损失"。
-
风险 \(R_e(f):=\mathbb{E}_{z\sim P_e}\,g(z)\)。源环境 \(e\)(训练)、目标环境 \(e'\)(部署)。泛化差(generalization gap)
\[ \Gamma(e\to e';f):=R_{e'}(f)-R_e(f). \]
整章要回答的就是:\(\Gamma\) 由什么控制、多大。
一个 \(2\times2\) 的数字例子把记号跑通。样本 \(z\in\{\text{a},\text{b}\}\),环境 \(e\) 下 \(P_e=(0.9,\,0.1)\),环境 \(e'\) 下 \(P_{e'}=(0.6,\,0.4)\)。模型在 a 上损失 \(g(\text{a})=0.1\),在 b 上损失 \(g(\text{b})=0.8\)。则
模型没变,数据分布变了,损失涨了 0.21。这就是"换城市"的最小模型。
4.1.2 一条立刻能写下的界,以及它为什么没用#
把定理 2.2 证明第三步的手法照搬过来,分三步。
第一步:把泛化差写成一个内积。
其中 \(P_{e'}-P_e\) 是总质量为零的带符号向量,\(g\in[0,1]\)。
**第二步:给 \(g\) 减去一个常数。**总质量为零,所以给 \(g\) 减去任何常数 \(c\) 都不改变和式:
取 \(c\) 为 \(g\) 的最大值与最小值的中点,则 \(|g(z)-c|\) 不超过振幅 \(\|g\|\) 的一半。
**第三步:逐项取绝对值。**得 \(|\Gamma|\le\tfrac12\|g\|\sum_z|P_{e'}(z)-P_e(z)|\),后面的 \(\tfrac12\sum_z|\cdot|\) 就是总变差。于是
其中 \(\|g\|=\sup g-\inf g\le1\)。
回到上面的小例子:\(\|P_{e'}-P_e\|_{\mathrm{TV}}=\tfrac12(0.3+0.3)=0.3\),\(\|g\|=0.7\),界给 \(0.21\le0.21\),恰好取等,因为 \(g\) 恰在 \(P_{e'}-P_e\) 为正的地方取最大。
这条 TV 界是第 1 章猜想 1.3 里"误配半径 \(\rho\)"的第一个候选。它的问题不在于松,在无线里它几乎总是等于 1。
原因只有一条:两个不同环境的 CSI 分布几乎不重叠。信道向量是几百维的复向量,每个分量的相位由路径长度决定。两个环境哪怕只是一面墙挪了几厘米,所有反射径的相位都变了,两组 CSI 落在高维空间里两片互不相交的区域上。
总变差只看"重叠多少",不看"隔多远",它把"隔 1 毫米"与"隔 1 公里"都记作 1。§4.3 会证明学习论的 \(\mathcal{H}\Delta\mathcal{H}\) 界犯的是同一个毛病,§4.5 给出替代品。
4.1.3 真实数字:同类场景几乎不掉,跨类场景直接崩#
"换城市"到底掉多少?手头最接近的一组数字来自 Radwan 等 2026 [19]。
他们用 3GPP RAN4 共享的 Nokia、Oppo、CATT 三家数据集,训练 3GPP 基线的两侧模型(编码器在终端、解码器在基站,见第 2 章)做 CSI 压缩并交叉测试,得到下面三组数字。
要注意,TR 38.843 V19.0.0 §7.3.2.4 记录这类跨厂商数据集按同一套仿真假设生成,所以这组数字量的更接近"换一家的仿真实现",不是真实的"换城市"。度量是 SGCS(重建信道与真信道方向夹角余弦的平方,第 1 章已介绍),越接近 1 越好:
| 训练数据 → 测试数据 | SGCS | 相对变化 |
|---|---|---|
| Nokia 数据集自测 | 0.729 | — |
| Nokia 训练 → Oppo 数据测 | 0.735 | \(+0.8\%\) |
| Oppo 数据集自测 | 0.733 | — |
| Oppo 训练 → Nokia 数据测 | 0.726 | \(-1.0\%\) |
| CATT 数据集自测 | 0.674 | — |
| CATT 训练 → 他家数据测 | 0.637–0.644 | \(-4.5\%\) 到 \(-5.5\%\) |
| 室内 ↔ 室外互测(Case 2,[17]【预印本·未评审】) | 未给数 | "notably poor",归因于室内外 CSI 差异显著 |
相对变化由本站按表中 SGCS 计算:\(1-0.644/0.674=4.5\%\),\(1-0.637/0.674=5.5\%\)。
三家数据集按同一套仿真假设(Dense Urban 宏站、TR 38.901 信道模型)生成。Nokia 与 Oppo 互测几乎不掉。CATT 数据集只有 10 万样本,跨测掉 5% 左右。室内外互测按 [17] 的原话崩塌。
这张表就是本章的实证锚点,读法是三句话:
- 同类场景之间迁移几乎免费。
- 跨类场景迁移直接失败。
- 中间是一条陡坡。
任何泛化理论都必须解释这条陡坡。为什么两家厂商按同一套仿真假设生成的户外数据集之间 \(\Gamma\approx0\),而室内到室外 \(\Gamma\) 很大?TV 界解释不了,它对三种情形一律给 1。
本章的答案要到 §4.6 才完整:Nokia 与 Oppo 的数据集在相位上完全不同,在结构(时延扩展、角度扩展、稀疏度)上几乎相同,而两侧模型学到的是结构。
4.1.4 定位:这是耐用品的 misspecification#
按第 1 章 §1.3 的 \(2\times2\) 组织表,本章处理的是右侧一列,也就是模型错了:
- 易逝品被误读(右下格):译码器为一个信道模型设计,实际信道是另一个。这是失配译码的地盘,§4.2。
- 耐用品被设错(右上格):训练好的模型、建好的地图、标定好的数字孪生描述的是别处。这是分布偏移学习论与本章物理泛化界的地盘,§4.3–4.6。
两格的数学工具不同,但有同一个骨架:都在问"用为 \(e\) 准备的东西去应付 \(e'\),赔多少"。
易逝品那一格 1996 年就有定理,并且可以算出一个具体的数。耐用品那一格的定理是空的。本章的结构因此是先学有定理的那一格,再去填空的那一格。
到此为止我们得到了什么
一个量和一条陡坡。
- "换城市还灵吗"被写成泛化差 \(\Gamma(e\to e';f)=R_{e'}(f)-R_e(f)\)。
- 它有一条现成的 TV 界,但 CSI 分布几乎不重叠,使这条界在无线里恒等于 1。
- 实测数据说,同类场景 \(\Gamma\approx0\)、跨类场景崩塌。理论必须能分辨这两种情形。
4.2 误配的信息论原型:GMI 与 Lapidoth 定理#
直觉
接收机译码时手里拿着一把尺子:"收到 \(y\),发的是 \(x\) 的可能性有多大"。这把尺子本该是真实信道律 \(p(y\mid x)\),但真实的律没人知道。接收机用的是估计出来的、简化过的、或从别的环境学来的代理律 \(q(y\mid x)\)。
用错尺子会怎样?1990 年代的信息论把这个问题彻底形式化了,名字叫失配译码(mismatched decoding)。它是本章全部问题的原型:模型是 \(q\),世界是 \(p\),代价多少。
4.2.1 定义:译码度量与 GMI#
码本按 \(p(x)\) 随机生成、接收机用对尺子(按真实 \(p(y\mid x)\) 做最大似然译码)时,可靠传输的速率可以一直做到互信息 \(I(X;Y)\)。尺子换成 \(q\) 以后,这个速率一般达不到。
我们需要一个量回答:码本照常随机生成、译码器固定用 \(q\),速率低于多少时错误概率仍能趋于零?下面的 GMI 给出一个这样的速率:低于它就一定可靠。
定义 4.1(失配译码与广义互信息 GMI)【已解决(经典)】
离散无记忆信道 \(p(y\mid x)\),输入分布 \(p(x)\)。一个译码度量(decoding metric)是任意非负函数 \(q(y\mid x)\);\(q\)-译码器收到 \(y^n\) 后输出使 \(\prod_{i=1}^{n}q(y_i\mid x_i)\) 最大的码字(\(q=p\) 时就是最大似然译码)。对 \(s>0\) 定义
期望对真实联合分布 \(p(x)p(y\mid x)\) 取。\(\mathrm{GMI}\) 叫广义互信息(generalized mutual information)。出处:GMI 的定义与可达性是失配译码的标准结果,权威综述见 Scarlett 等 2020 [11]。
记号解释
- 分子 \(q(Y\mid X)^s\) 是"尺子给真码字打的分"。
- 分母 \(\sum_{x'}p(x')q(Y\mid x')^s\) 是"尺子给一个随机抽出的假码字打的平均分"。
- \(\log\) 里的比值大,说明真码字在尺子上明显赢过假码字。
- 指数 \(s\) 是一个自由参数。把度量整体取 \(s\) 次幂不改变译码器(\(\arg\max\) 对单调变换不变),所以对 \(s\) 取上确界是合法的。
为什么 GMI 是可达速率(四步草图)
随机码本有 \(2^{nR}\) 个码字,每个按 \(p(x)\) 独立生成。
**第一步:用并界把错误概率拆成假码字之和。**发送 \(x^n\)、收到 \(y^n\),错误当且仅当某个假码字 \(x'^n\) 的度量不低于真码字的:
其中 \(X'^n\) 按 \(p(x)\) 独立抽(与一切无关)。
这一步只用了"码本是随机生成的"。
**第二步:用 Markov 不等式。**对任何 \(s>0\),事件 \(\{A\ge B\}\) 与 \(\{A^s/B^s\ge1\}\) 相同,而非负随机变量超过 1 的概率不超过它的期望:
这一步把"假码字赢"的概率变成了一个可以逐符号相乘的量。
拆成乘积的依据有三点:
- Markov 不等式给出的是 \(\mathbb{E}\bigl[\prod_iq(y_i\mid X'_i)^s\bigr]\big/\prod_iq(y_i\mid x_i)^s\)。
- 分母在给定 \(x^n,y^n\) 时是常数,直接提到期望外。
- 分子里各 \(X'_i\) 相互独立,乘积的期望等于期望的乘积,第 \(i\) 个因子的期望就是 \(\sum_{x'}p(x')q(y_i\mid x')^s\)。
**第三步:用大数定律。**取对数并除以 \(n\),得到
它是 \(n\) 个独立同分布项的平均,按大数定律收敛到它的期望 \(I_{\mathrm{GMI}}(s)\)。
第二步右端恰好是 \(\exp\bigl(-\sum_i\log\frac{q(y_i\mid x_i)^s}{\sum_{x'}p(x')q(y_i\mid x')^s}\bigr)\)(对数取自然对数)。指数里是 \(-n\) 乘这个平均,于是第二步右端 \(\approx e^{-nI_{\mathrm{GMI}}(s)}\)。
**第四步:合并。**错误概率 \(\lesssim2^{nR}e^{-nI_{\mathrm{GMI}}(s)}\)。把底数统一:\(2^{nR}=e^{nR\ln2}\),上式 \(=e^{-n(I_{\mathrm{GMI}}(s)-R\ln2)}\to0\),只要 \(R\ln2<I_{\mathrm{GMI}}(s)\),即把 \(R\) 也换算成 nat 后 \(R<I_{\mathrm{GMI}}(s)\)。
对 \(s\) 取上确界即得 \(\mathrm{GMI}\) 可达。严格版本(处理 \(\min\{1,\cdot\}\) 与典型性)见 [11] 第 2 章。\(\square\)
4.2.2 定理 4.1:最近邻译码的两面#
现在看失配译码里最著名、也最"无线"的一个例子。接收机假定噪声是高斯的,于是用最近邻译码(nearest-neighbor decoding:选与 \(y^n\) 欧氏距离最近的码字)。真实噪声不是高斯的,会怎样?
定理 4.1(Lapidoth 1996:最近邻译码与高斯最坏噪声)【已解决】
加性噪声信道 \(Y=X+Z\),噪声 \(Z\) 与输入独立、零均值、方差 \(N\)(据 Scarlett–Tan–Durisi 对 Lapidoth 原文的转述,噪声过程只需平稳遍历、不必 i.i.d.【二手已核:原文 [2] 付费未取得】);功率约束 \(\mathbb{E}X^2\le P\)。固定架构:码本 i.i.d. \(\mathcal{N}(0,P)\),译码器最近邻。则
(a) 速率 \(\tfrac12\log\bigl(1+P/N\bigr)\) 可达,与噪声分布无关,只依赖噪声功率 \(N\);
(b) 在此架构下不能达到更高的速率;
(c) 噪声为高斯时 \(\tfrac12\log(1+P/N)\) 恰是信道容量;噪声非高斯时真实容量 \(C\ge\tfrac12\log(1+P/N)\),差额即失配代价。因此高斯是这一架构的最坏噪声。
出处:Lapidoth, IEEE Trans. IT 1996 [2]。
量词范围务必读清:(a)(b) 是对"给定架构"说的,不是对容量说的。它不说"容量与噪声分布无关",它说"用高斯尺子量任何噪声都恰好得到高斯的答案"。
证明(GMI 计算完整;可达性引理用上面的四步草图,converse (b) 引 [2])
**第一步:最近邻译码是一族 \(q\)-译码器。**最小化 \(\sum_i(y_i-x_i)^2\) 等价于最大化 \(\prod_i e^{-s(y_i-x_i)^2}\),对任何 \(s>0\) 都成立。所以最近邻译码就是度量 \(q(y\mid x)=e^{-(y-x)^2}\) 的 \(q\)-译码器,而定义 4.1 里对 \(s\) 取上确界恰好遍历这一族。
这一步说明为什么定理里会冒出一个待优化的 \(s\)。
第二步:算分子的期望。\(Y-X=Z\),故
只用了噪声的方差。
**第三步:算分母,这是一个高斯积分。**分母是对独立的 \(X'\sim\mathcal{N}(0,P)\) 求期望:
配方:记 \(A:=\frac1{2P}+s=\frac{1+2sP}{2P}\),则指数为
其中最后一步用 \(\frac{s^2}{A}-s=s\bigl(\frac{2sP}{1+2sP}-1\bigr)=-\frac{s}{1+2sP}\)。高斯积分 \(\int e^{-A(x-m)^2}\mathrm{d}x=\sqrt{\pi/A}\),故
这一步是全证明唯一的计算量,用的只是"把平方项配成完全平方"。
取对数再对 \(Y\) 求期望,用 \(\mathbb{E}Y^2=\mathbb{E}X^2+2\mathbb{E}[XZ]+\mathbb{E}Z^2=P+0+N\)(独立、零均值):
第四步:拼出 \(I_{\mathrm{GMI}}(s)\) 并对 \(s\) 求最大。
对 \(s\) 求导,得 \(\frac{P}{1+2sP}+\frac{P+N}{(1+2sP)^2}-N\)。令 \(u:=1+2sP\),导数为零即 \(Nu^2-Pu-(P+N)=0\)。判别式是 \(P^2+4N(P+N)=(P+2N)^2\),正根 \(u=\frac{P+(P+2N)}{2N}=\frac{P+N}{N}\),即
\(s\to0^+\) 时 \(I_{\mathrm{GMI}}\to0\),\(s\to\infty\) 时 \(\to-\infty\),驻点唯一,所以它是最大值。代回:
整个计算只用了 \(\mathbb{E}Z=0\) 与 \(\mathbb{E}Z^2=N\),(a) 得证。(c):高斯噪声时这是容量(预备篇 4);一般噪声的容量 \(\ge\) 任何架构的可达速率。\(\blacksquare\)
物理意义
这条定理有两面,两面都是本章要用的。
- 好的一面(为什么能迁移):一个为高斯噪声设计的接收机,扔进任何噪声里,只要功率对了,就得到设计时承诺的速率。系统对噪声的分布形状天然不敏感,只对二阶矩敏感。这就是"AI 空口为什么能迁移"的信息论原型:如果模型只通过某几个统计量看世界,世界在别的维度上怎么变都不影响它。
- 坏的一面(迁移的代价):非高斯噪声的真实容量更高,而这套架构永远拿不到多出来的部分。用错模型不会崩,但会稳定地少拿一截。
下面把这一截算成数。
行为分析
- 代价由 (c) 的差额 \(C-\tfrac12\log(1+P/N)\) 给出,它由噪声的熵功率决定(算例 4.1)。
- 架构的三个限定(高斯码本、最近邻、独立噪声)缺一不可。换成为真实噪声匹配的译码器,损失归零。噪声若与输入相关,第三步的 \(\mathbb{E}[XZ]=0\) 失效。
- \(s^\star=1/(2N)\) 有直观读法:最优的"尺子刻度"就是噪声方差的倒数。尺子刻度选错(\(s\ne s^\star\))会额外损失,但译码器本身不变,只是 GMI 的计算取了非最优的 \(s\)。
算例 4.1(拉普拉斯噪声的失配代价:熵功率相减)【本站演算】
真实噪声是拉普拉斯分布(尖峰厚尾,脉冲干扰的常用模型),方差 \(N=\sigma^2\);接收机按高斯设计(最近邻译码)。
**第一步:两个微分熵。**拉普拉斯密度是 \(\frac{1}{2b}e^{-|z|/b}\),方差 \(2b^2=\sigma^2\),故 \(b=\sigma/\sqrt2\)。
微分熵是 \(h_{\mathrm{L}}=\mathbb{E}\bigl[\ln(2b)+|Z|/b\bigr]=\ln(2b)+1=\ln(2be)=\ln(\sqrt2\,e\,\sigma)\) nat。这里对 \(-\ln\) 密度取期望,并用 \(\mathbb{E}|Z|=b\):\(|Z|\) 服从均值为 \(b\) 的指数分布。
高斯的微分熵是 \(h_{\mathrm{G}}=\tfrac12\ln(2\pi e\sigma^2)=\ln(\sigma\sqrt{2\pi e})\) nat。两者相减:
**第二步:熵功率。**熵功率 \(N_e:=e^{2h}/(2\pi e)\) 是"与该噪声同熵的高斯噪声的方差"。拉普拉斯:\(N_e=\sigma^2e^{2(h_{\mathrm{L}}-h_{\mathrm{G}})}=\sigma^2e^{-2\times0.0724}=\sigma^2\cdot\frac{e}{\pi}=0.865\,\sigma^2\)。
第三步:真实容量的下界。要用的工具是熵功率不等式(entropy power inequality, EPI):独立的 \(X\)、\(Z\) 相加,\(e^{2h(X+Z)}\ge e^{2h(X)}+e^{2h(Z)}\)。两边除以 \(2\pi e\),就是"和的熵功率不小于熵功率之和",两者都是高斯时取等。它给非高斯的 \(h(Y)\) 一个只依赖两个熵的下界。
输入取高斯 \(\mathcal{N}(0,P)\)(熵功率就是 \(P\)),熵功率不等式给 \(e^{2h(Y)}\ge e^{2h(X)}+e^{2h(Z)}=2\pi e(P+N_e)\),故
第四步:失配代价。
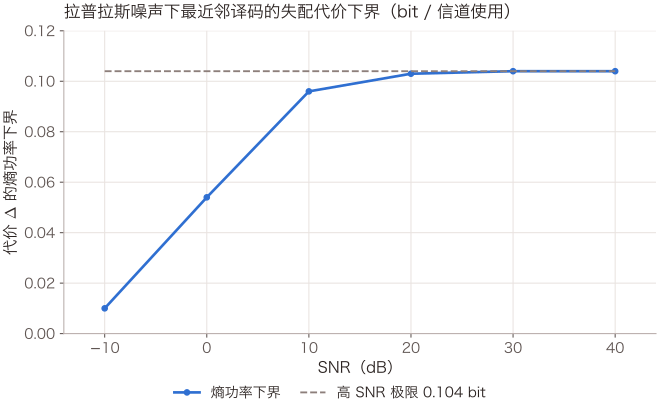
低 SNR 时 \(\Delta\to0\)(\(\log(1+x)\approx x\),两项之差 \(\propto P\))。中间的数值:SNR \(=-10,0,10,20,30\) dB 时下界依次为 \(0.010,\ 0.054,\ 0.096,\ 0.103,\ 0.104\) bit。
校验
- (a) 两条路径同一个数:\(0.0724\) nat \(/\ln2=0.1044\) bit,与 \(\tfrac12\log_2(\pi/e)=\tfrac12\times0.2088=0.1044\) 一致 ✓。
- (b) 数值积分真实互信息(高斯输入 + 拉普拉斯噪声,本站数值积分):SNR \(=10\) dB 时 \(I=1.834\) bit,而 \(\tfrac12\log_2 11=1.730\),实际差 \(0.104\) bit,已达到高 SNR 极限值,且不小于同 SNR 的下界 \(0.096\) ✓。20 dB 时 \(I=3.434\) 对 \(3.329\),差仍为 \(0.104\) ✓。
- (c) Lapidoth 不变性的蒙特卡洛验证:拉普拉斯噪声、SNR \(=10\) dB、\(2\times10^{6}\) 样本,按第三步闭式算 \(I_{\mathrm{GMI}}(s^\star)=1.732\) bit,与 \(\tfrac12\log_2 11=1.730\) 相符。最近邻译码在拉普拉斯噪声下确实只拿到高斯的速率 ✓。
- (d) 极限退化:噪声为高斯时 \(N_e=N\),\(\Delta\ge0\) 且 (c) 给等号 ✓。
产权
推导手法(熵功率不等式 + 高斯最坏噪声)是教科书标准的;\(0.104\) bit 这个具体数字在本站检索的文献里未见直接给出,标【本站演算】。
怎么读这张图
- 下方曲线是算例 4.1 第四步的下界 \(\tfrac12\log_2\frac{1+P/N_e}{1+P/N}\)(\(N_e/N=e/\pi\)),上方水平线是它的高 SNR 极限 \(0.104\) bit。
- 低 SNR 时用错模型几乎免费,SNR 超过 20 dB 后代价饱和在十分之一比特。误配代价非零、有界、可算,这是本章对"模型错了"的第一个定量画像。
- 数值积分显示真实代价在 10 dB 已达 0.104,即下界在中等 SNR 略松。
4.2.3 引理 4.2:用错尺子只会少不会多#
引理 4.2(GMI 不超过互信息)【已解决(经典)·本站给完整证明】
对任意译码度量 \(q\) 与任意 \(s>0\),\(I_{\mathrm{GMI}}(s)\le I(X;Y)\);从而 \(\mathrm{GMI}(q)\le I(X;Y)\),等号当 \(q(y\mid x)^s\) 与 \(p(y\mid x)\) 只差一个仅依赖 \(y\) 的因子时取到(特别地 \(q=p\) 时)。
证明
**第一步:把 GMI 写成"\(q\) 诱导的后验"。**定义
它对每个 \(y\) 是 \(x\) 上的一个概率分布(分子非负、分母是分子之和)。于是 \(\frac{q(Y\mid X)^s}{\sum_{x'}p(x')q(Y\mid x')^s}=\frac{r_s(X\mid Y)}{p(X)}\),即
这一步说:GMI 就是"接收机以为的后验"对先验的平均对数比。
**第二步:互信息也这样写。**真实后验 \(p(x\mid y)=p(x)p(y\mid x)/p(y)\),故 \(I(X;Y)=\mathbb{E}\log\frac{p(X\mid Y)}{p(X)}\)。
第三步:相减得到一个 KL 散度。
最后一步是 KL 散度非负(预备篇 4)。等号当且仅当对几乎每个 \(y\) 有 \(r_s(\cdot\mid y)=p(\cdot\mid y)\),即 \(q(y\mid x)^s\propto p(y\mid x)\)(比例常数可依赖 \(y\))。\(\blacksquare\)
物理意义
\(I-\mathrm{GMI}\) 是真实后验与接收机以为的后验之间的平均 KL 散度。用错模型的速率损失,就是你以为的世界与真实世界之间的信念差距。这给了本章一个可以对任何"错模型"统一计价的货币。
4.2.4 定义 4.2:环境泛化损失#
有了货币,就能给"换城市"标价。把 §4.1 的环境类接进来:环境 \(e\) 下的信道律是 \(p_e(y\mid x)\),为 \(e\) 匹配的译码度量 \(q_e:=p_e\)(或从 \(e\) 的数据学出的代理)。把它拿到 \(e'\) 去用。
定义 4.2(环境泛化损失)【本站提法】
对环境对 \((e,e')\),定义
即在真实环境 \(e'\) 下,用为 \(e\) 准备的译码度量所损失的速率。由引理 4.2,\(\mathcal{L}\ge0\),且 \(\mathcal{L}(e\to e)=0\)。
产权
\(I\ge\mathrm{GMI}\) 与 GMI 本身是失配译码文献的经典内容 [11];把 \(I-\mathrm{GMI}\) 当作分布偏移 / 环境泛化的度量,据本站检索未见先例,标【本站提法】。它是第 1 章猜想 1.3 里误配半径 \(\rho\) 的第二个候选(GMI 型)。
定义之后立刻给数。算例 4.1 就是一个实例:\(e\) = "噪声为高斯",\(e'\) = "噪声为拉普拉斯、同方差",\(q_e\) = 最近邻,则 \(\mathcal{L}(e\to e')=C_{\mathrm{L}}-\tfrac12\log(1+P/N)\ge0.104\) bit(高 SNR)。再给一个二元的、能手算的:
算例 4.2(BSC 上的环境泛化损失:从 0 到全部)
真实环境 \(e'\):BSC(0.1),等概输入,\(I(X;Y)=1-h(0.1)=1-0.469=0.531\) bit。二元 \(q\)-译码器的度量只由"读数与码字相同 / 不同"两个值决定,记 \(q(y\mid x)=1-q'\)(相同)或 \(q'\)(不同)。GMI 的闭式(等概输入):
情形一:接收机以为信道是 BSC(0.3)(\(q'=0.3\),第 1 章 §1.3 的"模型错了代价为零"例子)。
取 \(s\) 使 \((0.7/0.3)^s=0.9/0.1=9\),即 \(s^\star=\ln9/\ln(7/3)=2.197/0.847=2.593\)。这样 \(q^s\) 与真实律 \(p\) 只差一个常数倍,正是引理 4.2 的取等条件,所以这个 \(s\) 必然是最优的。
此时 \(0.7^{s^\star}=0.3966\)、\(0.3^{s^\star}=0.0441\),\(D_{s^\star}=0.2203\):
\(\mathcal{L}(e\to e')=0.531-0.531=\mathbf{0}\):模型错了,一分不赔。
情形二:接收机以为信道是 BSC(0.9)(两根天线标号接反,第 1 章的另一个例子)。
\(q'=0.9\),对任何 \(s>0\),\(\log_2\frac{0.1^s}{D_s}<0\) 的项权重 0.9,\(\log_2\frac{0.9^s}{D_s}>0\) 的项权重 0.1。数值扫描 \(s\in(0,10]\) 全为负,\(s\to0^+\) 时趋于 0,故 \(\mathrm{GMI}=0\),\(\mathcal{L}(e\to e')=\mathbf{0.531}\) bit:全部损失。
校验
- (a) 情形一在 \(s^\star\) 处 \(q^{s^\star}\) 与 \(p\) 只差与 \(y\) 无关的常数(\(0.7^{s^\star}/0.9=0.3^{s^\star}/0.1=0.441\)),引理 4.2 的等号条件成立,所以 GMI 必须等于 \(I\),闭式给出的 \(0.531\) 与 \(1-h(0.1)\) 逐位一致 ✓。
- (b) 若不优化 \(s\)、硬取 \(s=1\),情形一给 \(0.9\log_2(0.7/0.5)+0.1\log_2(0.3/0.5)=0.437-0.074=0.363<0.531\),说明 \(\sup_s\) 不是装饰 ✓。
- (c) 情形二在 \(s=1\) 处:\(0.9\log_2(0.1/0.5)+0.1\log_2(0.9/0.5)=-2.090+0.085=-2.005\),确为负。GMI 作为上确界只能在 \(s\to0\) 处取 0 ✓。
- (d) 与第 1 章 §1.3 的判决错误率对照:情形一 MAP 判决不变、错误率 0.10;情形二错误率跳到 0.90。两种货币(速率损失 / 判决损失)给出同样的"零 / 全部"二分 ✓。
物理意义
算例 4.2 把第 1 章 那句"misspecification 不是单调的"变成了定义 4.2 下的两个数。
- 错模型可以一分不赔,当它与对的模型诱导同一个译码器。
- 错模型也可以赔光,当它把序颠倒。
环境泛化损失衡量的是模型诱导的决策差多少,不看模型参数差多少。这与引理 3.1(iii)"损失只通过它诱导的最优动作划分进入判据"是同一个精神。
4.2.5 无线的面孔:不完美 CSI#
失配译码在无线里更常见的样子,是信道系数错了,而不是噪声形状错了:接收机手上是估计 \(\hat h\),真信道是 \(h=\hat h+\tilde h\)。
Médard 型下界(不完美 CSI 下的可达速率;本章不编号的经典结果)【已解决(经典)】
衰落信道 \(Y=hX+Z\),\(Z\sim\mathcal{N}(0,N)\),接收机持有估计 \(\hat h\),估计误差 \(\tilde h=h-\hat h\) 与 \(\hat h\) 不相关、方差 \(\sigma_e^2\),输入 \(X\sim\mathcal{N}(0,P)\) 与 \((\hat h,\tilde h,Z)\) 独立。则
出处:
- Médard 2000 [3] 给出这类互信息损失的上下界。
- Hassibi–Hochwald 2003 [5] 用它优化训练长度。
- 最近邻译码版本见 Lapidoth–Shamai 2002 [4],其摘要给出的经验法则是"估计误差须相对 \(1/\mathrm{SNR}\) 可忽略"。
上式是 [5] 第 III 节下界(式 (13)–(15),用其定理 1 的"与信号不相关、给定方差的噪声中高斯最坏"论证)在单发单收、只看数据段时的特例:令 \(M=N=1\)、\(\rho_d=P/N\)、估计误差方差取 \(\sigma_e^2\) 即得。MIMO 导频辅助情形的行列式形式也见 [5]。
证明思路(与定理 4.1 同源)
把 \(Y=\hat hX+(\tilde hX+Z)\),有效噪声 \(\tilde hX+Z\) 给定 \(\hat h\) 时与 \(X\) 不相关(\(\mathbb{E}[\tilde hX\cdot X]=\mathbb{E}\tilde h\cdot\mathbb{E}X^2=0\)),方差 \(P\sigma_e^2+N\)。"与输入不相关、给定方差的噪声中高斯最坏"这条引理(Médard [3]、Hassibi–Hochwald [5] 定理 1)给出下界。
它与定理 4.1 是同一个思想的两次使用:接收机只信二阶矩。\(\square\)
算例 4.3(估计误差 \(-20\) dB 在高 SNR 下值多少)
取 \(|\hat h|^2=1\)、\(\sigma_e^2=0.01\)(估计误差 \(-20\) dB)、\(N=1\)。
- SNR \(=10\) dB(\(P=10\)):\(\log_2\bigl(1+\frac{10}{1+0.1}\bigr)=\log_2 10.09=3.335\) bit,完美 CSI \(\log_2 11=3.459\),损失 \(0.124\) bit。
- SNR \(=20\) dB(\(P=100\)):\(\log_2\bigl(1+\frac{100}{1+1}\bigr)=\log_2 51=5.672\),完美 CSI \(\log_2 101=6.658\),损失 \(0.986\) bit。
- SNR \(\to\infty\):\(\log_2\bigl(1+|\hat h|^2/\sigma_e^2\bigr)=\log_2 101=6.658\) bit,这是天花板。
校验
- (a) 极限:\(\sigma_e^2\to0\) 时下界退化为完美 CSI 的 \(\log_2(1+P|\hat h|^2/N)\) ✓。\(P\to\infty\) 时分母被 \(P\sigma_e^2\) 主导,速率饱和于 \(\log_2(1+|\hat h|^2/\sigma_e^2)\),与 Lapidoth–Shamai 的"SNR 天花板"定性一致 ✓。
- (b) 损失随 SNR 单调增长(\(0.124\to0.986\)),与第一部第 9 章的口径"小估计误差在高 SNR 下也造成不消失的速率损失"一致 ✓。
- (c) 临界 SNR:分母两项相等 \(P\sigma_e^2=N\) 处 \(P=100\),即 20 dB。这就是"误差方差须相对 \(1/\mathrm{SNR}\) 可忽略"的量化位置 ✓。
物理意义
分母里那一项 \(P\sigma_e^2\) 是"模型错一点"的价签:估计误差被发射功率放大后,与热噪声并列。
SNR 越高,模型错误的相对权重越大。误配的代价随你对模型的依赖程度增长,这是本章后面反复出现的主题。
4.2.6 悬案:一般失配容量#
失配译码有一个 1995 年提出、至今未解的核心问题。
Csiszár–Narayan 1995 [1] 定义了给定度量 \(d\) 的 \(d\)-容量(对一切码本、\(d\)-译码器的最大可靠速率),并猜想随机编码下界的乘积空间改进(多字母极限)等于失配容量(CN 猜想)。这里的度量 \(d\) 与定义 4.1 的 \(q\) 扮演同一角色,只是原文记号不同。
多字母(multi-letter)指公式要对 \(n\) 个符号的整块输入分布做优化再令 \(n\to\infty\),不像 \(C=\max_{p(x)}I(X;Y)\) 那样只对单个符号优化,所以一般难以计算。
Somekh-Baruch 2015 [8] 给出一大类阈值型译码器失配容量的一般公式,但是多字母的,即使 DMC 也不易化简。
2026 年 Molina–Guillén i Fàbregas [18]【预印本·未评审】证明 CN 猜想对随机似然译码器成立。这种译码器不取度量最大的码字,而按各码字的度量值成比例地随机抽一个。同时论文明确写道:DMC 加最大度量译码的一般失配容量仍然开放。
这对本章的含义很直接。定义 4.2 的 \(\mathcal{L}(e\to e')\) 用的是 GMI,是"固定架构、固定译码器"的可达速率损失,而不是"最优编码下的失配容量损失"。前者可算,后者未知。本章只承诺前者。
到此为止我们得到了什么
一种货币和一个原型。
- 失配译码把"模型错了"计价为 \(I-\mathrm{GMI}\),它等于真实后验与错误后验的平均 KL 散度(引理 4.2)。
- Lapidoth 定理给出这种代价的最小非零样本:高斯尺子量拉普拉斯噪声,高 SNR 下少 0.104 bit。系统对分布形状不敏感,只对二阶矩敏感。
- 定义 4.2 把它推广成环境泛化损失 \(\mathcal{L}(e\to e')\),二元算例显示它可以是 0 也可以是全部。
- 但这一切都要求把"环境"写成信道律 \(p_e(y\mid x)\)。对训练出来的模型,这一步不存在,要换工具。
4.3 学习论为什么空洞:Ben-David 界与 CSI 指纹#
直觉
换一门语言。机器学习把"换城市"叫域适应(domain adaptation):源域 \(D_S\) 上训练,目标域 \(D_T\) 上测试。它不假设信道律,只假设"有一个假设类 \(\mathcal{H}\),模型从里面挑"。
2010 年 Ben-David 等人的定理是这门语言里最有名的界。本节把它的证明一步不跳地写出来,然后指出它在物理层为什么恒等于"目标误差 \(\le\) 源误差 \(+1\)"。
4.3.1 设定与 \(\mathcal{H}\Delta\mathcal{H}\) 距离#
二分类:输入 \(x\),标签由标注函数 \(f_S,f_T:\mathcal{X}\to\{0,1\}\) 给出(源与目标的标注可以不同)。假设类 \(\mathcal{H}\subseteq\{0,1\}^{\mathcal{X}}\)。对 \(h\in\mathcal{H}\):
- 源误差 \(\epsilon_S(h):=\Pr_{x\sim D_S}[h(x)\ne f_S(x)]\),目标误差 \(\epsilon_T(h)\) 同理。
- 两个假设的分歧 \(\epsilon_S(h,h'):=\Pr_{x\sim D_S}[h(x)\ne h'(x)]\)。
定义 4.3(对称差假设类与 \(\mathcal{H}\Delta\mathcal{H}\) 距离)【已解决(经典)】
\(\mathcal{H}\Delta\mathcal{H}:=\{h\oplus h':h,h'\in\mathcal{H}\}\)(\(\oplus\) 为异或,即"两个假设不一致的地方")。对 \(g\in\mathcal{H}\Delta\mathcal{H}\) 记 \(I(g):=\{x:g(x)=1\}\)。
出处:Ben-David 等 2010 [7];按综述 Redko 等 2020 [12] 的编号为 Definition 11。
约定:前置因子 2 使定理里出现 \(\tfrac12d_{\mathcal{H}\Delta\mathcal{H}}\)。有些文献不带 2,此时定理写成 \(\epsilon_S+d+\lambda\)。本章全程带 2。
记号解释
\(d_{\mathcal{H}\Delta\mathcal{H}}\) 问的是:用两个假设的"不一致区域"作为探针,源与目标在这些区域上的概率最多差多少。
它是总变差的"假设类限制版"。总变差对一切集合取上确界,它只对 \(\mathcal{H}\Delta\mathcal{H}\) 能画出的集合取。所以永远有 \(\tfrac12d_{\mathcal{H}\Delta\mathcal{H}}\le\|D_S-D_T\|_{\mathrm{TV}}\)。
先算一个
输入 \(x\in\{1,2,3,4\}\),\(\mathcal{H}=\{\mathbf{1}[x>t]:t=0,1,2,3,4\}\)(五个阈值分类器,含两个常值)。两个阈值的异或是一个区间 \(\{a+1,\dots,b\}\),所以 \(\mathcal{H}\Delta\mathcal{H}\) 能画的集合就是全部区间。
源 \(D_S\) 均匀于 \(\{1,2,3\}\),目标 \(D_T\) 均匀于 \(\{2,3,4\}\)。逐区间算 \(|\Pr_S-\Pr_T|\):
- \(\{1\}\) 给 \(|1/3-0|=1/3\)。
- \(\{1,2\}\) 给 \(|2/3-1/3|=1/3\)。
- \(\{1,2,3\}\) 给 \(|1-2/3|=1/3\)。
- \(\{4\}\) 给 \(1/3\)。
- \(\{2,3\}\) 给 0。
上确界 \(1/3\),故 \(d_{\mathcal{H}\Delta\mathcal{H}}=2/3\)。
4.3.2 定理 4.3 与四步证明#
定理 4.3(Ben-David 等 2010)【已解决】
对任意 \(h\in\mathcal{H}\),
出处:Ben-David 等 2010 [7](Redko 等 [12] 编号 Theorem 10)。有限样本版本在右端再加 \(O\bigl(\sqrt{\mathrm{VC}(\mathcal{H})\log m'/m'}\bigr)\),本章只用总体版本。这里 \(m'\) 是估计 \(d_{\mathcal{H}\Delta\mathcal{H}}\) 所用的无标签样本数,\(\mathrm{VC}(\mathcal{H})\) 是假设类的 VC 维,即 \(\mathcal{H}\) 最多能把多少个点按任意方式分成两类,越大说明假设类越灵活。
记号提醒:这里的 \(\lambda\) 是“理想联合假设在两域上的误差之和”,不是本章导言与 §4.4 起表示波长的 \(\lambda\)。本章只在 §4.3(定理 4.3、算例 4.4 及其后的讨论)与命题 4.6 的物理意义里这样用。
证明(四步)
记 \(h^\ast\) 为 \(\lambda\) 的最小化者(理想联合假设)。
**第一步:目标域上的三角不等式。**逐点有 \(\mathbf{1}[h\ne f_T]\le\mathbf{1}[h^\ast\ne f_T]+\mathbf{1}[h\ne h^\ast]\):若 \(h(x)\ne f_T(x)\),则要么 \(h^\ast(x)\ne f_T(x)\),要么 \(h^\ast(x)=f_T(x)\ne h(x)\)。对 \(D_T\) 取期望:
这一步把"\(h\) 在目标上的错"拆成"理想假设的错"加"\(h\) 与理想假设的分歧"。
第二步:把分歧从目标域搬到源域。\(\epsilon_T(h,h^\ast)=\Pr_{D_T}(I(h\oplus h^\ast))\),而 \(h\oplus h^\ast\in\mathcal{H}\Delta\mathcal{H}\)。于是
这一步是全证明的核心:分歧是一个 \(\mathcal{H}\Delta\mathcal{H}\) 集合的概率,两域在这类集合上的概率差被 \(d_{\mathcal{H}\Delta\mathcal{H}}\) 一次性控制。
**第三步:源域上的三角不等式。**同第一步的逐点论证,\(\mathbf{1}[h\ne h^\ast]\le\mathbf{1}[h\ne f_S]+\mathbf{1}[h^\ast\ne f_S]\),故
**第四步:合并。**三步串起来:
算例 4.4(阈值分类器上的 Ben-David 界:取等与空洞)
沿用上面的四点例子(\(d_{\mathcal{H}\Delta\mathcal{H}}=2/3\))。真实标注两域相同:\(f(x)=\mathbf{1}[x\ge3]\)。
\(\lambda\)。\(h^\ast=\mathbf{1}[x>2]\) 在两域都零错,\(\lambda=0\)。
**一个取等的 \(h\)。**常值假设 \(h_0\equiv0\)(\(t=4\)):\(\epsilon_S(h_0)=\Pr_S\{x\ge3\}=1/3\),\(\epsilon_T(h_0)=\Pr_T\{x\ge3\}=2/3\)。定理给 \(\epsilon_T\le1/3+1/3+0=2/3\),恰好取等。
一个松的 \(h\)。\(h=\mathbf{1}[x>1]\):\(\epsilon_S=\Pr_S\{x=2\}=1/3\),\(\epsilon_T=\Pr_T\{x=2\}=1/3\),定理给 \(1/3\le2/3\),松了 \(1/3\)。
空洞的情形。把两域换成不重叠的:\(D_S\) 均匀于 \(\{1,2\}\),\(D_T\) 均匀于 \(\{3,4\}\)。区间 \(\{1,2\}\) 给 \(|\Pr_S-\Pr_T|=|1-0|=1\),\(d_{\mathcal{H}\Delta\mathcal{H}}=2\),定理化为 \(\epsilon_T\le\epsilon_S+1+\lambda\)。由于 \(\epsilon_T\le1\) 本来就成立,这条界不再包含任何信息。
校验
- (a) 四步证明的每一步在取等例子里都取等:
- 第一步 \(\epsilon_T(h_0)=2/3=0+\epsilon_T(h_0,h^\ast)\)(\(h_0\) 与 \(h^\ast\) 恰在 \(\{3,4\}\) 上不一致,\(\Pr_T=2/3\))✓。
- 第二步 \(\epsilon_S(h_0,h^\ast)=\Pr_S\{3,4\}=1/3\),差 \(1/3=\tfrac12d\) ✓。
- 第三步 \(1/3\le1/3+0\) ✓。
- (b) \(\tfrac12d_{\mathcal{H}\Delta\mathcal{H}}\le\mathrm{TV}\):重叠例子里 \(\mathrm{TV}=\tfrac12(1/3+1/3)=1/3\),等于 \(\tfrac12d\);不重叠例子里两者都是 1 ✓。
- (c) 极限:\(D_S=D_T\) 时任何区间概率差为 0,\(d=0\),界退化为 \(\epsilon_T\le\epsilon_S+\lambda\),而 \(\lambda\le2\min\epsilon\),这是单域学习的平凡陈述 ✓。
物理意义
定理 4.3 说:目标误差 = 源误差 + "两域在假设类眼里有多不同" + "有没有一个假设能同时服务两域"。
第二项是可以从无标签数据估计的:训练一个分类器区分源样本与目标样本,其最优精度就给出 \(d_{\mathcal{H}\Delta\mathcal{H}}\) 的估计。这就是它在机器学习里流行的原因。
行为分析
- Mansour–Mohri–Rostamizadeh 2009 [6] 把它推广到一般损失:discrepancy 距离 \(\mathrm{disc}_\ell(D_S,D_T):=\sup_{h,h'\in\mathcal{H}}|\mathbb{E}_{D_S}\ell(h',h)-\mathbb{E}_{D_T}\ell(h',h)|\),0-1 损失下与 \(\tfrac12d_{\mathcal{H}\Delta\mathcal{H}}\) 重合。CSI 重建(NMSE 损失)这类回归任务必须用它,不能用定理 4.3。
- 两个探针的差别:TV 用一切集合探测,\(\mathcal{H}\Delta\mathcal{H}\) 只用假设类能画的集合,所以后者更紧。但假设类越强,两者越接近,而深度网络几乎能画任何集合。
- \(\lambda\) 是不可消除项:若两域的标注函数本身冲突(同一个 CSI 在两个环境里对应不同的最优波束),任何单一假设都不能同时服务两域。
4.3.3 空洞的原因:CSI 指纹恰恰证明两域可分#
现在把定理 4.3 放到无线上。源域:UMa 场景的 CSI;目标域:InH 场景的 CSI。假设类:一个深度网络。要估计 \(d_{\mathcal{H}\Delta\mathcal{H}}\),就得问:能不能训练一个网络,看一眼 CSI 就说出它来自哪个场景?
答案是不但能,而且这件事本身是一个成熟的产业。第一部第 6 章与第 7 章讨论的 CSI 指纹定位(fingerprinting localization)就是它:同一个房间里相距几个波长的两个位置,CSI 已经可以被分类器区分。
第一部第 8 章的预测半径 \(r_{\max}\approx1.5\) m \(\approx17\lambda\) 说的是,超过这个距离 CSI 就无法从邻近样本预测,更不用说两个完全不同的场景。
2026 年 Li 等的 learnware 工作 [16]【预印本·未评审】用"码本指纹频率向量"做统计规格,来检索该用哪个场景的模型。learnware("学件")是指模型库里每个模型都附一份概括其训练数据分布的统计描述,部署时拿目标数据与这些描述比对来挑模型。这种检索的可行性,本身就是"不同场景的 CSI 分布高度可分"的工程证据。
为什么"分类器能区分"就推出距离取满?
设分类器 \(c(x)=1\) 表示判"来自源域",它在源样本上判对的比例为 \(a_S=\Pr_S\{c=1\}\),在目标样本上判对的比例为 \(a_T=\Pr_T\{c=0\}\)。深度网络的假设类足够大,可以认为 \(\mathcal{H}\) 同时含 \(c\) 与常值假设 \(0\),于是 \(c=c\oplus0\in\mathcal{H}\Delta\mathcal{H}\),而 \(I(c)\) 就是"判为源域"的区域:
\(\bar{a}\) 是两域样本各占一半时的分类精度,所以 \(d_{\mathcal{H}\Delta\mathcal{H}}\ge2(2\bar{a}-1)\):精度 \(0.99\) 就给 \(d_{\mathcal{H}\Delta\mathcal{H}}\ge1.96\)。这也是上文"用区分源与目标的分类精度估计 \(d_{\mathcal{H}\Delta\mathcal{H}}\)"的具体算法。
CSI 指纹的分类精度接近 1,于是 \(\sup_{g\in\mathcal{H}\Delta\mathcal{H}}|\Pr_S(I(g))-\Pr_T(I(g))|\approx1\),\(d_{\mathcal{H}\Delta\mathcal{H}}\approx2\),定理 4.3 化为
这条界按构造空洞:右端至少是 1,而任何误差本来就不超过 1,它排除不了任何情形。这个距离在无线里本来就等于它的最大值,与估计得准不准无关。
陷阱与产权:“可分 ⇒ 空洞”不是本站发现
"域适应界在高维可分数据上饱和"是 DA 文献里公开的批评。它正是 discrepancy 型界 [6]、Wasserstein 型界与 Zhao 等 2019 [9] 不可能性结果的动机,Redko 等的综述 [12] 有系统讨论。
本站在此让权。本站原创的只有两件事:
- (甲)物理归因:CSI 可分的根源是反射径相位在 \(\lambda/4\) 尺度上翻转(§4.4),所以任何两个不同环境的 CSI 在相位上必然可分。
- (乙)尺度:由此得到 \(\lambda/4\) 与 \(L\) 两个泛化半径(§4.6)。
还有一条更硬的负面结果必须写进来。先交代记号:
- 在 \(X\to Z\to\hat Y\) 的表示学习框架里,编码器 \(g\) 把输入 \(X\) 映成表示 \(Z\),分类头 \(h\) 再由 \(Z\) 给出预测 \(\hat Y\)。这里的 \(g\) 与 §4.1 的 \(g=\ell\circ f\) 无关。
- \(D^Y\)、\(D^Z\) 分别是标签与表示的分布。
- Jensen–Shannon 散度 \(D_{\mathrm{JS}}(P,Q):=\tfrac12D(P\|M)+\tfrac12D(Q\|M)\),\(M:=\tfrac12(P+Q)\),是对称化、有界的 KL 散度:两分布相同时为 0,不重叠时取最大值 \(\ln2\)。
Zhao 等 2019 [9] 定理 4.3(原文编号,与本章定理 4.3 无关):在这一框架下,若标签边缘分布的偏移大于表示的偏移,即 \(d_{\mathrm{JS}}(D_S^Y,D_T^Y)\ge d_{\mathrm{JS}}(D_S^Z,D_T^Z)\)(\(d_{\mathrm{JS}}:=\sqrt{D_{\mathrm{JS}}}\)),则
无线读法:波束索引的边缘分布在 UMa 与 InH 之间显然不同(室内几乎没有远距离低仰角波束),把表示做成域不变会推高目标误差。"学一个跨场景通用表示"这条路线有下界挡着。这与 [16] 报告的"通用模型出现 negative transfer、场景专用小模型一致更优"互相印证【预印本·未评审】。
为什么与物理无关的距离在物理层注定无用
TV、\(\mathcal{H}\Delta\mathcal{H}\)、JS 都是"重叠型"距离:它们衡量两个分布有多少质量落在同一处,不衡量不重叠的质量隔了多远。
而 Maxwell 方程给出的偏移是位移型的:墙挪了 2 毫米,每个 CSI 样本都动了一点点,但没有一个样本还落在原处。重叠型距离对"每个样本动一点"与"每个样本换到另一个星球"一视同仁。
要想让理论分辨 §4.1 那条陡坡的两端,度量必须是位移型的。这就是 §4.5 要引入 \(W_1\) 的全部理由。而在此之前,先要知道"墙挪了 2 毫米"到底让信道动了多少。
到此为止我们得到了什么
一条完整证明的界和一个诊断。
- Ben-David 界的四步证明只用了两次三角不等式加一次"分歧是 \(\mathcal{H}\Delta\mathcal{H}\) 集合的概率"。
- 它在无线里空洞,因为 CSI 指纹定位已经证明不同环境的 CSI 几乎完美可分,\(d_{\mathcal{H}\Delta\mathcal{H}}\approx2\)。
- 文献早知"可分 \(\Rightarrow\) 空洞",本站补的是物理归因与尺度。
- 重叠型距离看不见位移,而 Maxwell 给出的偏移正是位移。
4.4 让 Maxwell 说话:两径像法的灵敏度表#
直觉
你站在一面镜子前,镜子往后挪 1 毫米,镜中的你就往后挪 2 毫米。无线里"镜子"是墙,"镜中的你"是发射机的像(image)。墙挪 \(\delta\),像挪 \(2\delta\),从像到接收机的那条反射径就变长。变长多少,决定了信道的每一个特征变多少。
这一节把四种特征(相位、时延、到达角、幅度)对墙位移的灵敏度全部算出来。它们是标准教科书结果(像法两径模型,任何一本传播教材都有),本站只是把它们并排放到一张表里,并算出 3.5 GHz 与 28 GHz 的数字。
4.4.1 像法几何#
发射机 T、接收机 R、一面平墙。直射径长 \(r_0\)。反射径按像法等价于从像点 T′ 到 R 的直线,长 \(r_1\),与墙法向夹角 \(\theta\)(入射角)。墙沿法向外推 \(\delta\):像点沿法向外移 \(2\delta\),反射径长的变化是这段位移在径方向上的投影:
这是 \(\delta\) 远小于 \(r_1\) 时的一阶结果。\(\theta\) 是径与法向的夹角,垂直入射 \(\theta=0\) 时变化最大。
直射径不变。信道是两条径之和:
4.4.2 四种特征的灵敏度#
逐个对 \(\delta\) 求导(都是链式法则:先对 \(r_1\),再乘 \(\partial r_1/\partial\delta=2\cos\theta\)):
| 特征 | 与 \(r_1\) 的关系 | 对墙位移 \(\delta\) 的灵敏度 | 含 \(\lambda\) 吗 |
|---|---|---|---|
| 反射径相位 \(\phi_1=2\pi r_1/\lambda\) | 线性,斜率 \(2\pi/\lambda\) | \(\dfrac{\partial\phi_1}{\partial\delta}=\dfrac{4\pi\cos\theta}{\lambda}\) | 是,\(\propto1/\lambda\) |
| 反射径时延 \(\tau_1=r_1/c\) | 线性,斜率 \(1/c\) | \(\dfrac{\partial\tau_1}{\partial\delta}=\dfrac{2\cos\theta}{c}\) | 否 |
| 到达角 \(\vartheta_1\)(像点方向) | 像点横向位移 \(2\delta\sin\theta\) 除以距离 | \(\Bigl\vert\dfrac{\partial\vartheta_1}{\partial\delta}\Bigr\vert=\dfrac{2\sin\theta}{r_1}\le\dfrac{2}{r_1}\) | 否 |
| 相对幅度 \(\lvert a_1\rvert\) | \(\propto1/r_1\) | \(\Bigl\vert\dfrac{\partial\ln\lvert a_1\rvert}{\partial\delta}\Bigr\vert=\dfrac{2\cos\theta}{r_1}\le\dfrac{2}{r_1}\) | 否 |
这张表是本章的物理地基。四行里只有第一行含 \(\lambda\):相位是唯一随载频变尖的特征;其余三行由几何尺度(\(c\)、\(r_1\))决定,换频段不变。表中最后一列的"是 / 否"就是 §4.6 相位 / 结构二分的量纲论据。
算例 4.5(两径灵敏度表的数字:3.5 GHz 与 28 GHz)
取最坏入射角(相位、时延、幅度取 \(\cos\theta=1\),角度取 \(\sin\theta=1\)),\(r_1=20\) m。波长:\(\lambda_{3.5}=c/f=3\times10^{8}/3.5\times10^{9}=85.71\) mm,\(\lambda_{28}=10.71\) mm。
相位(\(\delta=2\) mm)。
2 毫米,在 3.5 GHz 上相位转了六分之一圈,在 28 GHz 上转了三分之一圈还多。
翻转相位所需的位移。\(\Delta\phi=\pi\) 时 \(4\pi\delta_\pi/\lambda=\pi\),即
时延(\(\delta=1\) cm)。\(\Delta\tau_1=2\times0.01/(3\times10^{8})=66.7\) ps。要分辨它需要带宽 \(B\gtrsim1/\Delta\tau_1=15\) GHz,任何蜂窝系统都分辨不出。
到达角(\(\delta=1\) cm)。\(\Delta\vartheta_1=2\times0.01/20=1\) mrad \(=0.057^\circ\)。64 元半波长 ULA 的主瓣宽约 \(0.886\times2/64\) rad \(=1.6^\circ\),该变化是波束宽度的 \(1/28\),不可分辨。
**幅度(\(\delta=1\) cm)。**相对变化 \(2\times0.01/20=0.1\%\),即 \(0.009\) dB,不可分辨。
校验
- (a) \(\delta=\lambda/4\) 代回 \(4\pi\delta/\lambda=4\pi\cdot\tfrac14=\pi\) ✓。\(\delta=2\) mm 时 \(\Delta\phi_{28}/\Delta\phi_{3.5}=2.35/0.293=8.0=28/3.5\),与 \(\propto1/\lambda\) 一致 ✓。
- (b) 时延与相位的一致性:\(\Delta\phi=2\pi f\Delta\tau\),3.5 GHz、\(\delta=1\) cm:\(2\pi\times3.5\times10^{9}\times66.7\times10^{-12}=1.467\) rad,与 \(4\pi\times0.01/0.08571=1.466\) 一致 ✓。
- (c) 量纲:相位灵敏度 \(4\pi/\lambda=146.7\) rad/m(3.5 GHz),乘 0.002 m 得 0.293 ✓。
- (d) 与第 3 章算例 3.5 对照:那里说"波束索引不在 \(\lambda\) 尺度上变化而在 \(L\) 尺度上变化",本表第三行给出定量理由。角度对厘米级位移只变约 \(1/28\) 个波束宽度(\(1\) mrad 对 \(27.7\) mrad)✓。
物理意义
同一个 2 毫米的墙位移,在相位上是一场地震(\(134^\circ\)),在时延、角度、幅度上什么都没发生。环境的微小变化只通过相位被信道看见。
这就是第一部第 2 章"\(\lambda/L\) 决定环境哪些细节被信道看见"在单个散射体上的样子:\(\lambda\) 尺度的细节进相位,\(L\) 尺度的细节进结构。
行为分析
- 两径只是最小模型。真实环境有几十条径,每条径的相位都按各自的 \(4\pi\cos\theta_p/\lambda\) 转,位移方向不同时符号也不同,合成后是一个高维旋转。但每一维的转速都是同一个量级 \(4\pi/\lambda\)。
- 绕射径的贡献按第一部第 2 章的口径低 \(\sqrt{\lambda/L}\) 量级,其相位灵敏度形式相同、幅度更小,不改变结论。
- 表中的 \(r_1=20\) m 是典型室外值。室内 \(r_1\sim5\) m 时角度与幅度灵敏度升高 4 倍,仍比相位低两个半数量级以上(3.5 GHz 约 \(370\) 倍,28 GHz 约 \(2900\) 倍)。
到此为止我们得到了什么
一张灵敏度表。
- 墙挪 \(\delta\),反射径相位变 \(4\pi\delta\cos\theta/\lambda\),时延变 \(2\delta\cos\theta/c\),角度与相对幅度各变 \(\lesssim2\delta/r_1\)。只有相位含 \(\lambda\)。
- 翻转相位只要 \(\lambda/4\):3.5 GHz 两厘米,28 GHz 不到三毫米。
- 同样的位移在时延、角度、幅度上低于任何蜂窝系统的分辨率。
4.5 物理 Lipschitz 风险界:命题 4.4#
有了"墙挪 \(\delta\) 信道动多少",就能把 §4.1 的泛化差 \(\Gamma\) 用 \(\delta\) 控制住。需要三样东西:
- 一个位移型的分布距离(\(W_1\))。
- 一条"风险差 \(\le\) 常数 \(\times\) 距离"的不等式(Kantorovich–Rubinstein 的容易方向)。
- 一个把 \(W_1\) 算成 \(\delta\) 的函数的耦合。
两个术语先交代:
- 函数 \(g\) 是 Lipschitz 的,指输出的变化不超过输入变化的固定倍数:\(|g(\mathbf{h})-g(\mathbf{h}')|\le\mathrm{Lip}(g)\,\|\mathbf{h}-\mathbf{h}'\|\)。最小的这个倍数叫 Lipschitz 常数 \(\mathrm{Lip}(g)\),可以当成 \(g\) 的"最大斜率"(例如 \(g(x)=0.5|x|\) 的 Lipschitz 常数是 \(0.5\))。
- Kantorovich–Rubinstein 对偶说 \(W_1(P,Q)=\sup\{\mathbb{E}_Pg-\mathbb{E}_Qg:\mathrm{Lip}(g)\le1\}\)。我们只需要容易证的那一半,即 \(\mathbb{E}_Pg-\mathbb{E}_Qg\le\mathrm{Lip}(g)\,W_1(P,Q)\),证明就是下面命题 4.4 的第三步。
4.5.1 Wasserstein-1 距离:搬沙子#
直觉
有两堆沙 \(P\) 与 \(Q\),总量相同。把 \(P\) 搬成 \(Q\) 的形状,每一铲沙的费用是搬运距离,最省的总费用就是 \(W_1(P,Q)\)。
它与总变差的区别:总变差问"有多少沙不在原处",\(W_1\) 问"这些沙平均被搬了多远"。
定义 4.4(耦合与 Wasserstein-1 距离,有限情形)【已解决(经典)】
\(P,Q\) 是同一有限集 \(\mathcal{Z}\subset\mathbb{R}^d\) 上的分布。一个耦合(coupling)是 \(\mathcal{Z}\times\mathcal{Z}\) 上的联合分布 \(\gamma\),两个边缘分别为 \(P\) 与 \(Q\)("从 \(z\) 处搬 \(\gamma(z,z')\) 这么多沙到 \(z'\)")。
有限情形下这是一个线性规划(运输问题),最小值可取到。
先算两个
取 \(\mathcal{Z}\subset\mathbb{R}\)。下面 \(\delta_a\) 表示"全部质量放在点 \(a\)"的分布(Dirac 点质量),与墙位移 \(\delta\) 只是撞了字母。
- (一)\(P=\delta_0\)(全在 0),\(Q=\tfrac12\delta_0+\tfrac12\delta_1\):唯一的耦合是把一半沙留在 0、一半搬到 1,\(W_1=\tfrac12\times1=0.5\);总变差也是 \(0.5\)。
- (二)\(P=\delta_0\),\(Q=\delta_{0.001}\)(整堆挪了 1 毫米):\(W_1=0.001\),而总变差 \(=1\),它认为两者"完全不同"。
CSI 换环境正是情形(二):每个样本挪了一点,没有一个还在原处。
4.5.2 命题 4.4:两径玩具族的 Lipschitz 风险界#
命题 4.4(两径玩具族的 Lipschitz 风险界)【本站演算】
模型。第一部第 10 章的单反射面参数化玩具族:环境 \(e_\delta\) 由墙的法向位置 \(\delta\) 参数化,\(\delta=0\) 为源环境。终端位置 \(\mathbf{x}\) 按同一分布抽取(两个环境共用),信道 \(\mathbf{h}_\delta(\mathbf{x})=a_0\mathbf{a}_0+a_1e^{-j\phi_1(\delta)}\mathbf{a}_1\),其中 \(\mathbf{a}_0,\mathbf{a}_1\) 为单位模长的阵列响应向量,\(\phi_1(\delta)=\phi_1(0)+\Delta\phi\),\(\Delta\phi=4\pi\delta\cos\theta/\lambda\)(§4.4)。
相位主导近似:反射径的幅度 \(|a_1|\) 与方向 \(\mathbf{a}_1\) 视为不随 \(\delta\) 变。被忽略项的相对大小为 \(2\delta/r_1\sim10^{-3}\)–\(10^{-4}\),见算例 4.5。
\(P_\delta\) 为 \(\mathbf{h}_\delta(\mathbf{x})\) 的分布。模型 \(f\)、损失 \(\ell\),\(g=\ell\circ f\) 对 \(\mathbf{h}\) 是 Lipschitz 的:\(|g(\mathbf{h})-g(\mathbf{h}')|\le\mathrm{Lip}(g)\,\|\mathbf{h}-\mathbf{h}'\|\)。
**(a) 信道向量差的精确值。**对每个 \(\mathbf{x}\),
小 \(\delta\) 时斜率为 \(|a_1|\cdot4\pi\cos\theta/\lambda\);\(\delta=\lambda/(4\cos\theta)\) 时达到最大值 \(2|a_1|\)。
(b) 分布距离。\(W_1(P_0,P_\delta)\le\mathbb{E}_{\mathbf{x}}\|\mathbf{h}_\delta(\mathbf{x})-\mathbf{h}_0(\mathbf{x})\|\)。当 \(\theta\) 与 \(|a_1|\) 不随 \(\mathbf{x}\) 变时右端就是 (a)。
(c) 风险界。
对入射角取最坏(\(\cos\theta\) 遍历 \([0,1]\)),右端的包络为 \(\mathrm{Lip}(g)\cdot2|a_1|\sin\bigl(2\pi\min\{\delta,\lambda/4\}/\lambda\bigr)\)(\(\delta\le\lambda/4\) 时为正弦,之后饱和于 \(2|a_1|\mathrm{Lip}(g)\))。
产权
Kantorovich–Rubinstein 型风险界是标准工具。微分熵、互信息对 \(W_2\) 的 Lipschitz 性也有文献支撑,本章未单列参考文献条目。\(W_2\) 是把搬运费用换成距离平方、最后再开方的 Wasserstein 距离。两径灵敏度是教科书结果。把 Lipschitz 常数与 \(W_1\) 半径用散射体位移标定,据本站检索尚未见显式提出,标【本站演算】。
4.5.3 命题 4.4 的三步证明#
第一步:(a) 是一个复数恒等式。\(\mathbf{h}_\delta-\mathbf{h}_0=a_1e^{-j\phi_1(0)}\bigl(e^{-j\Delta\phi}-1\bigr)\mathbf{a}_1\),取模并用 \(\|\mathbf{a}_1\|=1\):\(\|\mathbf{h}_\delta-\mathbf{h}_0\|=|a_1|\,|e^{-j\Delta\phi}-1|\)。而
第二个等号展开平方并用 \(\cos^2+\sin^2=1\),第三个等号是半角公式 \(1-\cos x=2\sin^2(x/2)\)。
开方即得 (a)。小 \(\delta\) 时 \(\sin u\approx u\) 给出斜率;\(\Delta\phi=\pi\) 时正弦为 1。\(\square\)
**第二步:(b) 用一个显式耦合。**定义 \(\gamma\) 为"抽同一个 \(\mathbf{x}\),把 \(\mathbf{h}_0(\mathbf{x})\) 处的质量搬到 \(\mathbf{h}_\delta(\mathbf{x})\) 处",即 \(\gamma\) 是 \((\mathbf{h}_0(\mathbf{x}),\mathbf{h}_\delta(\mathbf{x}))\) 在 \(\mathbf{x}\) 随机时的联合分布。它的两个边缘分别是 \(P_0\) 与 \(P_\delta\)(因为两个环境用同一个位置分布),所以它是一个合法耦合。
定义 4.4 取最小值,故 \(W_1\le\mathbb{E}_\gamma\|\mathbf{h}_0-\mathbf{h}_\delta\|=\mathbb{E}_{\mathbf{x}}\|\mathbf{h}_\delta(\mathbf{x})-\mathbf{h}_0(\mathbf{x})\|\)。
这一步是全命题的物理内容:源与目标环境不是两堆无关的沙,它们由同一个终端位置连着,"同位置耦合"就是 Maxwell 方程给出的搬运方案。\(\square\)
**第三步:(c) 是 Kantorovich–Rubinstein 的容易方向。**对任意耦合 \(\gamma\),
第二个等号用 \(\gamma\) 的两个边缘恰是 \(P_\delta\) 与 \(P_0\)(期望可以拆成对联合分布的期望),不等号是逐点的 Lipschitz 条件再取期望。
对 \(\gamma\) 取最小得 \(\mathrm{Lip}(g)W_1(P_0,P_\delta)\),再代入 (b)(a)。
关于包络:固定 \(\delta\),\(|\sin(2\pi\delta\cos\theta/\lambda)|\) 对 \(\cos\theta\in[0,1]\) 的最大值在 \(2\pi\delta/\lambda\le\pi/2\) 时取于 \(\cos\theta=1\),为 \(\sin(2\pi\delta/\lambda)\);否则总能取到 1。\(\blacksquare\)
4.5.4 风险界的数值与含义#
算例 4.6(风险界曲线的数值点与一次具体计价)
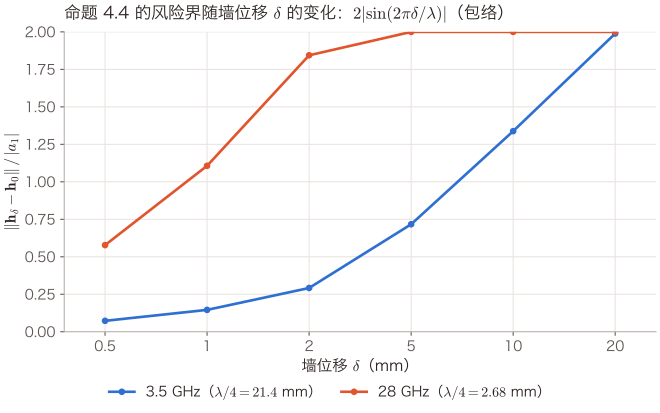
**第一问:曲线。**取 \(\cos\theta=1\),算 \(2|\sin(2\pi\delta/\lambda)|\)(已按包络在 \(\delta>\lambda/4\) 处取 2):
| \(\delta\)(mm) | 0.5 | 1 | 2 | 5 | 10 | 20 |
|---|---|---|---|---|---|---|
| 3.5 GHz(\(\lambda/4=21.4\) mm) | 0.073 | 0.146 | 0.292 | 0.717 | 1.338 | 1.989 |
| 28 GHz(\(\lambda/4=2.68\) mm) | 0.578 | 1.107 | 1.844 | 2 | 2 | 2 |
例如 3.5 GHz、\(\delta=5\) mm:\(2\pi\times5/85.71=0.3665\) rad,\(\sin=0.3583\),乘 2 得 \(0.717\)。28 GHz、\(\delta=2\) mm:\(2\pi\times2/10.71=1.173\) rad,\(\sin=0.9219\),乘 2 得 \(1.844\)。
**第二问:一次计价。**反射系数取 \(|a_1|=0.5\),与第一部第 5 章混凝土 \(|\Gamma|\approx0.45\) 同量级。那里的 \(\Gamma\) 是反射系数,与本章 §4.1 的泛化差不是一回事。
模型损失的 Lipschitz 常数取 \(\mathrm{Lip}(g)=0.5\),即每单位信道范数变化最多改变半个损失单位。命题 4.4(c) 给出
- 3.5 GHz、\(\delta=2\) mm:\(0.5\times2\times0.5\times\sin(0.1466)=0.5\times0.146=\mathbf{0.073}\);
- 28 GHz、\(\delta=2\) mm:\(0.5\times2\times0.5\times0.9219=\mathbf{0.461}\);
- 两个频段、\(\delta\ge\lambda/4\):饱和于 \(0.5\times2\times0.5=\mathbf{0.5}\)(损失在 \([0,1]\) 上的一半)。
同样 2 毫米,3.5 GHz 的泛化差上界是 0.07,28 GHz 是 0.46。两者相差六倍,且后者已接近饱和。
校验
- (a) 小 \(\delta\) 斜率:3.5 GHz、\(\delta=2\) mm 的线性近似 \(4\pi\delta/\lambda=0.2932\),精确值 \(0.2921\),相差 \(0.4\%\)(正弦的三阶项)✓。
- (b) 两频段比例:\(\delta=0.5\) mm 处 \(0.578/0.073=7.9\approx28/3.5=8\),偏差来自 28 GHz 已进入正弦弯曲区 ✓。
- (c) 饱和点:\(\delta=\lambda/4\) 代入 \(2\sin(\pi/2)=2\);3.5 GHz 的 \(\delta=20\) mm 略小于 \(21.4\) mm,故 \(1.989<2\) ✓。
- (d) 与 TV 界对照:TV 界(§4.1)对任何 \(\delta>0\) 都给 \(\|g\|\times1\);命题 4.4 在 \(\delta\to0\) 时给 0,且在 \(\delta\ge\lambda/4\) 处给 \(2|a_1|\mathrm{Lip}(g)\)。两者在"完全翻转"处才会合,之前 \(W_1\) 界严格更好 ✓。
怎么读这张图
- 下方曲线是 3.5 GHz,上方是 28 GHz。纵轴是归一化的信道向量差 \(2|\sin(2\pi\delta/\lambda)|\),乘以 \(|a_1|\mathrm{Lip}(g)\) 就是泛化差的上界。
- 横轴不是等距的(0.5 到 20 mm),请按标签读。
- 28 GHz 曲线在 \(\delta=\lambda/4=2.68\) mm 处触顶饱和,3.5 GHz 要到 21.4 mm。同一条曲线在横轴上按 \(\lambda\) 缩放,这就是"泛化半径 \(\lambda/4\)"的图像。数据来自算例 4.6 第一问。
物理意义
命题 4.4 把 §4.1 的抽象问题落成了一句话:泛化差 \(\le\) 模型的灵敏度 \(\times\) 反射强度 \(\times\) 相位翻转程度。三个因子分属三个环节:
- 模型:\(\mathrm{Lip}(g)\)。
- 环境:\(|a_1|\)。
- 偏移:\(\sin(2\pi\delta/\lambda)\)。
它是第一部第 10 章猜想形态 \(R_{e'}(f)\le R_e(f)+C\cdot d(e,e')\) 的第一个可证实例:\(d(e,e')=\delta\),\(C=\mathrm{Lip}(g)\cdot|a_1|\cdot4\pi\cos\theta/\lambda\)(小位移)。
行为分析
- \(\mathrm{Lip}(g)\) 不是免费的。深度网络的 Lipschitz 常数可以非常大,此时界成立但无用。平滑的模型才有可迁移性,这与谱范数正则、对抗鲁棒性的文献一致,是本章的开放问题 Q4.3。
- \(|a_1|\) 小则界小。LoS 主导(K 因子大)的场景对环境偏移不敏感,这与工程经验一致。
- 饱和值 \(2|a_1|\mathrm{Lip}(g)\) 说明,超过 \(\lambda/4\) 之后再挪也不会更糟,因为相位已经是随机的了。于是"跨城市"(\(\delta\gg\lambda\))与"挪一面墙 3 厘米"对相位相干模型是一回事。而两个户外数据集之间 \(\Gamma\approx0\)(§4.1 的表)就不可能是相位相干模型的行为。这一矛盾在下一节解决。
到此为止我们得到了什么
一条有物理常数的界。
- \(W_1\) 是位移型距离,用"同位置耦合"可以把它算成墙位移的函数。
- 风险差 \(\le\mathrm{Lip}(g)\cdot2|a_1||\sin(2\pi\delta\cos\theta/\lambda)|\),小位移时线性、\(\lambda/4\) 处饱和。
- 3.5 GHz 与 28 GHz 的两条曲线只差一个横轴缩放。
4.6 相位 / 结构二分:泛化半径 \(\lambda/4\) 对 \(L\)#
命题 4.4 只管一种特征:相位。§4.4 的表说还有三种特征几乎不随位移变。把这两件事合起来,就是本章的中心提法。
4.6.1 定义:特征的几何尺度与泛化半径#
直觉
一把尺子的最小刻度决定了它能感知多小的变化。模型通过若干"特征"看环境,每个特征也有它的最小刻度:
- 相位的刻度是 \(\pi\)(翻转)。
- 时延的刻度是 \(1/B\)(系统带宽的倒数)。
- 角度的刻度是波束宽度。
- 幅度的刻度是约 1 dB。
一个特征的泛化半径,就是让它变动一个刻度所需的环境位移。
定义 4.5(特征的几何 Lipschitz 尺度与泛化半径)【本站提法】
设特征 \(\varphi_{\mathrm{feat}}(\mathbf{h})\) 是信道的一个标量函数,\(\Delta_{\mathrm{feat}}\) 是它的分辨单元(该特征变动多少才算"变了")。对环境位移 \(\delta\) 定义几何灵敏度 \(L_{\mathrm{feat}}:=\sup_\theta|\partial\varphi_{\mathrm{feat}}/\partial\delta|\),泛化半径
称只通过 \(\rho_{\mathrm{feat}}\sim\lambda\) 的特征看环境的模型为相位型(phase-coherent),只通过 \(\rho_{\mathrm{feat}}\sim L\)(散射体尺度)的特征看环境的模型为结构型(structural)。
记号提醒:\(L_{\mathrm{feat}}\) 是灵敏度(特征对位移的最大变化率,单位"特征单位 / 米"),不是散射体尺度 \(L\)(单位米),也不是模型的 Lipschitz 常数 \(\mathrm{Lip}(g)\) 或定义 4.2 的泛化损失 \(\mathcal{L}\)。
算例 4.7(四种特征的泛化半径)
用 §4.4 的灵敏度与工程分辨单元(\(r_1=20\) m、64 元 ULA、3.5 GHz 与 28 GHz):
| 特征 | 分辨单元 \(\Delta_{\mathrm{feat}}\) | 灵敏度 \(L_{\mathrm{feat}}\) | 泛化半径 \(\rho_{\mathrm{feat}}\) |
|---|---|---|---|
| 相位 | \(\pi\) | \(4\pi/\lambda\) | \(\lambda/4\):21.4 mm(3.5 GHz)/ 2.68 mm(28 GHz) |
| 时延 | \(1/B\) | \(2/c\) | \(c/(2B)\):1.5 m(\(B=100\) MHz)/ 0.375 m(\(B=400\) MHz) |
| 到达角 | 波束宽 \(0.0277\) rad(\(1.6^\circ\)) | \(2/r_1\) | \(r_1\cdot0.0277/2\):0.28 m |
| 幅度 | 1 dB(相对 \(12.2\%\)) | \(2/r_1\) | \(0.122\,r_1/2\):1.22 m |
时延算式:\(3\times10^{8}/(2\times10^{8})=1.5\) m;角度:\(20\times0.0277/2=0.277\) m;幅度:\(10^{0.05}-1=0.122\),\(0.122\times20/2=1.22\) m。
结论
结构型特征的泛化半径 \(0.3\)–\(1.5\) m,与散射体尺度 \(L\sim1\) m 同量级;相位型特征 \(2.7\)–\(21\) mm。
两者相差十几到数百倍。按表中两端取比值:\(0.28\ \mathrm{m}/21.4\ \mathrm{mm}\approx13\),\(1.5\ \mathrm{m}/2.68\ \mathrm{mm}\approx560\)。而且相位型随载频缩小,结构型与载频无关。
校验
- (a) 时延半径在 \(B=15\) GHz 时为 \(1\) cm,正是算例 4.5 里"\(\delta=1\) cm 需 \(>15\) GHz 带宽才可分辨"的反向陈述 ✓。
- (b) 相位半径与算例 4.5 的 \(\delta_\pi\) 逐位一致 ✓。
- (c) 量纲:每一行都是"无量纲或秒或弧度 ÷(同单位每米)= 米" ✓。
- (d) 与第 3 章算例 3.5 对照:那里假设波束索引在 \(L=1\) m 的区域内分片常值,本表角度行给出 \(0.28\) m、幅度行 \(1.22\) m,\(L\sim1\) m 的假设落在两者之间 ✓。
4.6.2 二分的陈述与它解释的现象#
先用一个两径数字把二分看清楚。看阵列中一根天线上的两径信道 \(h=a_0+a_1e^{-j\phi_1}\),取 \(a_0=1\)、\(|a_1|=0.5\)。
3.5 GHz 下墙挪 \(\lambda/4=21.4\) mm,反射径相位转半圈,\(|h|\) 从同相叠加的 \(1.5\) 变成反相抵消的 \(0.5\),接收功率掉 \(20\log_{10}3=9.5\) dB。
同一次位移里:
- 反射径时延只变 \(2\times0.0214/(3\times10^{8})=143\) ps,是 100 MHz 带宽下一个时延分辨单元(10 ns)的 \(1.4\%\)。
- 到达角变 \(2\times0.0214/20=2.1\) mrad(\(r_1=20\) m),约为 64 元阵波束宽度的 \(1/13\)。
于是,"记住这个位置的窄带接收功率"的模型(相位型)挪两厘米就错 9.5 dB。"记住这个位置该用哪个波束、首径落在哪个时延单元"的模型(结构型)什么都不用改。
关键结论:相位 / 结构二分【本站提法】
模型只有通过尺度远大于环境偏移的特征看环境时才能迁移。
- 相位型模型(相位相干的 CSI 重建、相位级 CSI 预测、相干指纹定位、相位级 CKM):泛化半径 \(\lambda/4\)。3.5 GHz 两厘米,28 GHz 三毫米。家具挪一下、树长一季、换一辆车停在楼下,都超出半径。
- 结构型模型(时延 / 角度 / 功率 / 稀疏度上的波束预测、粗定位、增益图、LoS 判决、以角度–时延域稀疏先验工作的 CSI 压缩):泛化半径 \(\sim L\),米级。同类场景之间的差异(不同城市的两个 UMa 小区)大多小于它。
- 这把第一部第 2 章的 \(\lambda/L\) 从"信道看见什么"翻译成"模型能带走什么":\(\lambda\) 尺度的知识不能带走,\(L\) 尺度的知识能。
产权
据本站检索尚未见"相位 / 结构型泛化半径"被显式提出;措辞不宣称首次。
现在回头解释 §4.1 那条陡坡。
- Nokia ↔ Oppo(两个户外数据集)几乎不掉(\(\pm1\%\)):两侧模型的自编码器学的是角度–时延域的稀疏结构(这是所有 CSI 压缩网络的设计出发点),属结构型。两个 UMa 数据集的结构统计(时延扩展、角度扩展、簇数)接近,偏移小于 \(L\),迁移几乎免费。
- CATT 跨测掉 5%:同为户外、同一套仿真假设,但数据集小(10 万样本),各家仿真实现的细节也可能不同,偏移接近 \(L\)。
- 室内 ↔ 室外崩塌:结构本身变了,室内时延扩展短一个量级、角度扩展大、簇多。偏移远超 \(L\),连结构型模型也失效。这与相位无关,是结构级的 misspecification。
- WiFo 零样本跨载频【预印本·未评审】:在训练集未含的载频上直接推理仍有效。换载频让一切相位都变了(\(\lambda\) 变了),而时延、角度不变。所以能零样本跨载频的模型必然是结构型的,这是二分的正面证据。同一系列的 Tiny-WiFo(5.5M 参数、1.6 ms 推理、保留 \(>98\%\) 性能与零样本能力)说明结构先验可以很小。
- 场景专用小模型一致优于通用模型(Li 等 2026 [16]【预印本·未评审】,QuaDRiGa 仿真、5 m 采样、LoS:通用 \(0.777\) 对场景专用 \(0.915\) SGCS,相对 \(+17.8\%\)):通用模型为了跨场景不得不放弃场景内的相位级结构,专用模型可以用。"场景"的边界该画在哪,就是问泛化半径是多少。按二分,画在 \(L\) 级结构统计相同的范围内。
4.6.3 猜想 4.5:物理泛化界#
猜想 4.5(物理泛化界)【开放·本站原创】
设环境 \(e,e'\) 的差异可以分解到若干几何特征上(散射体位置、取向、材质),模型 \(f\) 的损失 \(g=\ell\circ f\) 对信道 Lipschitz。猜想存在由几何可算的特征级常数 \(L_{\mathrm{feat}}\) 与特征级环境距离 \(d_{\mathrm{feat}}(e,e')\),使
且和式里每一项在 \(d_{\mathrm{feat}}\) 达到该特征的泛化半径 \(\rho_{\mathrm{feat}}\) 时饱和。推论(若成立):相位型模型的泛化半径为 \(\lambda/4\),结构型模型的泛化半径为 \(L\)。
已知的边界
- (甲) 单散射体、单特征(相位)的情形就是命题 4.4,已证。
- (乙) \(W_1\) 界的形式与 Kantorovich–Rubinstein 是标准的。
- (丙) 四种特征的 \(L_{\mathrm{feat}}\) 与 \(\rho_{\mathrm{feat}}\) 在两径模型上可算(算例 4.7)。
未知的边界
- (丁) 多散射体:几十条径同时移动,各径相位差的合成是否仍给出按特征相加的界,还是出现交叉项。
- (戊) 绕射与遮挡:绕射场按 \(\sqrt{\lambda/L}\) 衰减(第一部第 2 章),其贡献能否并入相位项。遮挡是非连续事件(一个行人 \(=21\)–\(30\) dB,第一部第 5 章),不是任何 Lipschitz 界能覆盖的。
- (己) \(\mathrm{Lip}(\ell\circ f)\) 对训练网络是否有限、可估。
- (庚) "特征分解"是否唯一。同一个模型可能既用相位又用结构,此时半径由最敏感的特征决定,还是由损失对各特征的依赖加权决定。
可证伪预测
- 跨载频零样本对时延 / 角度任务可行,对相位级 CSI 重建不可行。
- 同一模型在两个 \(L\) 级统计相同的场景间迁移损失 \(\lesssim\) 数个百分点,在 \(L\) 级统计不同的场景间崩塌。
- 相位型模型在 28 GHz 的泛化半径比 3.5 GHz 小 8 倍。
前两条与 §4.1 表、WiFo、[16] 的报告一致,第三条据本站检索尚无直接实验。
4.6.4 泛化相图#
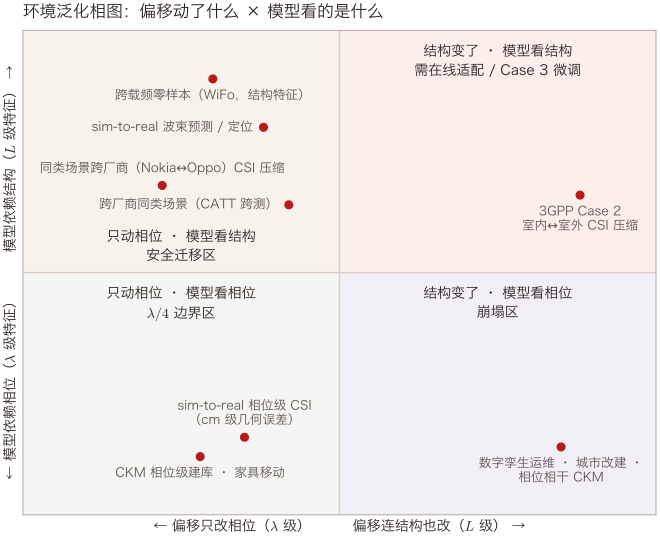
怎么读这张图
- 横轴是偏移触及的层级:左端只改相位(墙挪几厘米、换载频、换季),右端连时延 / 角度 / 簇结构也改(室内到室外、城市改建)。纵轴是模型依赖的层级。
- 对角线是分界:模型的层级高于偏移的层级才能迁移。
- 左上(Q2)安全,右下(Q4)崩塌。左下(Q3)是 \(\lambda/4\) 的边界区,位移小于 \(\lambda/4\) 可迁移、超过就翻转。右上(Q1)结构变了但模型也看结构,需要 Case 3 式微调或在线适配。
- 八个点是本站按 §4.1 表、[16][17] 与 WiFo 报告做的定性定位【本站提法】,不是测量值。
4.6.5 环境度量 \(d(e,e')\) 的候选:哪个能进定理#
猜想 4.5 里的 \(d_{\mathrm{feat}}(e,e')\) 该用什么?第一部提供了三个候选,本章加第四个。
| 候选度量 | 出处 | 可估性 | 物理含义 | 能否进定理 |
|---|---|---|---|---|
| 波数域谱差异 \(\|S_e(\mathbf{k})-S_{e'}(\mathbf{k})\|\) | 第一部第 4 章 | 需密集空间采样或射线追踪 | 哪些空间频率被改变;直接对应角度 / 时延层级 | 能进结构型界:谱差就是 \(d_{\mathrm{feat}}\) 的角度 / 时延分量;对相位盲 |
| 有效维度差 \(\lvert d_{\mathrm{eff}}(e)-d_{\mathrm{eff}}(e')\rvert\) | 第一部第 8 章 | 需 \(\mathrm{D}\Phi\) 的奇异值 | 环境复杂度的差,不含"往哪个方向变" | 不能:是标量;两个完全不同的环境可以有相同的 \(d_{\mathrm{eff}}\)(会议室 \(1.3\times10^{5}\) 对任何同尺寸房间都差不多);只能做必要条件 |
| CKM 差 \(\|m_{T,e}-m_{T,e'}\|\) | 第一部第 7 章 | 建库即得 | 任务泛函 \(T[P(h\mid\mathbf{x})]\) 的差;由地图分辨率 \(r\) 决定看得见什么 | 能进任务限定界(对该 \(T\));但 \(r<\lambda/4\) 的相位级地图本身不可迁移,故只对结构型泛函(CGM、BIM、LoS 图)有效 |
| 散射体位移 \(W_1\)(本章) | 命题 4.4 | 需几何差或可微射线追踪 | Maxwell 传导后的信道差;同位置耦合 | 能:命题 4.4 已证单散射体情形;多散射体为猜想 4.5 |
表的最后一列是本章的判断【本站提法】:能进定理的度量必须是位移型且按特征分层的。波数谱差与 CKM 差各覆盖结构层,\(W_1\) 覆盖相位层并可推广;\(d_{\mathrm{eff}}\) 差因为是标量而只能当必要条件。
到此为止我们得到了什么
本章的中心提法与它的相图。
- 每个特征有一个泛化半径 \(\rho=\Delta/L\):相位 \(\lambda/4\)(毫米到厘米),时延 / 角度 / 幅度 \(0.3\)–\(1.5\) m(\(\sim L\))。模型只有通过半径大于偏移的特征看环境才能迁移。
- 它解释了同类场景免费、跨类场景崩塌、跨载频零样本只对结构型可行。
- 猜想 4.5 把它写成按特征相加的界。单散射体情形已证,多散射体、绕射、遮挡与网络的 Lipschitz 常数是未知边界。
4.7 前沿与方法盘点#
4.7.1 3GPP 泛化测试配置作为分布偏移参数族#
TR 38.843 [14] 为 AI/ML 空口定义了四种泛化测试配置:
- Case 1:训练集与测试集是同一数据集 A 的不相交子集。
- Case 2:训练用 A、测试用 B。
- Case 3:A 上训练后在 B 上微调,再在 B 上测试。
- Case 4:训练用 A 与 B 的子集混合、测试用 B 的不相交子集。
TR 的定性结论:Case 2 要求最高的泛化能力,其次 Case 3。
本站的提法是把它们形式化为分布偏移的参数族【本站提法】:记 \(A,B\) 为两个数据分布,\(\alpha\in[0,1]\) 为训练集中来自 \(A\) 的比例,训练分布 \(D_S=\alpha A+(1-\alpha)B\),测试分布 \(D_T=B\)。则
- Case 1 是 \(A=B\)(\(\alpha\) 任意)。
- Case 2 是 \(\alpha=1\)。
- Case 4 是 \(0<\alpha<1\)。
- Case 3 不在这条轴上。它改的是"目标域样本数"而不是训练分布,是另一根轴。
沿 \(\alpha\) 这根轴,三种偏移度量的行为可以精确写出。
命题 4.6(混合训练集的偏移按混合比例缩小)【本站演算】
\(D_S=\alpha A+(1-\alpha)B\),\(D_T=B\)。则
(a) \(d_{\mathcal{H}\Delta\mathcal{H}}(D_S,D_T)=\alpha\,d_{\mathcal{H}\Delta\mathcal{H}}(A,B)\),且 \(\|D_S-D_T\|_{\mathrm{TV}}=\alpha\|A-B\|_{\mathrm{TV}}\);
(b) \(W_1(D_S,D_T)\le\alpha\,W_1(A,B)\)。
证明
(a) 对任意集合 \(I\),\(\Pr_{D_S}(I)-\Pr_{B}(I)=\alpha\Pr_A(I)+(1-\alpha)\Pr_B(I)-\Pr_B(I)=\alpha\bigl(\Pr_A(I)-\Pr_B(I)\bigr)\)。
这一步只是把混合分布的概率按定义展开。
对 \(I\in\{I(g):g\in\mathcal{H}\Delta\mathcal{H}\}\) 取上确界并乘 2 得第一式;对一切 \(I\) 取上确界得 TV 式。
这里用到的"TV 等于对一切集合的概率差上确界"预备篇没有讲,补一段。记 \(I^+:=\{z:P(z)>Q(z)\}\),任意 \(I\) 上的 \(P(I)-Q(I)\) 都不超过只收正项的 \(\sum_{z\in I^+}(P-Q)\)。又因 \(\sum_z(P-Q)=0\),正项之和与负项之和的绝对值相等,各占 \(\sum_z|P-Q|\) 的一半,故 \(\sup_I|P(I)-Q(I)|=\tfrac12\sum_z|P(z)-Q(z)|=\|P-Q\|_{\mathrm{TV}}\)(半 \(L_1\) 约定,同第 2 章)。§4.3 说的 \(\tfrac12d_{\mathcal{H}\Delta\mathcal{H}}\le\mathrm{TV}\) 也由此而来。\(\square\)
(b) 取 \(\gamma_{AB}\) 为 \((A,B)\) 的最优耦合,\(\gamma_{BB}\) 为"原地不动"的耦合(\(B\) 与自身,费用 0)。混合 \(\gamma:=\alpha\gamma_{AB}+(1-\alpha)\gamma_{BB}\) 的第一边缘是 \(\alpha A+(1-\alpha)B=D_S\),第二边缘是 \(\alpha B+(1-\alpha)B=B=D_T\),故 \(\gamma\) 是 \((D_S,D_T)\) 的耦合。
其费用 \(=\alpha W_1(A,B)+(1-\alpha)\cdot0\)。定义 4.4 取最小值,得 (b)。\(\blacksquare\)
物理意义
Case 4 的偏移正好是 Case 2 的 \(\alpha\) 倍:训练集里混进 \(1-\alpha\) 的目标域数据,就把每一种偏移度量按 \(\alpha\) 缩小。定理 4.3 与命题 4.4 的界随之按 \(\alpha\) 缩小。TR 38.843 的"Case 2 最难、Case 4 居中、Case 1 最易",从定性排序变成了一个比例。
但注意 (a) 对 \(\mathcal{H}\Delta\mathcal{H}\) 是等式:若 \(A,B\) 可分(\(d=2\)),Case 4 的 \(d=2\alpha\),\(\alpha=0.5\) 时界仍给 \(\epsilon_T\le\epsilon_S+0.5+\lambda\),只是半空洞。\(W_1\) 界没有这个毛病。
4.7.2 前沿动态(2024–2026)#
无线基础模型
LLM4CP [15] 用 GPT-2 骨干做上行到下行的 CSI 预测。WiFo 系列【预印本·未评审,arXiv 号本站未取得】用掩码重建自监督在 16 万条异构时空频 CSI 上预训练,报告零样本跨载频推理。
按二分,零样本跨载频只对结构型可行。基础模型注入的是结构先验,它不移动相位型任务的天花板。
3GPP 侧 Gao 等 2026 [17]【预印本·未评审】指出现有研究几乎只做 Case 1。CSI 反馈的室内外互测(Case 2)性能"notably poor",Case 3 明显改善。该文并列出缺公共数据集、缺泛化评测方法论、缺基线模型三项挑战。
可微分射线追踪与 sim-to-real
Sionna RT [13] 可对材料参数、天线方向图、阵列几何、收发位置求梯度,后续工作用梯度标定分区域介电常数与散射系数(数百步 Adam 收敛)。它对本章有两个用处:
- (一)§4.4 的灵敏度表可以用它数值交叉验证,多散射体情形的猜想 4.5 可以用它做数值实验。
- (二)sim-to-real 的偏移可以分层估计:材质误差主要改幅度(第一部第 5 章:单次反射摆动约 4.5 dB),几何误差主要改相位(厘米级误差已超 \(\lambda/4\))。所以射线追踪训练的结构型模型有望迁移到实网,相位型模型几乎不可能,除非几何标定到毫米。
DeepMIMO [10] 这类射线追踪数据集的价值也应按此评估。
Wasserstein DRO
分布鲁棒优化在 \(W_1\) 球 \(\{Q:W_1(Q,P)\le\varrho\}\) 内取最坏,已见于语义通信的抗信道扰动设计。它的老问题是球半径 \(\varrho\) 没有物理含义,只能靠调参。
命题 4.4(b) 给出一个物理标定:\(\varrho:=\mathbb{E}\|\mathbf{h}_\delta-\mathbf{h}_0\|=2|a_1||\sin(2\pi\delta\cos\theta/\lambda)|\),\(\delta\) 取部署环境预期的几何不确定度。据本站检索,"以物理位移标定 Wasserstein 半径"在无线里尚未见到,这是本章留下的一个可直接动手的空位。
从泛化半径到前后端切分
相位 / 结构二分可以直接翻译成一条架构判据【本站提法】:模型里只读时延、角度、功率这类结构级特征的部分,做成跨环境共享的前端;读相位级特征的部分,做成逐站点的后端。这里的前端、后端指模型里的层,不是射频前端。
- 前端的泛化半径在零点几米到一米多(算例 4.7),可以用多站点数据和射线追踪数据训练,基础模型注入的结构先验也落在这一层。
- 后端的半径只有 \(\lambda/4\),挪一件家具就可能越界,只能用本站点的实测来学。
运行期看不见环境偏移(位移 \(\delta\) 或 \(d_{\mathrm{feat}}(e,e')\))本身,看得见的是同一位置上的特征残差 \(|\varphi_{\mathrm{feat}}(\mathbf{h}_\delta(\mathbf{x}))-\varphi_{\mathrm{feat}}(\mathbf{h}_0(\mathbf{x}))|/\Delta_{\mathrm{feat}}\)。其中 \(\mathbf{h}_0(\mathbf{x})\) 取模型在训练环境里为位置 \(\mathbf{x}\) 存下或预测的值,这就是命题 4.4 第二步的同位置耦合。
按定义 4.5,一阶近似下特征的变化不超过 \(L_{\mathrm{feat}}\) 乘位移,所以这个比值一旦到 1,位移至少已有 \(\rho_{\mathrm{feat}}\)。
对前端,这表现为复测链路的首径时延或到达角偏出一个时延单元或一个波束宽度。对后端,表现为信道残差 \(\|\mathbf{h}_\delta(\mathbf{x})-\mathbf{h}_0(\mathbf{x})\|\) 升到饱和值附近(单散射体时是命题 4.4(a) 的 \(2|a_1|\))。
单条链路越界可能只是噪声或定位误差,要看一批复测链路里越界的比例是否持续上升。比值小也只说明测到的链路没变,没测到的链路仍是盲区,这是只用运行期可测量的代价(预备篇 11.5 节)。
4.7.3 方法盘点:各自解决了什么、回答不了什么#
| 方法 | 解决了什么 | 回答不了什么 | 与本章的接口 |
|---|---|---|---|
| 失配译码 / GMI(Csiszár–Narayan [1]、Lapidoth [2]、Scarlett 等 [11]) | 固定译码器下的速率损失可算;高斯尺子对一切噪声给同一答案 | 只对固定译码器;一般失配容量开放 [8][18] | 定义 4.2 |
| 不完美 CSI 速率界(Médard [3]、Lapidoth–Shamai [4]、Hassibi–Hochwald [5]) | 估计误差方差 → 速率损失,闭式 | 只覆盖"信道系数错",不覆盖"环境错" | §4.2 Médard 型下界 |
| 域适应理论(Ben-David [7]、Mansour [6]、Redko [12]) | 假设类相关的可估计界 | 可分域上空洞;无物理;Zhao [9] 给不可能性 | 定理 4.3 |
| PAC-Bayes 域适应(Germain 等 2016,本章未引) | 数据依赖界 | 仍无物理量 | — |
| 可微分射线追踪造数据(Sionna RT [13]、DeepMIMO [10]) | 扩大训练分布;梯度标定材质 | 扩大分布不给保证;标定可辨识性未知 | 猜想 4.5 的数值实验平台 |
| 基础模型预训练(LLM4CP [15]、WiFo) | 注入结构先验;零样本跨载频 | 不移相位型任务的天花板;室内外仍崩 | 二分的正面证据 |
| 场景专用小模型 + learnware 检索(Li 等 [16]) | 目标域一致更优;指纹检索场景 | "场景"边界的定义——正是泛化半径 | 二分的反面证据 |
| Wasserstein DRO | 球内最坏鲁棒 | 球半径无物理含义 | 命题 4.4(b) 给半径 |
| 3GPP LCM 监测与回退 [14] | 掉了就切回去 | 是保险丝,不是定理(第一部第 10 章口径) | Case 1–4 的参数族(命题 4.6) |
表的最后一列是本章的落点。现有方法各有缺口:
- 有定理,但只对固定译码器(GMI)。
- 有界,但看不见物理(DA)。
- 有物理,但不给保证(射线追踪、基础模型)。
- 鲁棒,但半径无意义(DRO)。
它们回答不了的那一块,是环境偏移的物理度量与模型可迁移半径之间的定理。这就是猜想 4.5 的落点,也是本部第 7 章纲领里"物理泛化界"这条定理的内容。
误配与泛化的理论谱系
| 年份 | 工作 | 要点 |
|---|---|---|
| 1981 | Csiszár–Körner 专著 | 类型方法,失配译码的方法论母体 |
| 1995 | Csiszár–Narayan | \(d\)-容量与 CN 猜想 |
| 1996 | Lapidoth | 最近邻译码,高斯最坏噪声 |
| 2000 | Médard | 不完美 CSI 的互信息损失上下界 |
| 2002 | Lapidoth–Shamai | "perfect CSI" 有多 perfect |
| 2003 | Hassibi–Hochwald | 多天线训练开销 |
| 2009 | Mansour–Mohri–Rostamizadeh | discrepancy 距离 |
| 2010 | Ben-David 等 | \(\mathcal{H}\Delta\mathcal{H}\) 界 |
| 2015 | Somekh-Baruch | 失配容量的多字母一般公式 |
| 2019 | Zhao 等 | 域不变表征的不可能性 |
| 2020 | Scarlett 等 | 失配译码专著 |
| 2023 | Sionna RT 与 TR 38.843 | 可微光追;泛化测试 Case 1–4 |
| 2024 | LLM4CP / WiFo | 无线基础模型,零样本跨载频 |
| 2026 | Molina–Guillén i Fàbregas 与本站 | CN 猜想对随机似然译码器成立;相位/结构二分 |
怎么读这张表
- 上段(1981–2003):信息论把"模型错了"计价成速率损失,工具是类型方法与最坏噪声。
- 中段(2009–2020):机器学习用分布距离给"换域"定界,随即发现界在可分域上空洞。
- 下段(2023 起):无线工程用射线追踪、基础模型、标准测试配置以纯经验方式撞上同一堵墙。
- 本站在最后一行:把上段的货币与中段的界形式接到 Maxwell 给出的灵敏度上。
Csiszár–Körner 1981 与 Germain 等 2016 因本站未取得可靠卷期而未列入参考文献。
到此为止我们得到了什么
一个参数族与一张盘点表。
- 3GPP 的四种测试配置沿混合比例 \(\alpha\) 排成一条轴,三种偏移度量都按 \(\alpha\) 缩小(命题 4.6)。
- 基础模型、可微光追、DRO 各有所长,但没有一个给出"偏移多大、模型还灵"的定理。它们缺的就是按特征分层的物理度量,而 DRO 的球半径可以由命题 4.4 直接标定。
跨部连线
- 第三部 3.4 节:学出来的优化器(图神经网络等)同样面临换个环境还灵不灵的问题。
- 第三部第 6 章「战场二」:终端和基站各持模型的一半,不同厂商之间要交换多少比特才能对齐,是第三部的通信复杂度问题。
- 第四部 5.4 节:两个智能体用不同的模型交流,多付的话费是 KL 散度,这是"失配"在多智能体里的样子。
开放问题#
按第一部第 10 章的纲领体裁,每问给精确陈述、已知工具、第一步可证引理与 AI 可攻子问题。
Q4.1(猜想 4.5 的多散射体版本)【开放·本站原创】
- 精确陈述:\(K\) 条径,第 \(p\) 条的散射体位移 \(\delta_p\)、入射角 \(\theta_p\)、幅度 \(a_p\);证明或否证 \(W_1(P_0,P_{\boldsymbol\delta})\le\sum_p2|a_p||\sin(2\pi\delta_p\cos\theta_p/\lambda)|\),并刻画交叉项。
- 已知工具:命题 4.4 的同位置耦合逐径可用,三角不等式给出上式的一个粗版本(各径贡献相加),问题在于它是否远松于真值。
- 第一步可证引理:两条径同时移动时 \(\|\mathbf{h}_{\boldsymbol\delta}-\mathbf{h}_0\|\) 的精确表达式与其对位移方向的最坏情形。
- AI 可攻子问题:在 Sionna RT [13] 里对一个房间随机扰动散射体位置,数值测 \(W_1\)(有限样本的运输 LP)并与逐径界对照。
Q4.2(环境泛化损失 \(\mathcal{L}(e\to e')\) 的估计)【开放·本站提法】
- 精确陈述:只有 \(e'\) 的样本与为 \(e\) 训练的译码器时,如何从数据估计 GMI 与互信息之差;估计量的收敛速率。
- 已知工具:GMI 对固定 \(q\) 是一个期望,可用样本平均估计;\(I\) 的估计是高维难题。
- 第一步:在算例 4.2 的二元设定下给出有限样本的置信区间。
- AI 可攻子问题:对两侧模型的编码器–解码器对,把 \(\mathcal{L}\) 当作跨厂商互操作的判据,与第三部第 6 章的 \(C(\varepsilon)\) 并列测量。
Q4.3(训练网络的 \(\mathrm{Lip}(\ell\circ f)\))【开放·文献共识】
命题 4.4 与猜想 4.5 的常数里有 \(\mathrm{Lip}(\ell\circ f)\),深度网络的 Lipschitz 常数估计本身是开放问题(谱范数乘积上界通常松几个量级)。
- 精确陈述:对 CSI 压缩网络,\(\mathrm{Lip}\) 的可用上界与实测泛化差的比;是否存在使界紧的正则化。
- 第一步:在两径玩具族上训练一个小网络,直接测 \(\Gamma(\delta)\) 曲线并与算例 4.6 的界比较松紧。
Q4.4(一般失配容量)【开放·文献共识】
DMC 加最大度量译码的失配容量至今开放 [1][8][18];CN 猜想只对随机似然译码器被证紧。它对本章的含义:定义 4.2 是"固定架构"的损失,最优架构下的损失未知。
Q4.5(Zhao 不可能性在无线上的形态)【部分结果】
Zhao 等 [9] 的下界用标签边缘的 JS 偏移。
- 精确陈述:对波束预测(标签 = 波束索引),计算 UMa 与 InH 之间 \(d_{\mathrm{JS}}(D_S^Y,D_T^Y)\),给出域不变表示的误差下界数值;它与二分的关系:标签边缘偏移是不是"结构变了"的必要标志。
Q4.6(猜想 1.3 的可加性:\(\rho\) 用哪个)【开放·本站提法】
第 1 章猜想 1.3 要求一个误配半径 \(\rho\) 与亏格相加。本章给出三个候选:TV 型(§4.1,在无线里恒为 1)、GMI 型(定义 4.2,只对固定译码器)、\(W_1\) 型(命题 4.4,需 Lipschitz)。
- 精确陈述:对一条同时含 garbling(量化环 \(\delta\))与 misspecification(环境偏移 \(\delta_{\mathrm{wall}}\))的链,证明或否证 \(r^{\mathrm{act}}_T-r_T(\mathcal{E}_0)\le\|L_T\|\bigl(\sum_k\delta_k+\mathrm{Lip}(g)W_1\bigr)\)。这里 \(\delta\)、\(\delta_k\) 是第 1、2 章的 Le Cam 亏格,\(\delta_{\mathrm{wall}}\) 才是本章意义上的墙位移。
- 第一步:在算例 1.3 的三环链上加一面会挪的墙,数值验证。第 6 章的误差预算会给这条链的 garbling 部分算数。
Q4.7(二分的可证伪实验)【开放·本站原创】
猜想 4.5 的第三条预测,即相位型模型在 28 GHz 的泛化半径比 3.5 GHz 小 8 倍,据本站检索尚无直接实验。
- AI 可攻子问题:用可微射线追踪生成两频段、同几何、墙位移 \(\delta\in[0,30]\) mm 的 CSI 数据集,训练相位级 CSI 重建网络与结构级波束预测网络各一个,测 \(\Gamma(\delta)\) 曲线,检验前者在 \(\lambda/4\) 处饱和、后者在 \(\sim L\) 前平坦。
预告
本章全程把"感知"当作给定的:模型看到什么信道,就迁移或不迁移。
第 5 章把它变成一个动作:探测既花资源又赚信息(对偶控制),认知平衡点由第一部 Q3 曲线的形状决定。而"要不要重新探测"的判据,就是本章的泛化半径:偏移超过 \(\rho_{\mathrm{feat}}\) 就得重新学。
第 6 章把本章的 \(W_1\) 项与第 2 章的亏格接成同一条链上的数值预算;第 7 章把猜想 4.5 列为本部三条定理之一。
参考文献#
- I. Csiszár, P. Narayan, 《Channel capacity for a given decoding metric》, IEEE Trans. Inf. Theory, vol. 41, no. 1, pp. 35–43, 1995. https://doi.org/10.1109/18.370121
- A. Lapidoth, 《Nearest neighbor decoding for additive non-Gaussian noise channels》, IEEE Trans. Inf. Theory, vol. 42, no. 5, pp. 1520–1529, 1996. https://doi.org/10.1109/18.532892
- M. Médard, 《The effect upon channel capacity in wireless communications of perfect and imperfect knowledge of the channel》, IEEE Trans. Inf. Theory, vol. 46, no. 3, pp. 933–946, 2000. https://doi.org/10.1109/18.841172
- A. Lapidoth, S. Shamai (Shitz), 《Fading channels: how perfect need "perfect side information" be?》, IEEE Trans. Inf. Theory, vol. 48, no. 5, pp. 1118–1134, 2002. https://doi.org/10.1109/18.995552
- B. Hassibi, B. M. Hochwald, 《How much training is needed in multiple-antenna wireless links?》, IEEE Trans. Inf. Theory, vol. 49, no. 4, pp. 951–963, 2003. https://doi.org/10.1109/TIT.2003.809594
- Y. Mansour, M. Mohri, A. Rostamizadeh, 《Domain adaptation: Learning bounds and algorithms》, Proc. COLT 2009, 2009. https://arxiv.org/abs/0902.3430
- S. Ben-David, J. Blitzer, K. Crammer, A. Kulesza, F. Pereira, J. W. Vaughan, 《A theory of learning from different domains》, Machine Learning, vol. 79, pp. 151–175, 2010. https://doi.org/10.1007/s10994-009-5152-4
- A. Somekh-Baruch, 《A general formula for the mismatch capacity》, IEEE Trans. Inf. Theory, vol. 61, no. 9, pp. 4554–4568, 2015. https://doi.org/10.1109/TIT.2015.2449831
- H. Zhao, R. T. des Combes, K. Zhang, G. J. Gordon, 《On learning invariant representations for domain adaptation》, Proc. ICML 2019, PMLR vol. 97, 2019. https://arxiv.org/abs/1901.09453
- A. Alkhateeb, 《DeepMIMO: A generic deep learning dataset for millimeter wave and massive MIMO applications》, Proc. ITA Workshop, San Diego, pp. 1–8, 2019. https://arxiv.org/abs/1902.06435
- J. Scarlett, A. Guillén i Fàbregas, A. Somekh-Baruch, A. Martinez, 《Information-theoretic foundations of mismatched decoding》, Foundations and Trends in Communications and Information Theory, vol. 17, no. 2–3, pp. 149–401, 2020. https://doi.org/10.1561/0100000111
- I. Redko, E. Morvant, A. Habrard, M. Sebban, Y. Bennani, 《A survey on domain adaptation theory》, arXiv:2004.11829, 2020. https://arxiv.org/abs/2004.11829
- J. Hoydis, F. A. Aoudia, S. Cammerer, M. Nimier-David, N. Binder, G. Marcus, A. Keller, 《Sionna RT: Differentiable ray tracing for radio propagation modeling》, Proc. IEEE GLOBECOM Workshops, 2023. https://arxiv.org/abs/2303.11103
- 3GPP TR 38.843, 《Study on artificial intelligence (AI)/machine learning (ML) for NR air interface (Release 18)》, V18.0.0, Dec. 2023(另见 V19.0.0, Sep. 2025). https://www.3gpp.org/ftp/Specs/archive/38_series/38.843/ 【本章引用其泛化测试 Case 1–4 的定义与定性结论,以及 V19.0.0 §7.3.2.4 对跨厂商数据集仿真假设的记录;§4.1 表中的 SGCS 数字出自 [19]】
- B. Liu, X. Liu, S. Gao, X. Cheng, L. Yang, 《LLM4CP: Adapting large language models for channel prediction》, J. Commun. Inf. Networks, vol. 9, no. 2, pp. 113–125, 2024. https://doi.org/10.23919/JCIN.2024.10272374
- X. Li, J. Guo, C.-K. Wen, X. Geng, S. Jin, Z.-H. Zhou, 《Learnware for CSI feedback: Scene-specific small models can do big》, arXiv:2608.17760, 2026.【预印本·未评审】 https://arxiv.org/abs/2608.17760
- Y. Gao et al., 《AI/ML for mobile networks: Current status in Rel. 19 and challenges ahead》, arXiv:2603.14317, 2026.【预印本·未评审】 https://arxiv.org/abs/2603.14317
- F. Molina, A. Guillén i Fàbregas, 《Mismatch capacity under stochastic decoding》, arXiv:2604.17964, 2026.【预印本·未评审】 https://arxiv.org/abs/2604.17964
- A. Y. Radwan, F. Syed Muhammad, M. Baker, H. Tabassum, 《Contrastive predictive coding with compression for enhanced channel state feedback in wireless networks》, IEEE Trans. Neural Netw. Learn. Syst., early access, 2026(arXiv:2607.05419). https://doi.org/10.1109/TNNLS.2026.3709216
未单列的备查条目:Csiszár–Körner 1981 专著(类型方法)、Germain 等 2016(PAC-Bayes 域适应)、WiFo 系列原文(零样本跨载频、Tiny-WiFo)——以上因本站未取得可靠卷期或 arXiv 号,正文中只以名称提及、不编号引用;两径像法灵敏度公式为标准教科书结果,未指定版次。